混元开源持久记忆方案,面向长期编程任务
材料称腾讯混元开源 Hy-Memory 2.0,通过模块化持久记忆支持编程代理等长期任务。方案针对持续堆积对话历史导致的上下文退化、成本增长,以及代理遗忘架构决策和重复调试等问题。
完整中文译文
给 AI 编程助手更长的上下文,未必能让它记得更准。原文围绕 Tencent Hunyuan Hy-Memory 2.0 提出另一条路线:把任务进度、代码知识和对话事实分别保存,在需要时取回有效信息,减少反复携带完整历史的开销。
这个方向值得看,但原文的产品宣称、评测结果和代码示例并没有形成完整证据链。读它最有价值的方式,是理解三层记忆如何分工,同时看清哪些数字还不能直接变成采购或接入依据。
三层记忆,分别解决三种遗忘
原文把 Hy-Memory 2.0 描述为 Apache 2.0 许可下的组合:稳定版 SDK hy-memory 2.0.2、提供桌面界面和命令行的 MemHub,以及专门负责提取信息、处理矛盾的 Hy-Memory-30B-A3B。
三层记忆的区别,在于它们回答的问题不同。
Working Memory 回答「现在做到哪一步」。它保存目标、待办、工具输出和中间状态。例如一次重构跑了 50 轮工具调用,下一轮真正需要的可能只是:哪些文件已通过测试、哪里编译失败、接下来修改什么。已经失效的报错,没有必要一直占着上下文。
Code Memory 回答「这个仓库应该怎么改」。按原文描述,它围绕抽象语法树(AST)组织跨文件导入、函数签名、接口类型,以及 diff 和 commit 历史,还保存开发者纠正过的操作经验。比如某个消息库必须通过定制 singleton 异步初始化,这条约束需要关联具体配置文件,后续处理同一 monorepo 时才能准确召回。
Chat Memory 回答「目前哪个事实仍然成立」。原文用 Python 版本举例:周一说生产环境是 Python 3.12,周四说已经迁移到 Python 3.14,系统应保留变更历史,同时让当前环境指向后者,而不是把两条陈述一起塞给模型猜。
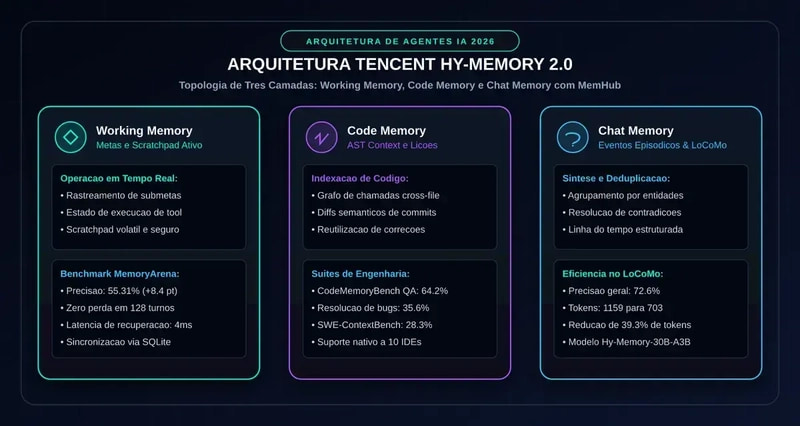
记忆系统的价值,不只是找回旧信息,还包括判断旧信息是否仍然有效。
这也是原文批评基础 RAG 的切入点:向量相似度只能帮助判断内容是否相关,不能单独判断它是否过期。不过,这个问题针对的是缺少时间和状态管理的检索实现,不能据此认定所有 RAG 都无法处理版本变化。
少带 39.3% 的 tokens,能否换来更低成本
原文报告,Hy-Memory 2.0 在最长涉及 100,000 tokens 对话的 LoCoMo 上取得 72.6% 准确率,对照数字为 GPT-6 Astra 的 71.2%、Claude Fable 5.1 的 70.8%,以及 DeepSeek 4.1 的 68.4%。平均每次查询的 tokens 从 1,159 降到 703,减少约 39.3%。
另外两组结果是:MemoryArena 在连续 128 个周期的目标保持测试中得分 55.31%,比连续摘要方案高 8.4 个百分点;CodeMemoryBench 的代码问答或上下文检索准确率为 64.2%,任务解决率为 35.6%。原文对前一个指标的名称表述并不完全一致。
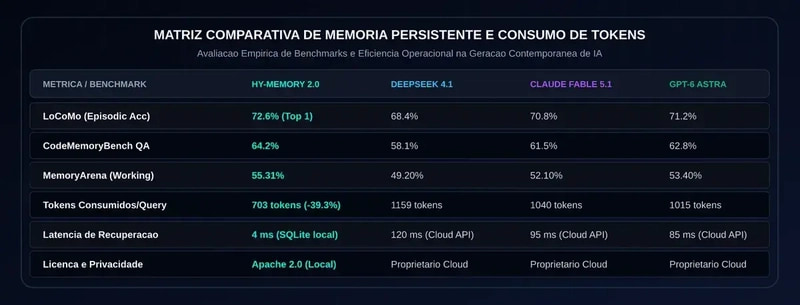
这些是作者报告的评测结果,不是本文复现实测。输入中没有测试脚本、样本划分、完整配置,也没有说明记忆组件与基础模型如何组合比较。因此,72.6% 可以作为待核查的结果记录,暂时不足以支撑「全球领先」的判断。
成本推演也要分开看。原文假设 100 名工程师,每人每天交互 50 次,共 5,000 轮;输入量便从每天约 580 万 tokens 降到约 350 万。按 30 天计算,月减少约 6,840 万 tokens,与文中「超过 6,800 万」基本吻合。
但这是场景计算,并非企业账单实测。它没有计入信息提取、向量计算、索引更新、GPU 和维护费用,也没有展开缓存折扣。减少 39.3% 的这部分输入,不等于总费用下降 39.3%。
原文还把提取、索引和注入描述为低于 5ms,另称 SQLite 取回事实低于 4ms。这两个计时范围没有讲清,不能拿数据库读取延迟代表模型处理和完整检索链路的耗时。
示例代码暴露了哪些接入边界
Hy-Memory-30B-A3B 被描述为稀疏专家混合模型(MoE):总规模约 30B,每次前向计算激活约 3B,并提供 FP8、INT4 权重。MemHub 则被称为可接入 10 个开发环境,支持 Python 和 TypeScript 扩展。
这里要区分计算量和部署门槛。激活 3B 不代表只需存放 3B 权重;原文虽提出双 NVIDIA GPU 或单张高端企业 GPU 的部署方式,却没提供显存、上下文长度和吞吐条件,无法据此判断普通开发机能否顺畅运行。
更直接的问题出在所谓「官方 SDK 完整集成」示例。下面这段实际解决的是建立一个本地 SQLite 表:
async def open_memhub_store(db_path: str = "/tmp/memhub_local.db") -> aiosqlite.Connection:
    conn = await aiosqlite.connect(db_path)
    await conn.execute("PRAGMA journal_mode=WAL;")
    await conn.execute("PRAGMA synchronous=NORMAL;")
    await conn.execute("CREATE TABLE IF NOT EXISTS mem_records (node_id TEXT PRIMARY KEY, stratum TEXT NOT NULL, payload TEXT NOT NULL, info TEXT NOT NULL, logged_at TEXT NOT NULL);")
    await conn.commit()
    return conn
要看的是 aiosqlite.connect(db_path):这里直接打开数据库,没有调用 hy-memory,也没有连接 MemHub daemon 的代码。WAL 和 synchronous=NORMAL 是 SQLite 配置,不能据此证明数据库已加密。
所谓查询对话记忆,对应的实现如下:
async def query_episodic_log(conn: aiosqlite.Connection, top_k: int = 3) -> List[Dict[str, str]]:
    cur = await conn.execute("SELECT node_id, stratum, payload, info, logged_at FROM mem_records ORDER BY logged_at DESC LIMIT ?;", (top_k,))
    rows = await cur.fetchall()
    await cur.close()
    return [{"node_id": r[0], "stratum": r[1], "payload": r[2], "info": r[3], "logged_at": r[4]} for r in rows]
关键是 ORDER BY logged_at DESC LIMIT ?:它只取最近的若干条记录,默认 top_k=3,没有语义查询、层级过滤或矛盾消解。
这份代码能说明如何保存记录,不能证明三层记忆引擎已经接通。
同样,原文声称使用加密 SQLite、HNSW 索引,并且不向第三方发送内部代码,但示例无法验证这些能力。记忆落在本地,与后续推理请求会把什么发出去,也需要分别审查。
我的判断
三层划分有实用价值。任务状态需要频繁更新和失效处理,仓库约束需要关联代码版本,对话事实需要保留时间关系。相比把所有信息写成一段不断增长的摘要,这种设计更方便定位错误来源。
但复杂系统未必适合所有团队。稳定的仓库规范可以先放进明确的项目文档;短期任务可以先保存进度摘要;需要检索的资料也可以采用带时间、来源和状态字段的 RAG。原文没有给出与这些做法的完整对照,关于部署收益和「优越性」的结论仍需打问号。
还有两个边界:较新的陈述可能说的是测试环境,不能自动覆盖生产环境;一次成功修复也未必能升级成整个仓库的永久规则。提取错误会被持续召回,记忆越持久,纠错入口越重要。
原文存在多处重复,输入末尾也已截断。文中模型名称、兼容清单、许可范围和性能数字,本文只能按原文转述,不能当作已经独立确认的产品事实。
能拿来做什么
- 给长期 AI 编程任务分别保存当前进度、仓库约束和环境事实,并记录来源、适用范围及更新时间,先验证这种分工能否减少重复解释。
- 在前端或 Node monorepo 中,把容易反复踩坑的约束关联到具体文件和包;代码变化后重新检查,避免把旧修复当成永久规则。
- 试用记忆组件时,专门测试事实变更:先记录旧运行时版本,再声明指定环境完成迁移,检查召回结果是否区分环境并保留历史。
- 评估接入收益时,同时记录任务完成率、错误召回、输入 tokens 和维护开销;不要仅凭 tokens 降幅判断总成本,也不要把这份 SQLite 示例当作官方接入模板。