Step 5 预览版开放权重,主打长程 Agent
材料称 StepFun 开放 Step 5 Preview 权重,采用总参数 6000 亿、每 token 激活 270 亿的 MoE 架构,支持百万 token 上下文。模型提供 BF16、FP8 和 NVFP4 格式,面向长程 Agent、编码与工具调用任务。
AI 深度解读
StepFun Step 5 Preview 想解决的是一个具体问题:让企业自己部署的开放权重模型,也能承担跨文件分析、连续调用工具和长时间代码修复。原文给出的方案是 600B 总参数、每个 token 激活 27B 参数,再用混合注意力撑起最高 1M tokens 的上下文。
这套设计值得了解,但文章把架构解释、跑分和部署收益混在了一起。读它时要分清:哪些是可理解的工程思路,哪些只是缺少测试条件的性能宣称,哪些示例还不能直接拿去运行。
600B 参数,为什么每次只激活 27B
按原文描述,Step 5 Preview 采用混合专家架构(MoE),权重提供 BF16、FP8 和 NVFP4 三种格式,并在 Hugging Face、ModelScope 发布。
MoE 可以理解为:模型内部有多个专家,每处理一个 token,路由器只挑选部分专家参与计算。600B 表示总容量,27B 表示单个 token 使用的参数规模。
激活参数少,能降低计算量,却不能直接把部署规模按 27B 模型估算。
未参与当前计算的专家权重仍然需要存放,专家之间还涉及通信。原文自己给出的 NVFP4 部署数字,也在约 340 GB 显存这个级别。
另一项设计是「窄而深」:模型堆到 92 层,注意力按 3:1 交替安排。每四层中,三层使用 Gated Sliding Window Attention(Gated SWA),只处理固定窗口附近的信息;一层使用 Gated GQA,通过分组查询注意力连接远距离内容。对应下来,是 69 层局部注意力、23 层全局注意力。
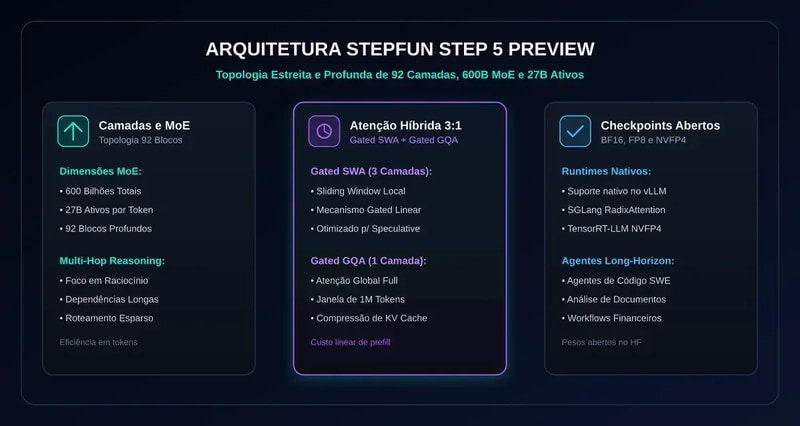
这个取舍容易理解:代码修复需要看当前函数,也需要记住很远处的接口约束。局部层控制计算开销,全局层负责跨距离联系。
但原文把它进一步解释成「保证开头信息始终可用」,就说得太满了。能够访问长距离内容,不等于一定能准确利用;支持 1M tokens,也不等于装入整个仓库后就能稳定完成重构。文章还把 KV Cache 的增长与注意力计算的平方复杂度混在一起,这两件事不能直接等同。
Agent 能否持续工作,要看怎样处理失败
原文对训练方法的描述,比「上下文更长」更贴近日常 AI 编程。
第一步是多 Agent 生成数据。不同 Agent 分别提出假设、在沙箱执行代码、检查结果,在人工规则下构造数十万个工程场景。文章宣称这些数据没有基准污染,但没有提供可供复核的去重方法或审计结果。
第二步是训练完整任务轨迹。普通的下一 token 预测,与真实编程任务之间存在落差:生产环境里,模型需要连续读文件、改代码、运行工具,再根据失败结果继续行动。原文称,训练覆盖了编译器报错和 API 空响应,让模型练习纠错。
第三步是奖励分配。强化学习如果只在最后给「成功或失败」,中间哪些步骤有帮助就很难区分。作者描述的 credit assignment,会给正确假设、排除错误路径等中间决策分配奖励。
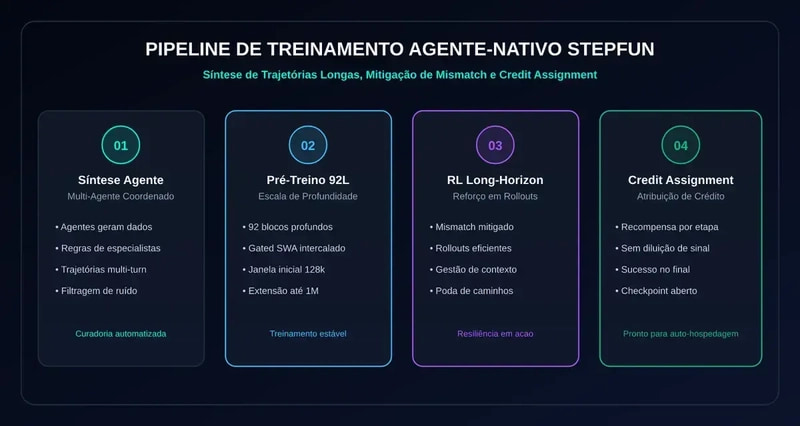
对程序员而言,这部分的启发是:评估 AI 编程工具,应该观察它遇到报错后的下一步,而不只看第一次生成的代码。
原文还给出训练基础设施数据:通过 StepComm 组合 PP=16、TP=8、EP=32,把语义接近的专家放到同一 NVLink 节点,宣称跨 InfiniBand 的激活传输低于 18%,连续 90 天训练的 MFU 达到 48.2%。这些属于作者转述的工程成绩,文章没有给出对照实验,不能据此确定每项优化各贡献了多少收益。
跑分和部署数字,哪些还不能直接照搬
原文列出的成绩包括 SWE-bench Verified 78.2%、AIME 2026 94.1%、AgentBench 87.6%。对比对象包括 DeepSeek 4.1、OpenAI GPT-6 Astra、Claude Fable 5.1 和 Gemini 3.8 Flash Cyber。
其中,SWE-bench Verified 对比数字是 GPT-6 Astra 78.1%、DeepSeek 4.1 77.8%;AgentBench 则低于 Claude Fable 5.1 的 88.1%。
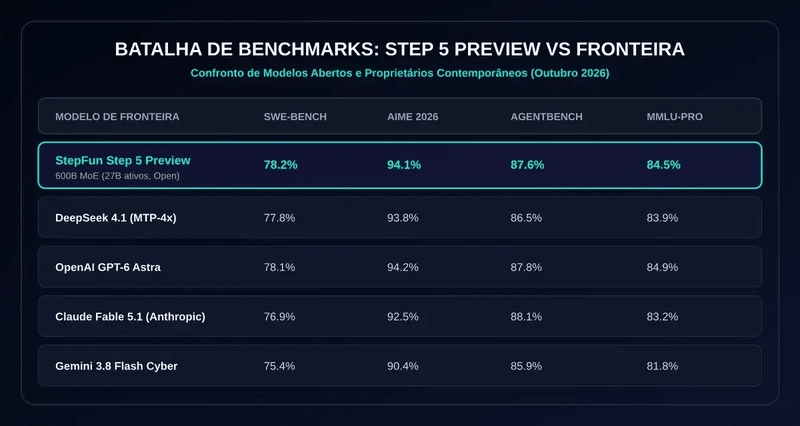
这些只能先作为原文报告的数据。文章虽然宣称评测条件一致,却没有展开 Agent 框架、工具权限、重试次数和推理预算;0.1 个百分点的领先,也不足以证明 92 层设计带来了决定性优势。
EDA 案例同样如此。作者称,模型为加密加速器和 PCIe 6.0 控制器生成 Verilog,在 Yosys 上达到 88.7% 的干净编译率;较浅模型有 42% 的综合结果存在 setup/hold 问题,人工形式验证耗时减少 64%。但通过编译、满足时序、完成形式验证是不同层面的结果,缺少样本规模和流程细节时,不能把它们当成同一项能力。
部署部分更需要核对边界。原文称 vLLM 的 FP8 方案使用 TP=8,在 8 张 80 GB GPU 上处理最高 128k tokens;NVFP4 配合 TensorRT-LLM,约需 340 GB 显存,在四张 Hopper 或 Blackwell 加速器上超过 110 tokens/s。这里没有写清具体卡型和完整显存预算,四张卡能否容纳,不能只看数量。
下面两段原文命令分别解决权重下载和服务启动:
huggingface-cli download stepfun-ai/Step-5-Preview-FP8 --local-dir /data/models/Step-5-Preview-FP8 --local-dir-use-symlinks False
要留意模型标识里的 -FP8,这里下载的是指定精度的权重。
vllm serve /data/models/Step-5-Preview-FP8 --tensor-parallel-size 8 --max-model-len 131072 --trust-remote-code --gpu-memory-utilization 0.92 --port 8000
关键是 --max-model-len 131072:这份配置没有开放 1M 上下文。--trust-remote-code 还涉及执行模型仓库代码,应在确认来源后使用。原文随后用 curl http://localhost:8000/v1/models -H "Authorization: Bearer ***" 检查连通性,但接口可访问不代表推理质量和长上下文容量已经验收。
其他性能宣称也缺少复现实验条件:SGLang 的 RadixAttention 将首 token 时间最多降低 53%;3B 草稿模型的推测解码最多提速 38%;vllm-benchmark-serving 在 64 路并发、Poisson 到达下,报告 256k 上下文配合 4,096 tokens 分块预填充时 TTFT 低于 420 ms。FP8、TP=8、8 张 SXM5 GPU 的聚合吞吐是 1,480 tokens/s,单请求平均约 23 tokens/s。聚合吞吐不能当作个人使用时的生成速度。
我的判断
我认可它把长上下文、工具反馈训练和推理基础设施放在一起讨论。复杂代码任务确实需要整条链路配合,单看参数量很难判断实用性。
但这篇材料的证据不足以支撑「已成为企业自托管新标杆」。文中多处段落重复,提到的完整评测矩阵没有展示,Python 客户端在 main() 内直接截断,末尾关于 Triton、PTX 优化的「72%」也缺失了统计对象。
那个客户端实际展示的是向 /chat/completions 发送 tools,并读取 tool_calls。**返回工具调用,还不等于已经实现完整的 Agent 执行循环。**代码没有展示工具执行与结果回传,仅凭函数定义结构,也无法证实其所谓 MCP 2.0 兼容性。
原文还称 NVFP4 保留了 SWE-bench 准确率的 98.4%,权重显存从 640 GB 降到 338 GB。但参照精度、测试条件和误差分布没有说清,不能自行解释成下降了 1.6 个百分点。
开放权重给了团队更多部署控制权,这点有价值;「每 token 授权成本为零」却需要许可证依据,而且不包含硬件、电力和运维。与闭源 API、较小模型或检索加按需读文件相比,哪条路线更划算,原文没有给出足够对照数据。这些收益目前更适合作为待验证假设。
能拿来做什么
- 评估代码 Agent 时,从自己的前端或 Node 仓库挑选跨文件修复任务,记录最终测试结果、工具调用次数、耗时,以及报错后能否继续纠正。
- 尝试自部署前,先核对权重仓库、许可证、运行时支持版本和具体 GPU 显存,把权重、KV Cache 与运行开销分开估算。
- 接入工具调用时,补齐执行、结果回传、超时和退出条件,不要把
tool_calls返回成功当作任务完成。 - 比较长上下文与仓库检索方案时,使用同一批任务验证完成率和成本,再决定是否需要把大量代码一次塞进上下文。