Mercury 3 用扩散生成挑战推理速度瓶颈
材料称 Inception Labs 发布扩散语言模型 Mercury 3,通过并行去噪生成文本,而非逐 token 自回归生成。文中给出每秒 1068 token 的生成速度及百万 token 输入窗口,但节选未展示独立质量评测。
AI 深度解读
Mercury 3 想解决的是 Agent 工作流里反复等待模型回答的问题。原文称,Inception Labs 用文本扩散替代逐 token 生成,在提供长上下文的同时,将生成速度推到每秒 1,068 tokens,并以较低价格服务浏览器自动化、搜索和实时交互。
这个方向值得程序员关注,但文章的证据还撑不起全部结论:性能测试缺少完整条件,示例代码被截断,部分架构解释也没有出处。读它更适合提炼选型思路,文中的产品规格和排行榜则需要进一步核实。
每秒 1,068 tokens,靠什么摆脱逐字生成
自回归模型(AR)通常从左到右生成,每一步依赖此前的输出。原文认为,这种顺序依赖限制了推理速度:GPU 需要反复读取模型参数,生成过程容易受高带宽显存(HBM)的带宽约束。
文本扩散模型(dLLM)换了一种生成路径。它对一块文本表示反复去噪,在一次迭代中同时调整多个位置。可以把它理解成先铺开一段待完成的文本,再分几轮共同修正,而不是每次只往末尾接一个 token。
并行处理更多位置,有机会提高 GPU 的计算利用率。但它仍需多轮迭代,速度取决于块大小、迭代次数和实现方式。原文对高斯噪声、离散表示扰动、Tensor Cores 利用率的解释,没有提供架构文档支撑,不能直接视为 Mercury 3 已公开的实现细节。
文章称,Mercury 3 的参数总量超过 Mercury 1 的 40 倍,事实与推理测试得分达到其 3 倍,速度仍为 1,068 TPS;相较 Claude Haiku 5.5、GPT-6 Luna 等低延迟模型快 4 至 8 倍。但参数绝对值、测试集和得分均未交代,1,068 TPS 又先后被描述为持续速度、峰值和中位数。
生成更快具有工程价值,但单个 TPS 数字不能证明推理质量同步领先。
上下文方面,原文给出的规格是输入 1,000,000 tokens、输出最多 131,072 tokens,并称相较 Mercury 2.5 的 260,000 tokens 扩大约 4 倍。能装下更多内容,和能准确利用全部内容,是两个需要分别测试的问题。
Agent 真正省下的是哪一段时间
原文最有参考价值的部分,是把速度放进具体工作流。
TinyFish AI 的浏览器测试涉及 DOM 定位、表单理解和点击输入。文章称,Mercury 3 在 50 次 Mind2Web 实时测试中完成了 50.0% 的任务,对照结果为 Claude Opus 5.5 的 48.2%、Gemini 4 Argon 的 46.5%、DeepSeek V4.1 的 44.0%;在 token 数和步骤数相同的情况下,总耗时降到四分之一。
这里有个证据缺口:50 个任务若各跑一次,完成率应以 2 个百分点递增。48.2% 和 46.5% 显然需要其他统计口径,文章没有说明。它们不能直接当成同条件排名。
原文列出的生成速度分别是:DeepSeek V4.1 为 140 至 160 TPS,Gemini 4 Argon 为 110 至 135 TPS,Claude Opus 5.5 为 60 至 75 TPS。没有硬件、并发、输出长度和推理档位,这些数字只能作为文章声称的比较。
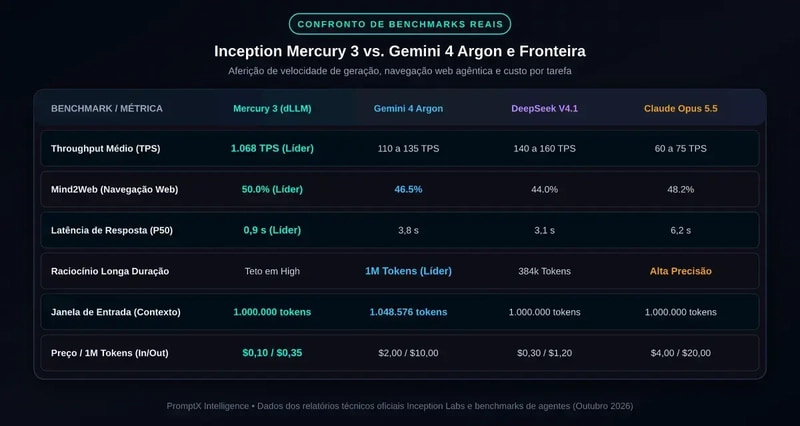
Octen AI 的 Sense API 案例更能说明用户体验:Mercury 3 生成时间中位数为 0.9 秒,端到端为 2.2 秒;DeepSeek V4.1、Gemini 4 Argon、Claude Opus 5.5 的生成时间分别为 3.1、3.8、6.2 秒。RevisionDojo 的教学反馈约需 1 秒,Lorikeet 则报告客服准确率和首次解决率改善,但没有具体数值。
这些是原文转述的合作方结果,并非作者提供复现过程的独立实测。它们共同提示了一件事:模型提速后,检索、页面加载和工具执行仍会占用时间。生成快 4 倍,整个 Agent 未必快 4 倍。
接入参数容易迁移,完整工具循环还得自己补
原文称 API 兼容 OpenAI 的 v1/chat/completions,通过 INCEPTION_API_KEY 鉴权,Python 示例使用 httpx。最值得保留的是请求配置,它展示了如何同时设置流式输出和推理档位:
        payload: Dict[str, Any] = {
            "model": "mercury-3",
            "messages": messages,
            "stream": True,
            "reasoning_effort": effort,
            "temperature": 0.7,
            "max_completion_tokens": 8192,
        }
重点看 reasoning_effort。原文称它控制去噪迭代次数,提供 instant、low、medium、high 四档,对应低于 200ms、约 500ms、900ms 和 1.8 秒;temperature 支持 0.5 至 1.0。这些延迟缺少输入输出长度条件,不能作为服务承诺。
示例还通过 tools、tool_choice="auto" 声明浏览器工具,用 JSON Schema 描述 CSS 选择器和 click、type、scroll、extract 动作。不过声明工具并不等于执行动作,应用仍需拼接流式 tool_calls、执行工具并回传结果。
代码本身也不能直接运行:URL 中的 https\:// 多了反斜杠,末尾停在未完成的 async for event in cli。它只能说明请求结构,不能证明完整兼容性。
成本方面,文章列出的每百万 tokens 首发价格是输入 0.10 美元、输出 0.35 美元,均为常规价 0.20、0.70 美元的五折;缓存读取为 0.01 美元,相对首发输入价便宜 90%。对照价格为 Gemini 4 的 2.00/10.00 美元、Claude Opus 5.5 的 4.00/20.00 美元。
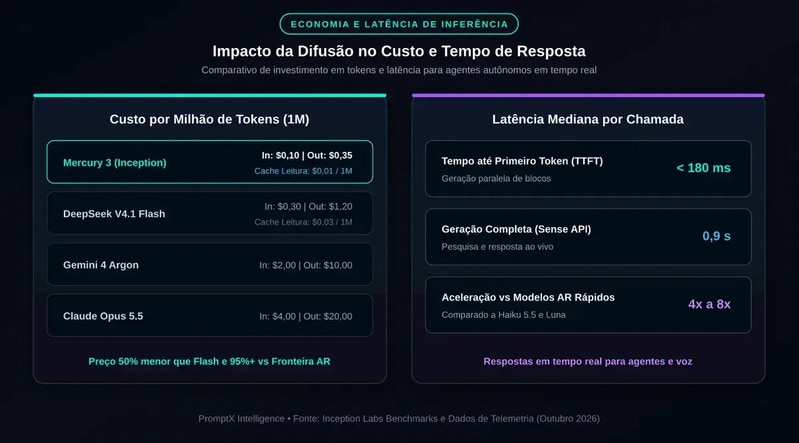
原文据此提出节省 95% 至 98%,但 token 单价还不是任务总成本。缓存命中、重试次数和任务成功率都会影响最终账单。
此外,文章提到 Mercury Voice 响应低于 300ms,支持 LiveKit、Pipecat、Vapi;Mercury Decide 使用 v1/decisions,输入每百万 tokens 0.02 美元、输出免费。后者段落已截断,不能继续补推能力。
我的判断
我认同它强调的选型方向:对需要连续调用工具的应用,等待时间会逐轮累积,低延迟模型值得进入候选名单。
但文章把「扩散路线可扩展」「具体模型速度领先」「足以替代现有模型」连在了一起,证据并不等量。除了测试条件不全,它还重复了大量段落,源码与结尾均有截断。本文只能依据所给材料解读,无法确认其中产品、规格和比较数据。
文章也承认,Gemini 4 Argon、Claude Opus 5.5 在深度推理、跨 50 个关联文件的重构上可能更强。不过,关于 Gemini 4 使用 MCTS、拥有 100 万 tokens 反思缓冲、领先 IMO Bench,以及 DeepSeek V4.1 为 552B MoE 的描述,同样缺乏证据链。不能拿这些说法给架构排座次。
与直接更换模型相比,减少无效轮次、缩短工具返回、复用固定上下文,通常也值得同时评估。文章没有提供这些方案的对照数据,更没有证明 Mercury 3 是所有 Agent 的最佳选择。
是否值得迁移,应由相同任务下的完成率、总耗时和总成本共同决定。
能拿来做什么
- 给现有浏览器 Agent 拆分计时,分别记录模型生成、页面加载和工具执行,再判断生成速度是否真是主要瓶颈。
- 在 Node 或 Python 的模型调用层封装
model、reasoning_effort、输出上限和工具协议,用同一组任务比较四档配置的成功率与耗时。 - 接入流式工具调用前,先验证参数分片拼接、Schema 校验、动作执行和结果回传。原文片段没有完成这些环节,不能直接用于自动操作页面。
- 用实际账单计算每个成功任务的成本,把缓存命中、失败重试和促销结束后的价格一起纳入,再决定是否迁移。