MiniMax M3.1 Flash 主打低成本多步代理
材料称 MiniMax M3.1 Flash 采用 4280 亿总参数、230 亿激活参数的 MoE 架构,支持百万 token 输入,面向软件工程与多步自动化。文中报告其中位生成速度超过每秒 170 token,较 M3 推理提速三倍、单任务平均成本降低约 70%。
AI 深度解读
MiniMax M3.1 Flash 把重点放在了长流程 Agent:当一次需求要经过几十轮工具调用,模型单次回答便宜还不够,整条任务链能否低成本跑完才关键。原文给出的结论是,它用更稀疏的 MoE 架构、统一的长上下文价格和可调推理强度,换取更高的任务吞吐。
对开发者最有用的是两件事:怎样判断这些成本优势能否兑现,以及迁移 API 时哪些旧写法会直接报错。不过,文中的成绩主要来自厂商评测,示例代码也没有形成完整 Agent,不能直接当成生产验证。
便宜的关键,是让几十轮调用一起降价
按原文描述,M3.1 Flash 拥有 428B 总参数,每个 token 约激活 23B,即约 5.3%。MoE(混合专家)可以理解为:模型保留大量专家参数,每一步只选择其中一部分参与计算。
原文将速度提升归因于专家路由、解码调度和注意力稀疏化,报告生成速度中位数 P50 达到 170+ tokens/s,生产峰值超过 200 tokens/s;相对 MiniMax M3,在线推理速度提升至 3 倍,平均任务成本下降约 70%。这些都是原文转述的成绩,没有附独立复测过程。
更容易核算的是价格。官方 API 每百万输入、输出、缓存读取 token 分别收费 $0.15、$0.60、$0.015。输入窗口为 1,000,000 tokens,输出上限为 512,000 tokens,超过 512K 输入不再加价。
旧版 M3 在 512K 以内收 $0.30/$1.20,512K 至 1M 收 $0.60/$2.40。新版既降低基础价格,也取消长上下文阶梯价,适合反复携带文档和工具定义的任务。
原文举了一个缓存例子:100K 固定上下文连续读取 40 次,共 4M tokens,缓存读取费为 $0.06。计算成立,但前提是这些输入实际命中缓存;首次写入、变化部分、输出和工具执行仍有成本。
Agent 应该比较每个成功任务的总成本,而不只是每百万 token 的单价。
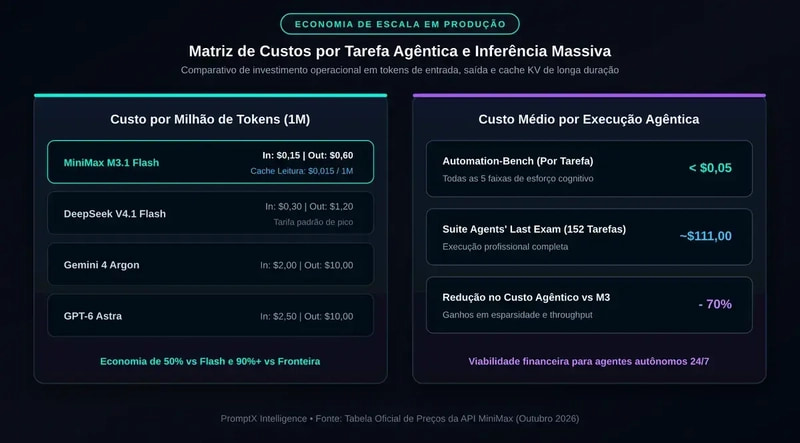
原文称 Automation-Bench 的五档推理成本均低于每任务 $0.05。不过,它没有充分交代失败、重试如何计费。ALE 的 152 项任务总成本写成约「111」,币种符号缺失,也不宜自行补成美元。
能修代码,不代表终端和大重构都强
原文给出的优势集中在企业工具编排。Automation-Bench v1.0.6 汇总成绩为 62.2,最高推理档图表却写成 62.8;BankerToolBench 为 76.2,与 Claude Opus 5.5 持平;LOCA-Bench 256K 为 60.3。
代码方面,M3.1 在 DeepSWE v1.1 得到 73.7%,接近 Gemini 4 Argon 的 75.4%,以及 DeepSeek V4.1 build 1017 的基础成绩 74.2%。后者最高推理档达到 77.0%,因此比较时还要看推理预算是否一致。
短板也很具体:Terminal-Bench 4.0 只有 38.1,Claude Opus 5.5 为 51.8;SWE-Refactor-Bench 为 23.0,对方为 31.0;NL2Repo-Bench 又落后对方 14.1 分。修复已有仓库中的缺陷、操作终端、重构系统、从零搭项目,考的是不同能力,不能共用一个「编程强」标签。
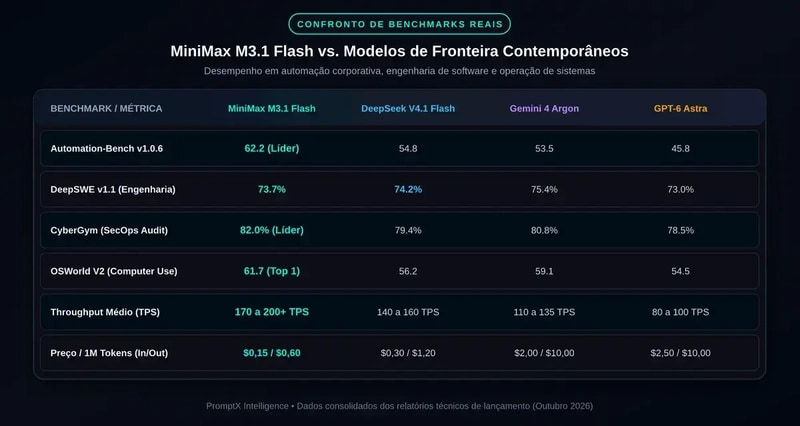
视觉方面,原文称它原生接受文本、图片和视频,输出文本;OSWorld V2 为 61.7,ALE 为 29.6,带工具的 BabyVision 为 91.0%,CharXiv RQ 为 82.5%,不带工具的 HLE 为 43.4%。CyberGym 的成绩为 82.0%,但单项成绩不足以证明所有安全审计场景都可靠。
这些比较还受 harness 影响。它指模型外面的工具、提示、重试和执行环境,同一个模型换套运行框架,结果可能不同。原文中 Kimi K3 的 Automation-Bench 官方卡片在 600 项任务子集上报 30.8,MiniMax 表格却列 46.7,已经说明跨表格排名需要谨慎。
API 迁移先改推理参数,再改流式解析
M3.1 的推理始终开启,reasoning_effort 只调强度,不能关闭。五档分别为 low、medium、high、xhigh、max。
原文建议简单分类用 low,JSON 提取、摘要和 SQL/GraphQL 生成用 medium,代码实现与测试用 high,复杂审计和并发排错用 xhigh,企业自动化及 Computer Use 用 max。这些是用途建议,没有逐项对照实验;max 被称为推荐默认配置,也不等于 API 省略参数时必然如此。
下面这段请求体展示了如何显式选择推理强度:
        payload: Dict[str, Any] = {
            "model": "MiniMax-M3.1-Flash",
            "messages": messages,
            "stream": True,
            "reasoning_effort": effort,
            "temperature": 0.2,
            "max_tokens": 8192,
        }
要关注 reasoning_effort:原文称传入 reasoning_effort="none" 或 thinking.type="disabled" 会返回 HTTP 400。示例的 max_tokens 为 8192,并没有请求模型宣称的最大输出长度。
第二处变化是推理内容独立返回到 reasoning_content,不再依靠正文中的 <think>...</think> 标签解析。示例把流式增量拆成几类:
                        yield {
                            "reasoning_content": delta.get("reasoning_content") or "",
                            "content": delta.get("content") or "",
                            "tool_calls": delta.get("tool_calls"),
                            "finish_reason": choice.get("finish_reason"),
                        }
要关注 reasoning_content 的缺省处理:原文明确说它可能在某些轮次缺失。
这段 Python 使用 httpx,超时为 120.0 秒,通过 MINIMAX_API_KEY 读取密钥。但它只是接收并转交 tool_calls,没有展示参数增量拼接、工具执行和结果回传,末尾工作流也不完整。原文 URL 字符串还写成了 https\://,不能直接照抄运行。
我的判断
我认同它围绕任务成本选模型的方向。一次请求内部可能有 30 至 100 轮状态读取和 API 调用,缓存价格、推理预算、失败重试会一起决定账单。单看输出速度,容易漏掉首个可见 token 的等待时间和工具耗时。
但「成本下降约 70%」还缺少任务分布、成功率和重试策略等条件,无法直接移植到一般团队。全部初始评测主要来自 MiniMax 官方,文中没有提供自己的完整复现实验,也不能据此认定它全面超过其他模型。
自部署部分同样需要保留判断。原文称权重将在 2026 年 10 月 23 日发布;按当前日期,这是计划,不能写成已开放。它估计 MXFP8 权重约 440GB,建议 8×H200 或 8×B200,通过 vLLM、SGLang 的 --tensor-parallel-size 8 部署。
8×H200 的标称显存合计 1,128GB,但扣掉权重后的空间不能全部算作可用 KV Cache,还要留给运行时。8×H100 合计 640GB,也不能仅凭容量就断言必须更强量化或跨节点。缺少并发数、缓存精度和框架支持验证,这部分属于配置估算。
23B 活跃参数可以减少每步计算,却不会让 428B 模型变成小显存模型。
能拿来做什么
- 给已有 Node 或前端 AI 网关增加迁移检查,验证五档
reasoning_effort、HTTP 400 处理、reasoning_content缺失,以及流式tool_calls的拼接与回传。 - 用真实仓库任务比较模型,把缺陷修复、终端操作和大重构分别统计,同时记录通过率、重试次数、总耗时与每个成功任务的费用。
- 对反复携带文档和工具定义的 Agent 先核算缓存命中,再评估 1M 上下文的价值;不要把长窗口容量当作必须填满的目标。
- 根据任务试验推理档位,从分类、结构化提取到代码修改分别测量,确认提高推理强度带来的成功率收益能覆盖额外等待和消耗。