跨语言 Agent 如何通过 ACP 协作
文章以 Python、TypeScript 及不同框架下的代理协作为背景,讨论自定义适配器带来的集成负担。内容介绍 IBM/BeeAI 的 ACP 方案,并结合实例比较 ACP、MCP 与 A2A 的用途。
完整中文译文
Agent 能单独完成任务,不代表接在一起就能协作。Python 后端 Agent、TypeScript 前端 Agent、不同框架的测试 Agent,可能各有一套请求格式和执行方式。作者讨论的 ACP,正是想把这层沟通接口统一起来,让编排器不用逐个适配内部实现。
读这篇最有用的地方,是分清通信协议能管到哪里。另一个会影响选型的信息是:原文聚焦的 IBM/BeeAI Agent Communication Protocol 已汇入 A2A 生态。理解它的设计仍有价值,新项目却不能直接照着旧 ACP SDK 开工。
接口统一了,Agent 才能独立演进
作者举了一个常见组合:研究 Agent 用 Python,报告 Agent 跑在 Node.js 上,可视化 Agent 又是独立服务。它们都能处理「分析月度收入」,但一个接收 query,另一个要求 task_type 和 parameters,第三个需要上传 CSV。
麻烦落在编排器身上:它得翻译请求、等待不同形式的结果,再把错误转换成自己能理解的状态。继续增加五个 Agent,集成层就可能变成另一个需要长期维护的软件产品。
ACP 想统一的是这层交互约定。调用者需要知道对方能做什么、怎样提交任务、怎样读取结果,不必知道它用 Python 还是 TypeScript、LangGraph 还是自建执行引擎、云端模型还是本地模型。
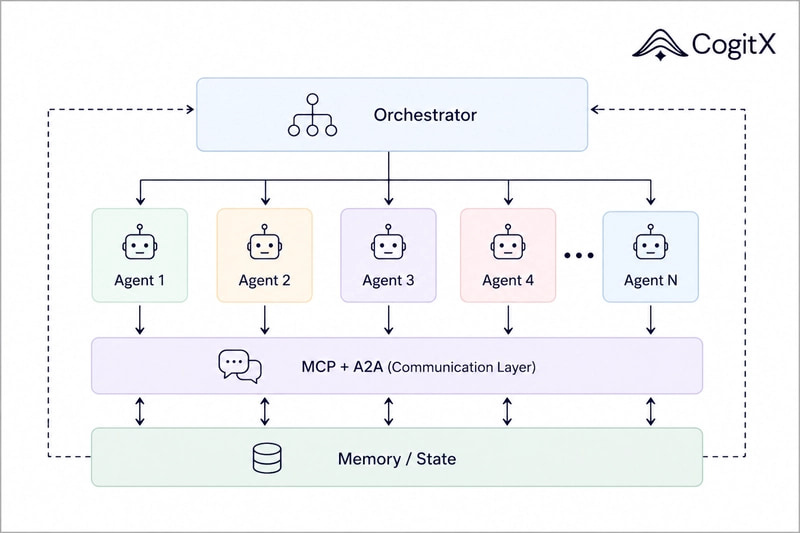
作者用「新增虚拟卡创建功能」说明协作过程:规划器拆出检查现有流程、实现后端接口、开发移动端页面、编写集成测试、检查安全与校验五项任务,再分派给专业 Agent。
后端返回的示例包含 VirtualCardController.cs、CreateVirtualCardRequest.cs、VirtualCardService.cs,以及测试通过 12 项、失败 0 项。编排器还要检查前后端能否对接;测试 Agent 如果发现接口允许缺失持卡人标识,要把问题送回后端修复。
这里没有实测结果,只有应用流程示例。协议统一的是交互方式,任务拆解、验收和返工仍然要靠应用逻辑。
HTTP 解决接入问题,任务生命周期还得设计
原始 IBM/BeeAI ACP 采用 HTTP 原生、面向 REST 的设计,支持同步、异步,以及通过 Server-Sent Events(SSE)传递流式结果,也允许消息携带不同类型的内容。
HTTP 的好处很实际:团队已有的请求调试、网络设施、认证和可观测性工具可以继续使用。
但三种交互适合的任务不同。工单分类可以同步返回,原文示例给出 card_payment 和置信度 0.94;分析包含数百个项目的仓库可能耗时几分钟,更适合先返回任务标识,再查询状态。代码审查则可以用流式输出,让用户逐步看到检查文件、依赖变化、权限风险和测试覆盖情况。
下面的完成记录展示了异步任务怎样关联结果:
{
  "task_id": "repo-analysis-42",
  "status": "completed",
  "result": {
    "services_analyzed": 128,
    "dependencies_found": 46,
    "issues_identified": 7
  }
}
要看的是 task_id:调用方需要靠它关联启动请求、进度和最终结果。原文此前还给出 running 状态及完成 3 项、总计 8 项的进度。128 个服务、46 项依赖、7 个问题都是示例数字,不是性能成绩;这段 JSON 也不是 ACP 的标准报文。
Agent 多了,还会遇到「该找谁」的问题。作者假设组织内有 50 个 Agent,通过描述文件声明名称、能力、输入输出类型,例如 text/plain、application/json。编排器据此找到能分析 HTTP 500 的日志 Agent。
发现机制只负责筛选候选者。能力声明不能证明执行质量,健康检查、权限验证和失败后的替代路径仍要另做。
MCP 和 A2A 管的是两层边界
原文对三者的区分,可以沿着调用链理解:
| 协议 | 原文关注的交互边界 |
|---|---|
| MCP | AI 应用访问工具、资源和提示词 |
| IBM/BeeAI ACP | 独立实现的 Agent 交换请求与结果 |
| A2A | 跨平台 Agent 的发现、协作和任务委派 |
例如,编码助手通过 MCP 访问 GitLab 合并请求、数据库结构、文件系统或内部 API;事故编排器通过 Agent 间协议,把诊断任务交给远程 Agent。远程 Agent 再通过 MCP 的 search_logs 工具查询 Elasticsearch,最后返回结构化发现。
这样,请求诊断的调用方无需了解对方内部接了哪些工具。
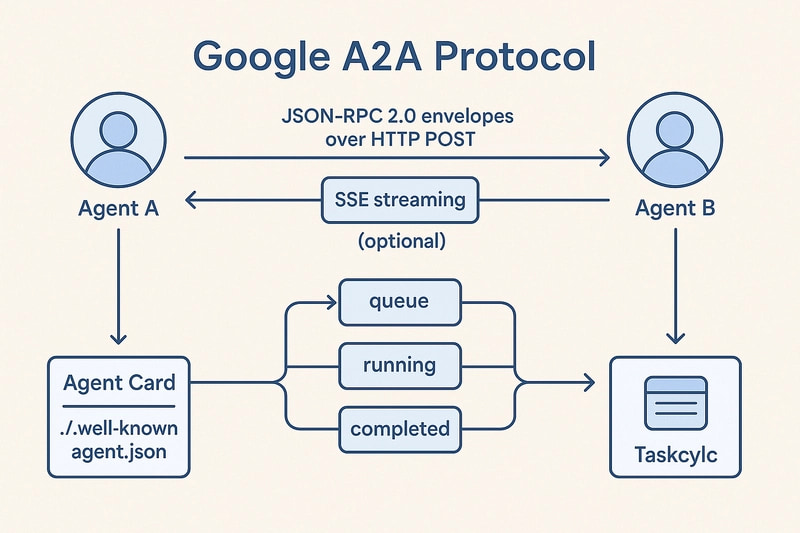
图中包含 JSON-RPC over HTTP、可选 SSE 和任务状态,但原文没有给出具体 A2A 版本、完整字段或状态定义,不能据此直接写出兼容实现。
选型还有一个关键前提:作者转述 IBM Research 项目页的信息,称 ACP 已成为 Linux Foundation 下 A2A 的一部分,并提供迁移指引。因此,原文建议新项目先看当前 A2A 规范和官方迁移文档,检查旧 ACP SDK、端点约定的维护状态,再决定实现。
更容易长期保留的是业务任务模型。把业务逻辑、Agent 能力和传输适配器分开,协议变化时才不必连业务流程一起重写。
我的判断
我认同作者对边界的划分,尤其是把「能通信」和「能可靠协作」分开。
支付失败的例子很有代表性。链路涉及移动端、BFF、授权服务、外部支付提供方、日志和追踪系统。日志 Agent 找到 HTTP 500,API Agent 确认请求到达正确端点,支付 Agent 发现提供方超时,编排器再检查证据是否支持结论。
下面的结构把观察、置信度和下一步建议分开:
{
  "finding": "Payment provider timeout",
  "evidence": [
    {
      "source": "payment-service",
      "observation": "Provider request exceeded the configured timeout"
    },
    {
      "source": "application-logs",
      "observation": "The payment request returned HTTP 500"
    }
  ],
  "confidence": "medium",
  "recommended_next_step": "Check provider availability and retry policy"
}
要注意 evidence:HTTP 500 只能证明请求失败,不能单独证明支付提供方是根因。另一处 0.94 置信度也只是示例,原文没有说明它是否经过校准。
这篇的局限同样明确:没有 ACP 与自定义 HTTP API、固定诊断脚本的对照数据,没有接入成本、延迟、成功率或迁移收益的实测。它提供的是架构思路,不能替团队证明引入多 Agent 一定划算。任务稳定、调用关系固定时,普通工作流也应该进入比较范围。
协议还不会消除领域歧义。两个 Agent 都接收 JSON,仍可能一个把 amount 当主货币单位,另一个当最小货币单位。超时后的重试是否重复执行,需要幂等和任务状态设计;诊断支付失败的权限,也不能自动扩展为发起支付的权限。链路跨越六个 Agent 时,Correlation ID、分布式追踪、结构化日志和审计事件仍然必要。
原文末尾在「Trust and」处截断,后续内容没有提供,不宜替作者补全。
能拿来做什么
- 给现有前端、后端和测试 Agent 先约定任务输入与验收结果,写清文件产物、测试状态、错误和业务字段含义,再评估通信协议,避免只统一 JSON 外形。
- 在 Node.js 编排服务中区分同步、异步和流式任务。仓库分析保留任务标识与可查询状态,代码审查提供增量发现,并明确超时、重试和幂等规则。
- 做日志或故障诊断 Agent 时,把已确认观察、推断和建议分开返回,附上证据来源;按任务开放日志及工具权限。
- 新建跨团队 Agent 集成前,核对 A2A 规范和 ACP 迁移指引,并把协议适配层从业务任务模型中分离,避免业务代码直接依赖旧 SDK 的字段。