
8.0
热点
AI SCORE
技术实践2026-10-09 05:52
MoE架构解析:为何稀疏专家模型统治了2026年大模型
dev.to · AI#MoE#大模型架构#开源模型
Editor brief · 编辑速览
DeepSeek V4.1和 Xiaomi MiMo-V2.6 均采用MoE,解释了其核心机制——稀疏激活节省算力,以及当前局限与修复方向。
两次开源权重发布,相隔 12 天。DeepSeek V4.1 Flash(9 月 10 日):5520 亿参数——每个输入 token 激活约 80 亿,输出 token 激活 160 亿。Xiaomi MiMo-V2.6 Pro(9 月 22 日):1.02 万亿参数,每个 token 仅激活 420 亿。均为 MIT 许可证。均为同尺寸稠密模型十分之一以下的每 token 成本。
这个技巧并不新鲜。它是 2017 年的想法(Shazeer 等人的稀疏门控 MoE,1370 亿参数),悄悄征服了前沿:2026 年实际部署的七个前沿开源权重模型中,六个是混合专家。这就是正在吞噬 scaling 曲线的架构——所以来看它如何运作、在哪里失效,以及 9 月的研究对修复有什么说法。
稠密 transformer 是一家每位医生都接诊每位患者的医院。胸痛?全部 200 名医生进来。扎刺?全部 200 名医生进来。每次都要付所有人的钱。
混合专家模型是一家有分诊护士的医院。每位患者(token)只被分配给与病情相关的 2–8 名专科医生。医院仍然雇佣了 200 名专科医生——这是模型的知识容量——但每位患者只需付少数人的费用。总参数是员工名册。活跃参数是账单。
这就是全部交易:巨大的脑容量,低廉的计算费用。DeepSeek-V3 携带 6710 亿参数但计算量相当于 370 亿模型——知识与开销之间有 18 倍差距。9 月的发布把它推得更远:V4.1 Flash 用约 160 亿计算量运行 5520 亿知识,输出 token 达到 34 倍差距。大脑只有约 3% 醒来。
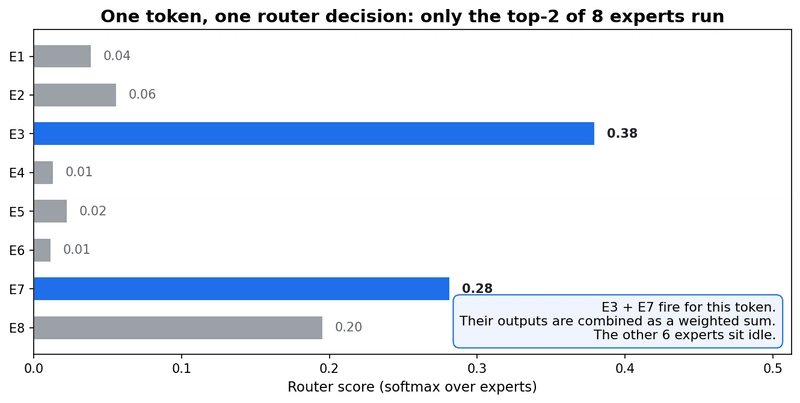
在标准 transformer 块中,前馈网络(FFN)持有大部分参数和大部分计算量。MoE 将单个 FFN 替换为 N 个更小的专家网络加一个路由器(门控网络):
评分。路由器读取 token 并给每个专家打分:scores = softmax(x · W_router)。
选择。只保留 top-k(通常 2–8)。其余对这个 token 处于空闲状态。
合并。每个被选中的专家处理 token;输出使用路由器的分数作为加权求和合并:y = Σ gᵢ · Expertᵢ(x)。
现代变体增加了一个每个 token 都会经过的共享专家(DeepSeek 的设计:256 个路由专家 + 1 个共享专家),它吸收通用知识以便路由专家可以专精。
训练有一个臭名昭著的失败模式:路由器崩溃。放任不管的话,路由器会发现 3 个最喜欢的专家并饿死其余的——61 个专家永远学不到东西。标准修复是辅助负载均衡损失(来自 Switch Transformer):当流量集中时惩罚路由器,L_aux = α · N · Σ fᵢ · Pᵢ,其中 fᵢ 是发送到专家 i 的 token 比例,Pᵢ 是平均路由器概率。这是对偏心的税。
还有营销略过的陷阱:节省的是计算量,不是内存。每个专家必须驻留在 VRAM 中,无论给定 token 是否使用它。DeepSeek-V3 的 6710 亿 FP8 参数需要约 671 GB 权重——一个多 GPU 服务器——即使每个 token 计算量相当于 370 亿模型。MoE 让你用相同的 FLOP 账单买更大的脑,然后给你内存账单。
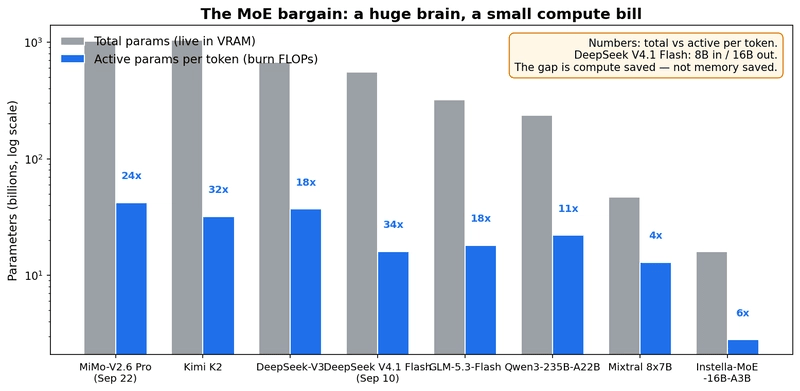
9 月的排行榜。前沿现在是 MoE 单一文化,许可证越来越友好:
AMD 的 Instella 是"完全开放"的异类:在 MI300X/MI325X GPU 上使用开放的 Primus/Miles 框架端到端训练——其 Gated MLA + FarSkip-Collective 设计使训练速度提升 12.7%,首个 token 时间降低 39.2%。(权重带有 ResearchRAIL 非商业限制;训练代码是 MIT。)
定价说明一切:V4.1 Flash 每百万 token 0.15/0.60 美元(低谷期),MiMo-V2.6 Pro 为 0.435/0.87 美元——前沿相近的智能,稠密模型的价格,因为提供商的计算成本由活跃数量决定。
研究前沿正在攻击 MoE 的三个慢性病:
深层是否需要自己的专家? UniPool(arXiv:2605.06665,2026 年 5 月)发现用均匀随机路由替换深层学习的 top-k 路由器,准确率仅下降 1.0–1.6 分——深层路由器大多冗余。其修复:所有层共享一个全局专家池,而不是每层独立的专家集。结果:41.6–66.7% 的专家参数预算持平或超过 vanilla MoE,验证损失改善高达 0.0386。专家容量不再随深度线性增长。
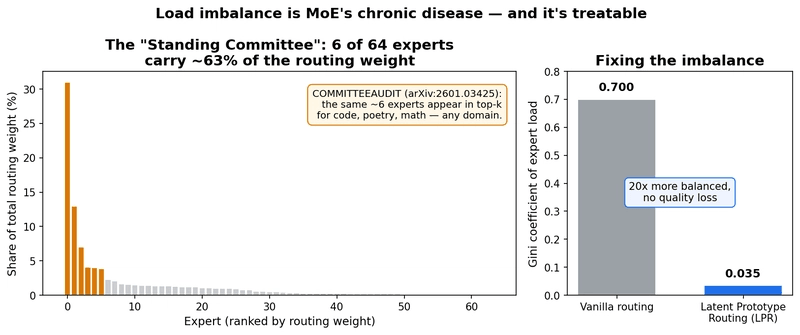
负载不平衡是可修复的。 潜在原型路由将路由重新定义为聚类,将 DeepSeek-V3、Qwen3-MoE 和 Mixtral 的专家负载基尼系数从 0.70 降至 0.035——系统平衡度提升 20 倍,质量无损失。
"常务委员会"。 2026 年一项审计(COMMITTEEAUDIT,arXiv:2601.03425)发现约 6/64 个专家出现在绝大多数 token 的 top-k 中,无论领域——代码、诗歌、数学——承担 60–67% 的总路由权重。专业化是真实的,但一个小型的通才委员会做大部分工作。
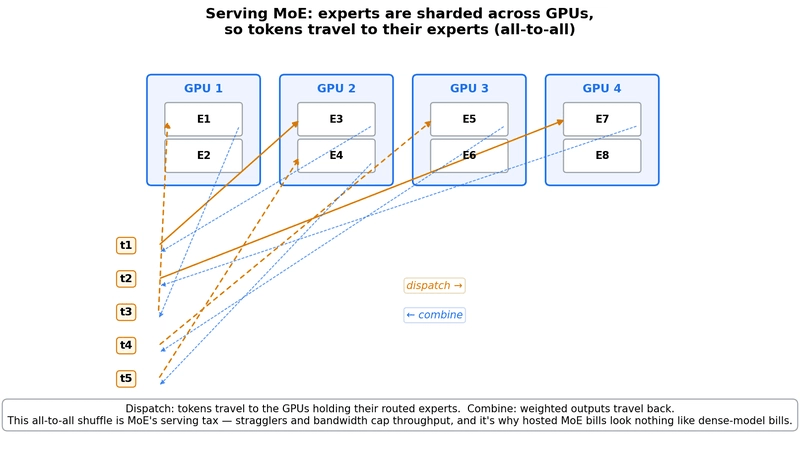
服务税。 由于没有单个 GPU 能容纳所有专家,MoE 服务将它们分片到 GPU 上——专家并行——每个 token 前往持有其专家的 GPU,然后加权输出返回。这整个全-to-全 shuffle 是纯开销:带宽和掉队者限制吞吐量。更糟糕的是,它造成了验证盲点:2026 年 6 月的一项分析("The Expert Shuffle")表明,去中心化提供商可以悄悄将 top-k 从 8 降到 4("k- shunt")而几乎无法被检测到——因为常务委员会在两种运行中都占主导,输出重叠。基于采样的检查无法捕获它;只有中间计算的测量才能做到。
内存不会稀疏化。 为每个参数付 VRAM,为活跃的少数付 FLOPs。5520 亿–1 万亿参数的"开源权重"意味着多 GPU 服务器(V4.1 Flash 的 checkpoint 约 510 GB)。
路由是脆弱的部分。 崩溃、不平衡和常务委员会效应意味着专家数量很大程度上是装饰性的。UniPool 的随机路由结果令人警醒:深层路由器几乎不重要。
服务是分布式系统问题。 全-to-全分发/合并、容量调度、掉队者——MoE 推理工程看起来更像 HPC 而不是运行稠密模型。
验证有漏洞。 去中心化服务中的 k-shunt 目前很难仅从输出检测出来。如果你从第三方购买 MoE 推理,问他们测量了什么。
MoE 将知识与计算解耦。 总参数 = 容量(内存账单);活跃参数 = 每 token 成本(计算账单)。9 月的发布将差距推到 24–34 倍。
路由器就是全部游戏。 Top-k softmax 门控 + 加权和很简单;通过负载均衡损失保持所有专家存活是困难的部分——而 2026 年的研究(LPR、UniPool)正在取胜。
深层专家是冗余的。 UniPool 表明深层随机路由仅损失约 1 分——未来是共享专家池,而不是每层专家农场。
前沿是 MoE 单一文化且 MIT 许可证。 6/7 实际部署的前沿开源权重模型是 MoE,9 月旗舰版发货 MIT 权重。护城河从权重转向了服务。
关注服务层,而不是参数数量。 全-to-全通信和 k-shunt 意味着 2026 年有趣的 MoE 问题在系统和验证,而不是规模。
配套 notebook:moe_mixture_of_experts.ipynb——从头开始在 NumPy 中构建一个微型 MoE 层(路由器、top-2 门控、负载均衡辅助损失),在玩具任务上训练它,观察没有辅助损失时路由器崩溃如何发生、有了辅助损失又如何消失。
来源:DeepSeek V4.1 Flash 发布详情 · MiMo-V2.6 Pro 发布 · GLM-5.3-Flash 模型卡 · The Expert Shuffle: MoE serving's verification problem · The Expert Gap: routing and the verification blind spot · What is Mixture of Experts? (Sep 2026) · UniPool paper wiki · Latent Prototype Routing (LPR) · GPT-OSS-20B deployment analysis · AMD Instella-MoE
配套 notebook:本文的可运行教程——在这里下载(在 Colab/Jupyter 中打开)。