前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9915
  • 长期运行 Agent 的核心不在提示词工程
  • Claude修复全部对齐失败,但2.4%时会作弊
  • Agent 上下文需要完整的开发生命周期管理
  • Agentic Coding实战:任务路由让AI编码账单降低90%
  • DeepSeek V4 首个多模态模型 MIT 开源
  • OpenClaw 2.0 开源 AI 平台:自动识别 API 密钥、支持多人协作
  • OpenAI采购数万台Mac训练计算机操控AI智能体
  • GitHub Copilot VS Code 2026年8月更新:Agent会话管理与变更审查改进
  • Claude Code Opus 5 Auto Mode 被成功破解
  • Crawl4AI v0.9.2:专为LLM设计的开源网页爬虫
  • 模型频繁迭代导致Agent失忆?Uteke给出解法
  • 2026年如何用AI进行智能合约安全审计
  • 千问创作上线Agent Teams,用户说创意Agent分工完成视频制作
  • 循环工程AI Agent:2026软件开发的范式转变
  • GPT-6灰测demo曝光,周四即将正式发布
  • Hugging Face 事件透视:AI Agency 与 Agents 的真实挑战
  • ChatGPT Work 产品解析:云端版与本地版有何不同
  • 日志显示成功实际零交付:生产管道事故复盘
  • 用 Git Worktree 并行跑多个 Coding Agent
  • 语音 Agent 推理延迟基准测试:TTFT 全链路排名
  • Google发布EnvHarness:将静态Agent评测环境转为自适应训练场
  • AI队列事故:175条标记完成但零交付的排查实录
  • 在 PR 合并前用 AI Agent 真实利用漏洞验证安全风险
  • 放弃聊天机器人:Prompt导向编程(POP)架构实践
  • Manrova:持续监控型多Agent系统设计实践
  • Trust Cop:MCP工具漂移检测安全Agent
  • Spline V2:AI Agent可通过MCP协议直接操控3D场景
  • ACAI第20章:RAG知识系统与数据管线的工程实践
  • 检索工程正成为AI Agent时代的关键工程学科
  • Agentic RAG实战:运行时决策替代静态检索管道
  • AI Agent 效果取决于外围工程设计
  • Agent执行环需要护栏而非另一个框架
  • 英伟达Nemotron 3 Nano 30B开源:背后是GPU销售策略
  • 开源安全lint工具VibeGuard:专为AI生成代码设计,检出SQL注入、硬编码密钥等典型问题
  • 我用免费模型做数据库索引审查48小时
  • Need-to-Know:用最小权限原则防止AI数据泄露
  • 改一个base_url接入15个国产大模型
  • 让AI编程助手实时读取运行中服务的API文档
  • 受控自主权:AI Agent软件工程的安全设计模式
  • 防止不稳定API导致AI Agent崩溃:指数退避+熔断+优雅降级
  • exactly-once:保障AI Agent支付等副作用只执行一次
  • 研究:Claude Code和Coze等AI编程助手普遍高估任务耗时10倍
  • PES架构:AI Agent需要两个信任域
  • AI 写不好推销信?问题在检索不在 prompt
  • AI 代码审查应作为质量门禁而非 PR 评论
  • 2026年Legacy Java现代化AI工具实战评测
  • Anthropic悄然降低Claude Code用量上限:纸面提升实为削减
  • ODS:把个人电脑变成私有AI服务器的部署系统
  • awesome-claude-skills:1000+Claude技能与插件精选列表
  • AI Agent评估:每步95%准确率在20步任务中仅36%成功
  • Claude Agent Skills与MCP的本质区别和使用指南
  • 已加载 51 / 9915
8.0
热点
AI SCORE
工具产品2026-08-31 04:23

Google发布EnvHarness:将静态Agent评测环境转为自适应训练场

MarkTechPost#Google#Agent#开源
Editor brief · 编辑速览

Google联合高校发布EnvHarness框架,能将静态Agent评测环境自动适配为动态训练场景,实验显示任务完成率提升9点、执行步骤减少9.8%。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

环境不再教东西

LLM 智能体现在更多地是从交互式环境中学习,而不是从精挑细选的文本中学习。但这些环境是人工构建的、静态的:无论哪个智能体在行动,也无论它改进到了什么程度,环境的行为都完全一致,因此它们无法针对策略的弱点进行训练,一旦任务被解决就没有什么可教的了。

常规的解决方案是生成更多环境。EnvHarness 论文指出了两个代价:生成流水线是领域特定的,无法迁移;而且 LLM 编写的验证器必须过度生成并大量过滤,却始终无法完全可信。

包装,而非编写

研究团队提出了相反的做法。智能体 harness 通过插件工具、记忆和技能让冻结的 LLM 变得能干。EnvHarness 将这一思路应用到循环的另一侧,用插件组件包装冻结的环境,这些组件严格通过标准的 reset() / step() 接口操作。

从形式上讲,一个组件是一个变换 E' = w(E),它重写了状态(state)、动作(action)、观察(observation)和转移(transition)项。奖励(reward)项被故意排除。由于没有任何干预触及模拟器后端,每个重塑后的任务都保留了其原始的人工构建验证器,而且因为没有东西接触基准测试的特定代码,一套实现就能覆盖所有领域。

提供三个组件,它们可以自由组合:

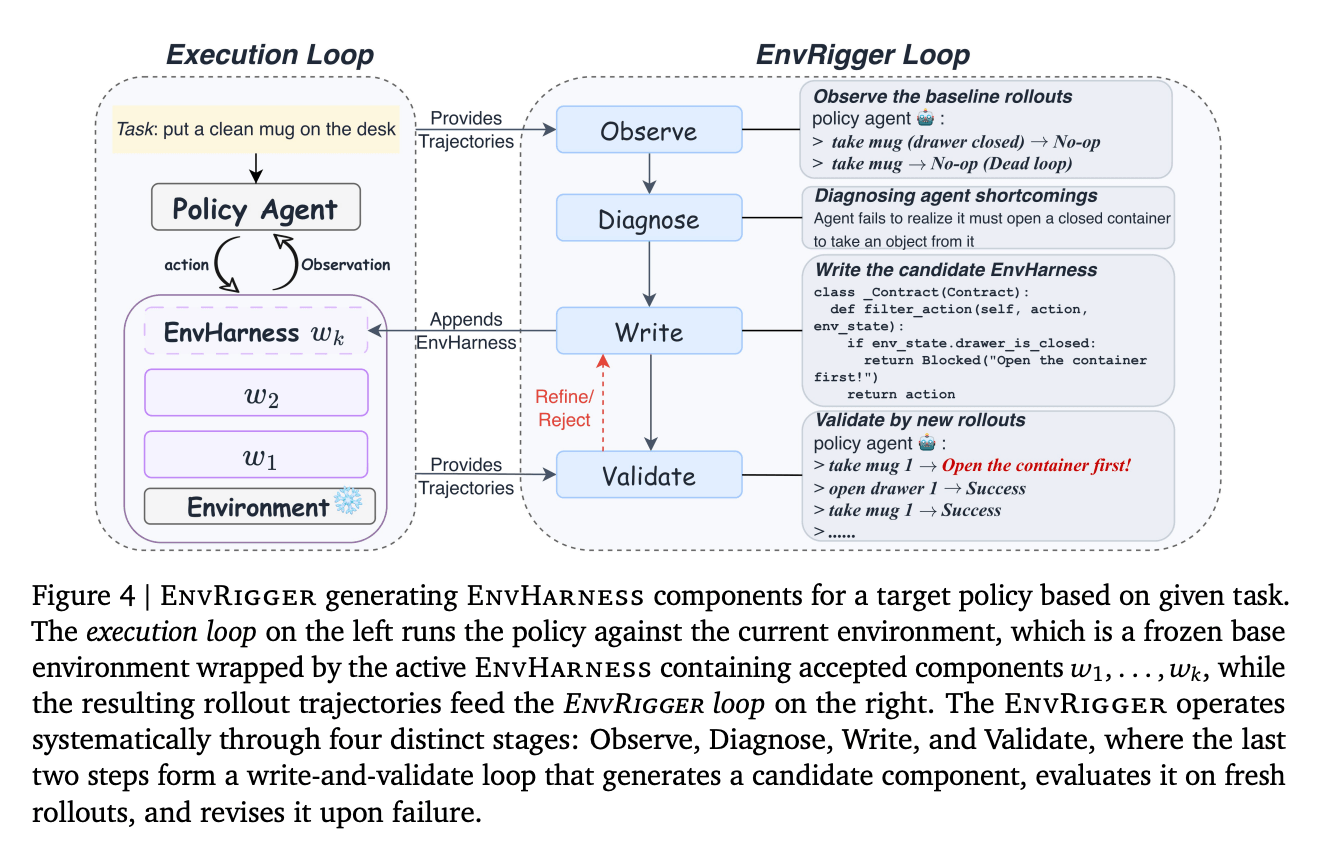
Stage 在 reset() 之后重放一个固定的动作列表,使 episode 从别的地方开始。把目标马克杯藏在关闭的抽屉里,迫使智能体必须搜索而非直接伸手够到。

Contract 在动作、转移和观察轴上安装每步钩子:阻止某个动作、改写某个响应、截断某个观察。

Chain 将第二个环境合成到同一个 episode 中,共享步数预算,复合裁决为两个验证器的合取。

EnvRigger:设计器循环

组件是策略无关的,但选择组件不是。EnvRigger 将策略视为黑盒,运行四个阶段:观察五个基线 rollout、诊断系统性缺陷、将组件写成真实 Python 代码、在五个新的 rollout 上验证。可解决的和 trivial 可解决的候选都会被拒绝,每个任务最多进行五轮修订。生成的钩子在隔离子进程中编译,因此一个糟糕的变异会成为一条记录的轨迹,而不是一次死循环。

在 ALFWorld、WebArena、SWE-bench Verified、OfficeQA 和 SpreadsheetBench 五个基准上,使用 ReasoningBank 风格的归纳挖掘出的技能,在未接触过的保留任务上均超越了两个对照。

ALFWorld 平均得分从 62.4 升至 68.3(相比原始环境技能),在分布外分割上提升 +9.0 分。SWE-bench Verified 解决率从 49.88 移动至 52.58,同时平均步数从 55.01 降至 49.61,这就是论文中 9.8% 效率 claim。在 SpreadsheetBench 和 WebArena 上,未修改环境挖掘出的技能低于无技能基线;重塑才是使挖掘有价值的原因。在领域特定的生成器对比中,EnvHarness 以 2.46 分和 5.11 步的优势击败了 SWE-smith。

在 Qwen3-8B-base 上使用 GRPO,在重塑环境中的 RL 在四个指标中的三个上超越了原始环境中的 RL(ALFWorld 分布内 81.4 → 87.9),在 OOD 分割上有小幅退步(89.6 → 88.8)。环境扩展在 300 个环境时达到 54.79,而原始环境为 52.13,生成环境为 50.37,因为设计器与当前策略协同演化。而在将每个任务的成功率引导至 [0.4, 0.6] 时,带内覆盖率从 6% 升至 80%。
https://arxiv.org/pdf/2608.19880

EnvHarness 仅通过 reset() / step() 包装冻结的环境,因此验证器保持人工构建。

三个组件——Stage、Contract、Chain——分别覆盖起始状态、交互规则和 episode 组合。

EnvRigger 从 rollout 中诊断策略缺陷并编写针对性包装器,在新的 rollout 上验证。

收益在五个基准上均成立:ALFWorld OOD 上 +9.0 分,SWE-bench Verified 上步数减少 9.8%。

Apache-2.0 代码已上线;代价是设计器的 token 消耗以及对可重置环境的硬性要求。

查看论文、GitHub 仓库和项目主页。也欢迎关注我们的 Twitter,别忘了加入我们的 15 万+ ML SubReddit 并订阅我们的通讯。等一下!你用电报吗?现在也可以加入我们了。

需要与我们合作推广你的 GitHub 仓库或 Hugging Face 页面或产品发布或网络研讨会等?请与我们联系。

Asif Razzaq 是 Marktechpost Media Inc. 的首席执行官。作为一位有远见的企业家和工程师,Asif 致力于将人工智能的潜力用于社会公益。他最近的举措是推出了一个人工智能媒体平台 Marktechpost,该平台以其对机器学习和深度学习新闻的深入报道而著称,内容既有技术深度又易于被广泛读者理解。该平台每月浏览量超过 200 万次,彰显了其在大受众中的受欢迎程度。

Original source

本文由 AI 翻译整理自 MarkTechPost,原文版权归原作者所有。

阅读英文原文
上一篇
语音 Agent 推理延迟基准测试:TTFT 全链路排名
下一篇
AI队列事故:175条标记完成但零交付的排查实录