
8.0
热点
AI SCORE
编程提效2026-09-15 16:05
AI编程工具的上下文管理机制对比
dev.to · AI#AI编程#上下文管理#Agent
Editor brief · 编辑速览
深度解析Claude Code、Codex、Pi三家AI编程工具如何处理上下文窗口耗尽:Claude Code生成摘要原地压缩、Codex用Wire Type保留Item身份、Pi用parentId构建树状结构。
每个人最终都会丢失上下文
先从没有争议的部分说起。
这个系列里的每个 harness 都会撞到上限,然后不得不丢弃一些东西。Pi 的规则只有一行,放在 packages/coding-agent/src/core/compaction/compaction.ts 里:
export function shouldCompact(contextTokens, contextWindow, settings) {
    return contextTokens > contextWindow - settings.reserveTokens;
}
这就是全部触发逻辑。判断依据是:当前 token 数是否超过了上限减去预留空间。Claude Code 的流水线是分阶段的,而不是非黑即白的,但压力来源是一样的。
真正有意思的差异不在于什么时候丢弃,而在于丢弃之后还有什么可以寻址。
Claude Code:单位是 transcript
Claude Code 的答案是渐进式压缩。源码泄露时我梳理过五级流水线,设计是自洽的:压力越大,早期的内容被压缩得越狠,最近的对话轮次则保持完整精度。
这里的持久单位是会话本身。状态就是压缩之后幸存下来的那部分。
这有一个实际的优势。压缩是一个全局操作,所以可以用完整的 transcript 做出好的决策,而且系统其他部分完全不需要建模会话结构。transcript 是一个序列,流水线就是这个序列上的一个函数。
它也有一个特定的后果:压缩是不可逆的。一旦一段会话被总结过,它底下的细节就不再可寻址了。你无法回到那个决策之前的状态然后走一条不同的路,因为决策之前的状态已经不存在于任何东西可以加载的形式里了。
Codex:单位是 Item
Codex 做了另一个选择,而且是在协议层做的,这让它变得有意思。参考 2026-09-01 时的 app-server README:
Item: Represents user inputs and agent outputs as part of the turn, persisted and used as the context for future conversations. Example items include user message, agent reasoning, agent message, shell command, file edit, etc.
那份 README 之后已经被完全替换成别的东西了,如果你去找那段文字需要知道这个。类型本身还在,类型定义也还在:ThreadItem 和 thread/fork 在 codex-rs/app-server-protocol/src/protocol/v2/ 里,2026-09-08 再次确认过。文档搬走了,设计没有搬走。
注意这个列表里有什么。Agent reasoning 是一个 item。Shell command 是一个 item。File edit 是一个 item。这些不是 transcript 里的行,它们是有身份的类型对象,嵌套在 Turn 里,Turn 嵌套在 Thread 里,这三者都是 JSON-RPC schema 中的 wire type,服务端可以随时生成 TypeScript 类型或 JSON Schema。
一旦状态可寻址,对状态的操作就变成了 API 调用而不是启发式规则。thread/resume 重新拾起一个会话。thread/fork 用复制过来的历史创建一个新 thread id。ephemeral: true 给到一个内存中的 thread,其路径为 null,所以永远不会落到磁盘上。
thread/fork 值得细看。分支不是强加到 transcript 上的功能,它是 items 有身份的后果。如果你的历史是一列对象,复制一个前缀是微不足道的。如果你的历史是一个压缩过的 blob,那就不可能了。
回想一下 ARC-AGI-3 的结果:在多个轮次之间保留模型的推理过程值 25 分的波动中的大部分。在 Codex 里,agent reasoning 是一个 item 类型。它有地方住,默认会存活下来,而不是靠记得去保留它。
Pi:单位是 node
Pi 从相反的方向到达了同一个地方,只是动静小得多。
会话条目携带一个 nullable 的 parentId,在 session-manager.ts 里。那一个字段就是全部设计。一个列表是一棵树,每个节点恰好只有一个子节点。加一个指针几乎不花什么代价,却买到了整个结构。
Pi 把这个结构当作一等公民而不是实现细节。它的扩展 API 暴露了 session_before_fork、session_before_tree 和 session_tree 作为事件,启动会话携带一个 reason 字段,其值包括 "fork"。扩展在树变化时会收到通知,这只有当树是真实的时候才有意义。
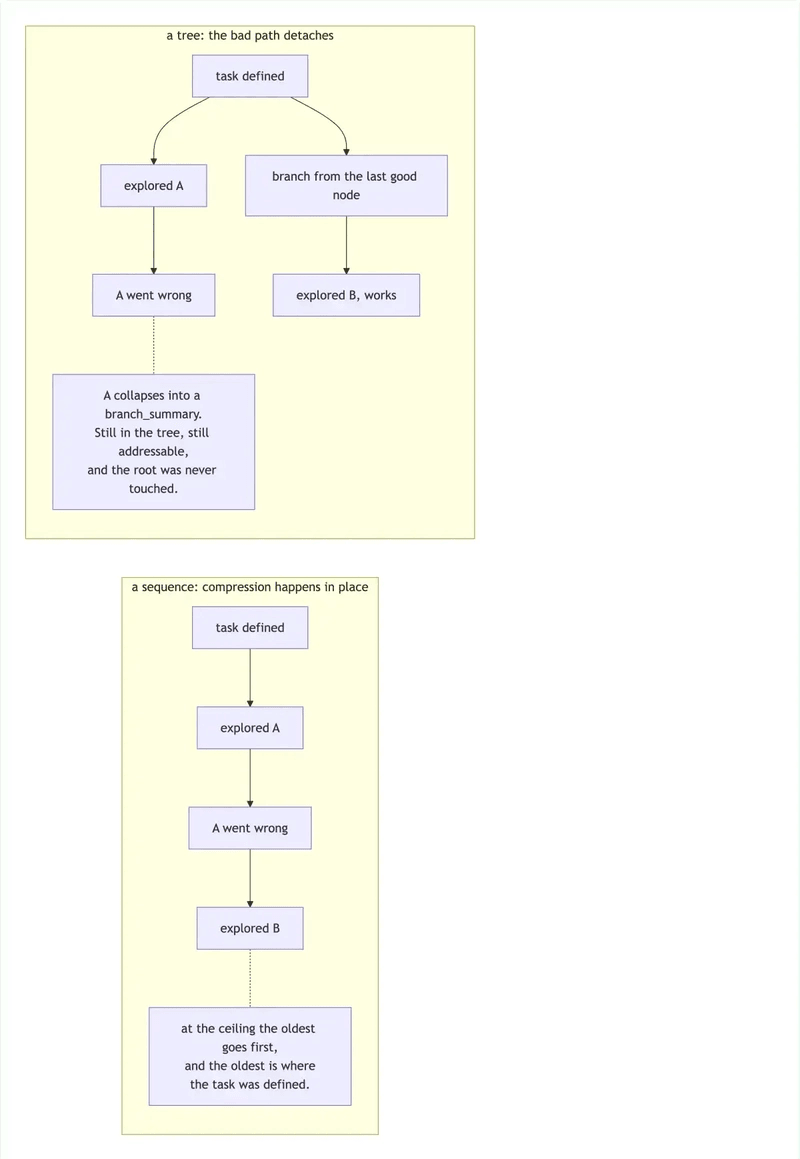
与它并列的还有一个叫 branch_summary 的 entry type,两种思想在那里交汇:当你离开一个分支时,它的内容可以被替换成对它的总结,而分支本身留在树里。你没有删除那条路径。你压缩了其中一条,而你仍然知道它在那里。
Pi 的 compaction 包大约 1550 行,跨四个文件,这是认真做这事的代价。总结预算上限是 0.8 * reserveTokens,所以总结 guaranteed 能放进为它预留的空间里。这是一个小细节,但是个好细节。这是压缩策略和压缩期望之间的差别。
扩展系统依赖的是同一套底层。扩展把自己的状态作为 custom entries 持久化到会话里,这意味着扩展的状态在会话分支时也会分支,不需要额外的机制。
这是今年早些时候提出的 cache coherence 框架,往下了一层。
那里的两个轴是保真度,无损对有损,以及检索,精确对近似。Agent 会话状态坐落在同样的空间里,这三支团队的差异在于有损操作应用在哪里。
Claude Code 把它应用到时间线上。早期材料随着压力增加保真度降低。
Codex 和 Pi 把它应用到分支上。结构保持无损且可寻址,有损压缩发生在节点内部,节点保留自己的身份。
这就是树的意义所在,即使对那些从不输入分支命令的人也是如此。结构给了压缩一个地方放置它的结果而不破坏地址。对一个扁平序列做压缩,除了原地替换被总结的内容,没有地方可以附加总结。
你已经在手动做的事
这里是实践版本,也是我认为这是 agent 系统里最被低估的设计决策的原因。
每个人已经在分支了。当会话跑了四十分钟之后跑偏了,你就开一个新的。这就是从根节点分支,你为此付出的代价是重新建立一切:哪些文件重要,有什么约束,已经排除了什么。
你这么做是因为替代方案——在一个被污染的上下文中继续——更糟糕。不好的探索不会离开。它坐在窗口里,模型持续读到它。
一个会话树把这变成一个廉价操作而不是昂贵操作。回到最后一个一切正常的节点,分支,走一条不同的路。那个节点之前的每样东西都完好无损,因为它从未被压缩掉,因为它有地址。
普遍的错误形式是把探索当作免费的。它不是免费的。它消耗上下文,而上下文是系统里最稀缺的资源。一个不能丢弃坏路径同时不丢弃好前缀的 harness,是在为每一次走错路收取整个会话的费用。
周一要改什么
如果你维护一个 agent,不确定自己建的是哪种,检查三件事。
你的会话记录有 parent 指针吗?如果没有,在需要之前加一个。 retrofit 指针很容易。 retrofit 到六个月存储的会话上就不是了。
当你撞到上限时,你是截断还是压缩?如果你切掉最旧的消息,你是在删除定义任务的那个轮次,现在有一个公开的 25 分结果说明这样做的代价。
模型的推理过程在轮次之间能存活吗?在 Codex 里它是一个 item 类型,所以它默认持久化。在大多数框架里它默认被丢弃,而默认项不在文档里。这是单件价值最高的事情,去检查一下,它通常只是一个字段。
状态单位不是你以后才决定的一个细节。它是决定"以后"还能看到什么的那件事。
Pi 和 Codex 参考在 2026-09-01 那天对照 github.com/earendil-works/pi 和 github.com/openai/codex 的 HEAD 做了测量。Claude Code 流水线细节来自泄露的 bundle 的分析,无法对照发货版本重新验证,那是一个编译过的二进制文件,里面是压缩过的 JavaScript。