
9.0
重磅
AI SCORE
模型发布2026-09-15 11:40
DeepSeek V4.1 Flash:每任务 0.07 美元进入 Agent 帕累托前沿
dev.to · AI#DeepSeek#Agent#性价比
Editor brief · 编辑速览
Agent Arena 中 DeepSeek-V4.1-Flash 以 4.87% 净提升和 0.07 美元中位成本进入性能-成本帕累托前沿,Top 3 开源模型中成本最低。
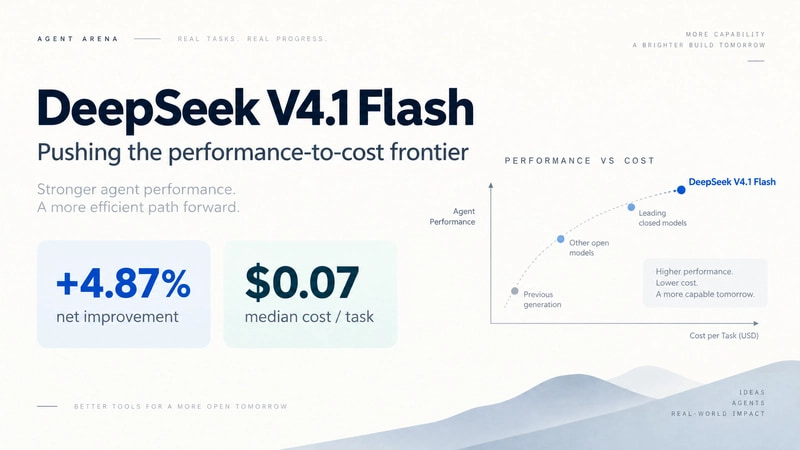
Agent Arena 上发生了一件有趣的事。
DeepSeek-V4.1-Flash(Max)以如下成绩登上了排行榜:
+4.87% 净提升
而其任务成本中位数仅为:
$0.07
根据 Arena 的数据,DeepSeek-V4.1-Flash 由此直接坐落在了 Agent 性能与成本的 Pareto 前沿上。
在 Agent Arena 前三的开源模型中,它目前的中位数任务成本最低。
乍一看,这似乎只是又一个基准测试结果。
但我认为它指向了一个重要得多的趋势:
对于生产级 AI Agent 而言,竞赛不再只关乎谁造出了最聪明的模型,还关乎每花一块钱能完成多少有价值的工作。
首先:"Pareto 前沿"究竟是什么意思?
这个术语听起来很复杂,但道理很简单。
试想用两个维度来比较 AI 模型:
Agent Performance
       ↑
       │                 ● Model A
       │
       │          ● Model B
       │
       │     ● DeepSeek V4.1 Flash
       │
       └──────────────────────────→ Cost
Higher performance
        +
Lower cost
但通常存在权衡。
最强的模型往往也是最贵的。
便宜得多的模型可能表现更差。
当一个模型落在 Pareto 前沿上,意味着不存在另一个选项能同时做到:
更好
AND
更便宜
这就是 DeepSeek-V4.1-Flash 的结果值得关注的原因。
它不只是便宜。
也不只是能力强。
它正在逼近一个节点——其能力与成本的组合让人无法忽视。
每个 Agent 任务 $0.07 这个数字格外醒目
Arena 报告显示,DeepSeek-V4.1-Flash(Max)的中位数成本为:
$0.07
对于聊天机器人来说,模型成本可能已经相当小了。
但 Agent 不同。
一个简单的聊天请求可能涉及:
Prompt
  ↓
Model
  ↓
Answer
而一个 Agent 任务可能长这样:
Goal
 ↓
Plan
 ↓
Search
 ↓
Read files
 ↓
Call tools
 ↓
Analyze results
 ↓
Run commands
 ↓
Encounter error
 ↓
Recover
 ↓
Call more tools
 ↓
Verify
 ↓
Complete task
一次用户请求可能触发多次模型调用。
这意味着 Agent 的经济模型与聊天机器人的经济模型可能截然不同。
一条聊天消息省下几美分可能无关痛痒。
在成千上万甚至数百万个多步骤 Agent 任务中省下真金白银则完全不同。
看看排名前列的开源模型
Arena 的对比让这种权衡变得格外清晰。
在当前结果的时间节点,排名前三的开源模型包括:
DeepSeek V4.1 Flash
这就是有趣的地方。
与 Hy4 Preview 相比:
Hy4 Preview
+4.96%
$0.22 / task

DeepSeek V4.1 Flash
+4.87%
$0.07 / task
在这个 Arena 结果中,性能差异微乎其微。
成本差异则不然。
再与 Kimi K3 Max 相比:
Kimi K3 Max
+6.39%
$0.77 / task

DeepSeek V4.1 Flash
+4.87%
$0.07 / task
DeepSeek 的中位数任务成本低得多。
这并不意味着 DeepSeek 就一定是更好的模型。
它意味着开发者现在面临一个有趣得多的决策。
"最佳模型"与"生产环境最佳模型"是两个不同的问题
假设模型 A 正确完成 95% 的任务。
模型 B 正确完成 92%。
$1.00 / task
$0.07 / task
你应该用哪个?
没有标准答案。
如果你在自动化高价值的金融或工程决策,更高的可靠性可能轻松覆盖额外成本。
但如果你在运行数以百万计的容错空间较大的任务,经济账可能强烈地偏向模型 B。
这就是为什么我认为生产级 AI 需要一种不同的基准思维方式。
不要只问:
哪个模型得分最高?
而要问:
取得可接受结果需要花多少钱?
每 Token 成本还不够
传统上我们比较 API 定价的方式是这样的:
Input: $X / 1M tokens
Output: $Y / 1M tokens
但 Agent 让这个指标越来越不完整。
假设两个编程 Agent。
模型 A 每 Token 费用高,但用五个步骤完成任务。
模型 B 便宜得多,但需要二十步,产生三次错误,并重试了多个工具。
更低的 Token 单价不一定带来更低的单任务成本。
真正重要的指标更接近于:
Model tokens
     +
Tool calls
     +
Retries
     +
Latency
     +
Failures
     +
Human intervention
     ↓
Cost per successful task
这就是为什么我喜欢 Arena 展示每个任务的成本与 Agent 性能并列。
它让基准测试更接近开发者实际思考生产系统的方式。
DeepSeek V4.1 Flash 为什么有趣
"Flash"这个名字已经暗示了方向。
这不一定是为在任何成本下赢得所有基准而设计的模型。
它瞄准的是曲线上一个不同的点:
足够强的智能,远更好的效率。
DeepSeek 在 V4.1 Flash 上强调了若干目标:
Higher capability
Faster inference
Higher throughput
Lower cost
Native multimodal understanding
Agent workloads
而这种组合越来越重要。
因为大多数生产级工作负载并不需要对每个请求都调用最大智能。
你可能不应该把所有请求都发给最强模型
想象一个处理以下请求的企业 AI 系统:
Classify an email

Extract data from an invoice

Summarize a document

Analyze an image

Fix a coding issue

Perform financial research

Operate a browser

Complete a long-running agent workflow
每个请求真的都需要最贵的前沿模型吗?
更好的架构可能是:
Incoming Task
      ↓
Classify Difficulty
      ↓
┌───────────┬────────────┬───────────────┐
↓           ↓            ↓
Simple     Medium       Difficult
↓           ↓            ↓
Flash      Strong       Frontier
Model      Model        Model
这就是像 DeepSeek-V4.1-Flash 这样的模型变得格外有趣的地方。
Flash 模型不一定需要打败最贵的前沿模型。
它只需要对很大比例的工作负载足够好用,同时成本低得多。
Agent 路由可以进一步推动这一趋势
我们甚至可以让这个过程动态化。
先用较低成本的模型:
Request
   ↓
DeepSeek V4.1 Flash
   ↓
Can it complete the task?
   ↓
 ┌───────┴───────┐
 ↓               ↓
Yes              No
 ↓               ↓
Done        Stronger Model
                 ↓
              Complete
这样昂贵模型就成了升级路径,而不是默认选项。
对于企业级 AI,这可以完全改变经济账。
不用再为 100% 的请求支付前沿模型价格,也许只有 10% 或 20% 需要升级。
其余工作负载可以运行在高效模型上。
不同工作负载,不同模型
这让我回到最近一直在思考的事情:
可能不会有一个"最佳 AI 模型"。
DeepSeek 可能在某些成本敏感的 Agent 工作负载上胜出。
Claude 在某些软件工程任务上可能更好。
GPT 在某些极困难的 Agent 工作负载上可能有意义。
Gemini 可能在某些多模态应用上更合适。
Hy4 在另一类长周期任务上可能表现更好。
Qwen 或 GLM 可能在其他地方胜出。
答案会不断变化。
而这实际上对开发者是好事。
模型市场正在变得足够有竞争力,我们可以围绕工作负载而非品牌来优化。
每美元性能可能成为一个核心 AI 指标
多年来,AI 模型比较一直严重关注:
Benchmark Score
后来我们开始更多关注:
Latency
Context Window
Token Price
我认为 Agent 系统正在加入另一个重要指标:
每美元完成的有价值工作。
或者更具体地说:
每美元完成的成功任务数。
这个指标捕捉到了更接近实际业务价值的东西。
模型创造价值不是因为生成了 10,000 个 Token。
它创造价值是因为完成了有用的东西。
Fixing a bug

Researching a company

Processing an invoice

Generating a report

Completing a browser workflow

Resolving a customer request
评估越接近这些成果,就越有价值。
这也是我们在做 ApiHub 的原因
DeepSeek-V4.1-Flash 这类模型的快速进步强化了 ApiHub 的核心思想之一:
不同工作负载,不同模型。统一 API。
ApiHub 不是让你永远围绕一个 AI 提供商构建应用,而是通过统一的开发者体验让你更轻松地访问和实验多个模型家族。
你可以用过熟悉的 API 格式集成:
OpenAI-compatible API
Responses API
Messages API
DeepSeek-V4.1-Flash 已在 ApiHub 上可用。
如果你想看看这些 Arena 结果是否适用于你自己的工作负载,可以用 ApiHub 上的免费积分自己测试。
不要只问几个聊天问题。
用它跑:
Coding

Tool use

Long-running agents

Research

Multistep workflows

Real application workloads
然后与你已经在用的模型比较。
因为最重要的基准不一定是 Arena 的。
DeepSeek-V4.1-Flash 落在 Agent Arena Pareto 前沿上很有意思。
但我认为更大的故事是市场的方向。
谁有最聪明的模型?
谁能以合适的成本提供足够的智能?
对于我的工作负载,哪个模型能以最低成本完成最多成功任务?
这是截然不同的问题。
对于构建 AI 产品的开发者来说,这可能是好事。
更多竞争给我们更多选择。
而更多选择让模型路由、对比和多模型架构更有价值。
DeepSeek-V4.1-Flash 每个任务中位数成本 $0.07 再次提醒我们,AI 模型竞赛不再只关于推进智能前沿。
还在于推进效率前沿。
在生产级 Agent 中你会优化什么?
最大能力、最低成本,还是最佳性能成本比?
如果你已经在真实 Agent 工作流上测试过 DeepSeek-V4.1-Flash,我很想知道它的表现。
Disclosure: I'm building ApiHub, a unified AI API platform designed to make it easier for developers to access, test, compare, and switch between different AI models.