
8.0
热点
AI SCORE
技术实践2026-08-17 03:43
AI 编程 Agent 的 harness 才是决定因素:同一模型最大 23.8 分差距来自它
dev.to · AI#Agent#AI 编程#Harness
Editor brief · 编辑速览
北京大学 2026 年研究用相同模型跑 6 种不同 harness,差距达 23.8 分;普林斯顿 2024 年实验改变接口形式让同一模型代码修改效果从 18% 提升到 76%。
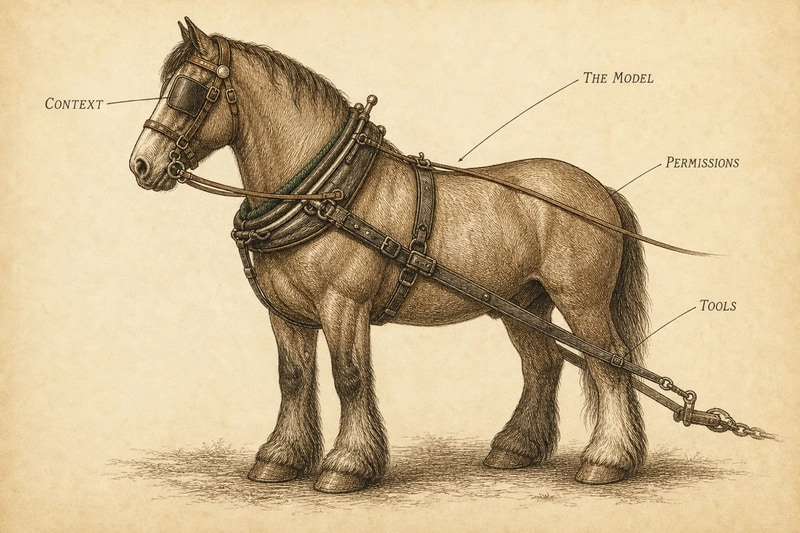
一个编码 AI 智能体的拆分方式与此相同。模型是那头动物。AI 智能体 harness 是绑在它周围的一切:使其持续工作的循环、它可以调用的工具、向它展示的内容,以及它被允许触碰的东西。而且这些"绑带"的作用与那头动物本身同样重要。
2026 年 5 月,北京大学的一个团队用同一个模型池对六种不同的 AI 智能体 harness 跑了 106 个任务,记录了超过五千次运行。最好的 harness 得分 76.2,最差的 52.4。这 23.8 分的差距来自 harness,而不是进行思考的模型。
如果你想要的是机制而非排行榜,最清晰的实验来自更早之前。2024 年,普林斯顿大学的一个团队保持模型不变,只改变了它用来处理代码库的接口。把它一次只展示一个文件的 100 行,它修复了 18% 的真实 GitHub 问题。把它换成展示整个文件,这个数字下降到了 12.7%。
更多信息,更差的结果。这就是 SWE-agent 论文,它把所变化的这个东西称为 agent-computer interface(智能体-计算机接口)。我们现在称之为 harness。
我想知道这三个主流工具实际上的不同之处,所以我克隆了它们的代码来研究,而不是只看它们的营销材料。其中两个是开源的。第三个有一次非同寻常的、信息量很大的意外泄露。
剥掉品牌外衣,语言模型就是一个函数。输入文本,输出文本。它不能读取文件、运行测试,也无法记住一分钟前说了什么,除非你把对话内容重新粘贴回去。它就像一个能力很强的人被锁在房间里,只能通过门缝递纸条。
Harness 就是门这边你所提供的一切,其核心小得惊人:
loop:
    response = model(context)
    if response contains a tool call:
        result = run_tool(tool_call)      # read a file, run bash, edit code
        context += tool_call + result
    else:
        show response to user, wait for input
这就是完整的 agentic loop(智能体循环)。模型输出一段文字说"我想运行 npm test"。Harness 实际运行它,把输出粘贴回 context,然后再次调用模型。模型读取失败信息,决定下一步做什么,然后继续循环。读取、编辑、运行、读取错误、修复、再运行。
这不是为了写博客而做的简化。在 OpenCode——三者中最容易阅读的一个——它就是 session/prompt.ts 里一个字面量 while (true),每次循环调用一次模型,当最后一次响应中不再包含未执行的工具调用时就 break。你用过的每一个编码 AI 智能体都是这个循环披上了不同的外衣。
那么,如果循环是一样的,为什么 harness 之间的差异如此之大?因为循环是骨架,所有有趣的部分都是它上面的血肉:存在哪些工具、如何描述它们、在你的第一条消息之前模型被告知了什么、什么不需要请求许可就可以运行、以及当 context 满了之后什么被丢弃。
普林斯顿大学逐个测试了这些决策,下面三个工具都对那些结果表明了自己的立场。上面提到的文件窗口是其中之一,值得 5.3 分。把对话历史裁剪到只保留最近五次工具输出(而不是保留全部)又值 3 分。给编辑工具配备一个拒绝句法错误修改的 linter,仅这一项就值 3 分。
注意这些都是什么类型的决策。前两个靠向模型展示更少来取胜。第三个靠允许模型少做一些来取胜。哪个都没有碰模型权重。全部都是 harness。
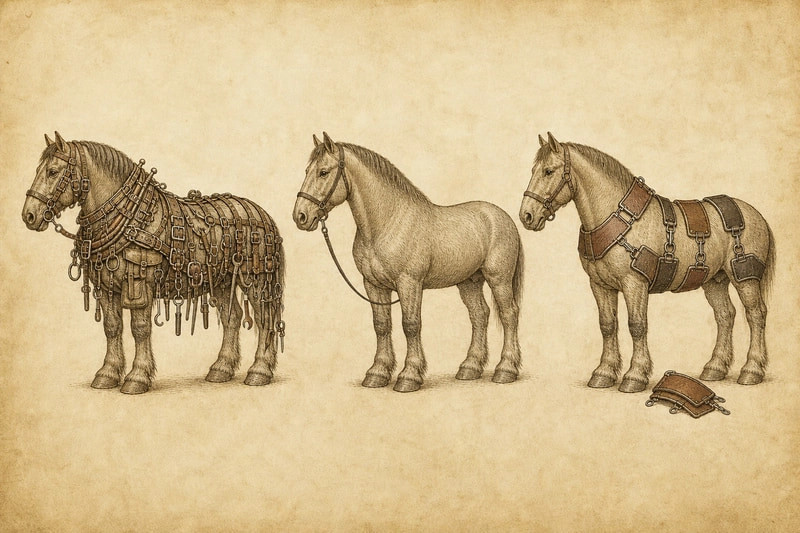
这就引出了三个工具,以及三种不同的答案。在阅读任何人的源码之前,它们并排对比最容易看清楚:一匹马被它的制造者能想到的所有绑带覆盖,一匹几乎什么都不穿,一匹由可以解开和替换的零件组成,视任务而定。

Claude Code 是闭源的。2026 年 3 月 31 日,一次打包错误在 @anthropic-ai/claude-code v2.1.88 中附带了一个 59.8 MB 的 source map,社区在它被撤回之前就已经重建出了 TypeScript 代码。正是这个窗口让任何人得以讨论其内部实现,而且自那之后每个版本的 prompts 都已存档。我阅读了 v2.1.223 的存档。
以下内容请视为重建材料,因为它们确实是。这是社区提取而非 Anthropic 官方发布,存档中的文件也不是最终字符串。它们是模板,满是 ${VAR} 插值和三元表达式,在运行时根据你的 sandbox 模式、git 状态、功能开关和运行的模型组装而成。许多是同一工具的互斥变体。
最后这一点很重要,以下是我精确统计的内容:
# in the archive's system-prompts/ directory
cat tool-description-*.md | wc -w   # 28973
cat system-prompt-*.md    | wc -w   # 28373
两个语料库,大小几乎相同。没有哪个单一会话会发送 29,000 词的 tool descriptions,因为条件分支意味着在任何一次调用中只选择其中一部分。这个比例告诉你努力花在了哪里。Anthropic 投入到描述工具的词汇量与模型收到的所有其他指令加起来大致相当。
工具表面非常庞大以与之匹配:约 45 个工具名槽位,覆盖约 95 个工具,每个都有详细描述。仅 Bash 的描述就分散在 39 个模板文件中,其中 16 个仅仅是为了根据 sandbox 模式重新措辞。
普林斯顿大学的结果表明,一个丰富、精心描述的工具表面比一个裸露的 shell 好 64%,在该基准上约高 7 分。Claude Code 就是完全相信这一发现并投资两年后的样子。
还有两件事让我印象深刻。第一,编排是用英语写的。最大的单个 system-prompt 片段是一个 5,916 token 的 coordinator 块,它纯粹是一篇关于何时委托、何时生成 subagent 而非继续现有 subagent、以及如何综合返回内容的散文。没有任何调度器(scheduler)。架构图是一篇文章。甚至有一个专门的块论证为什么不应当委托,它开头写道"Subagents multiply cost and time",随后指出适合在你自己的循环中完成的验证就应该在你的循环中完成。
第二,prompt 被编译为可缓存的。对泄露的分析描述了一个以 __SYSTEM_PROMPT_DYNAMIC_BOUNDARY__ 常量为界的分割。其上的一切对地球上每个用户都相同,位于共享缓存中;其下的一切是你的会话、你的 CLAUDE.md、你的 git 状态。没有这个技巧,这么大的 prompt 是无法承受的。Claude Code 官方发布的文档向构建 AI 智能体的人给出了同样的建议:永远不要在会话中途编辑 system prompt,因为它会使缓存的前缀失效。
OpenAI 的 Codex CLI 是 Apache-2.0 协议的 Rust 项目,它在几乎所有事情上都赌了相反的方向。它的注册表定义了大约 28 个工具名,但大多数是功能门控的,普通本地会话只暴露六到八个:shell_command、apply_patch、update_plan、view_image、web search,以及如果你配置了任何服务器的话还有 MCP resource 工具。
那些缺失的工具才是重点。它们作为散文回来了。
你可以在 OpenAI 自己的宣传截图中看到这一点。读取画面中央模型的推理过程:它正在自言自语地决定用 ls 和 rg --files,因为它只有这些。
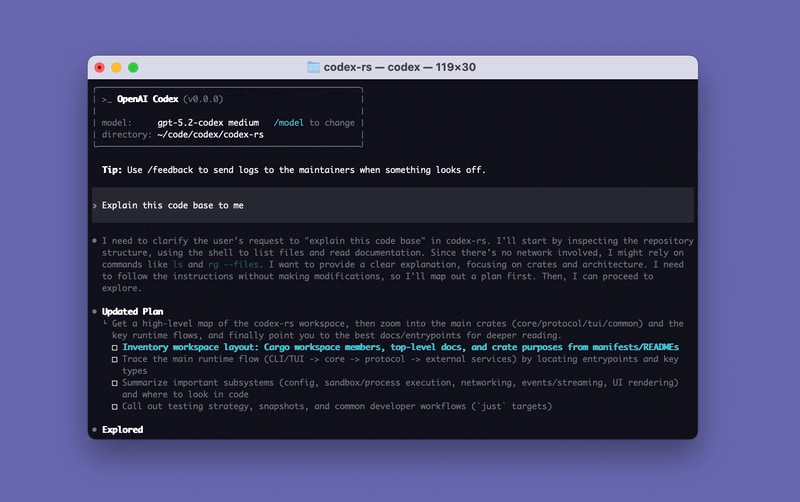
最能说明问题的是那些缺失工具的去向。它们作为 prose(散文)回来了。
由于没有搜索工具需要描述,提示词直接告诉模型先使用 rg 或 rg --files。由于没有写文件工具,它会警告:"不要使用 cat 或其他 shell 写技巧来创建或编辑文件。"
Claude Code 将这类知识放在工具描述里。Codex 将其放在一句话中。完整的系统提示词长度在 1,822 到 3,511 个词之间,取决于使用的模型,而且它现在以 JSON 格式发送,而不是仓库中仍然存在的 markdown 文件。
这是对 Princeton 研究结果的一个深思熟虑的赌注,而且并非愚蠢之举。那篇论文的纯 shell 基线是 2024 年的模型。从那以后,模型在终端使用方面接受了大量训练,Codex 赌的是它们已经将这些接口吸收到了权重里。如果这个赌注是对的,那么在 2024 年带来 7 分提升的脚手架现在消耗的 token 和带来的僵硬性已经超过它的回报。是否正确,似乎还没有人认真测量过。
Codex 将其复杂度花在了隔离上,而且在这方面它是三者中最为认真的。它附带了三种沙箱实现:macOS 上的 Seatbelt、Linux 上的 bubblewrap 加上 seccomp,以及 Windows 沙箱。策略是一个类型化的枚举,默认是只读,还有 workspace-write、external-sandbox 和 danger-full-access。网络访问默认关闭,除非你打开它。macOS 策略在生成时创建并作为参数传递,而不是写入文件,从一个全拒绝的默认策略开始。
我喜欢的一个小细节:在每个可写根目录下,三个目录被强制恢复为只读,分别是 .git、.agents 和 .codex。AI 智能体可以随意重写你的源码,但它无法触碰你的 git 内部结构或它自己的配置。有人认真考虑过这一点。
关键的差异在于:Claude Code 通过解析命令并推理来判断命令是否安全。Codex 通过要求内核让危险操作变得不可能来判断。一个是在门上装了一把非常好的锁。另一个是没有门的房间。
OpenCode:没有偏好的 AI 智能体
OpenCode 是 MIT TypeScript 编写,截至我写这篇文章时是 1.18.14 版本,它提出了一个不同的问题:如果一个脚手架不效忠于任何实验室会怎样?它从一个包含 24 个提供商包的目录中解析模型,并按需从 npm 安装其他任何东西,所以 Anthropic、OpenAI、Google 和本地 Ollama 模型在它看来都是同一种东西。
把它和 Codex 的截图并排放,你不需要读一行源码就能看出差异。Codex 用推理的方式得到 rg --files,而这个工具发出的是命名的 Grep、Glob 和 Read 工具。再看状态栏:那是 Claude Opus,运行在一个与 Anthropic 没有关系的脚手架里。
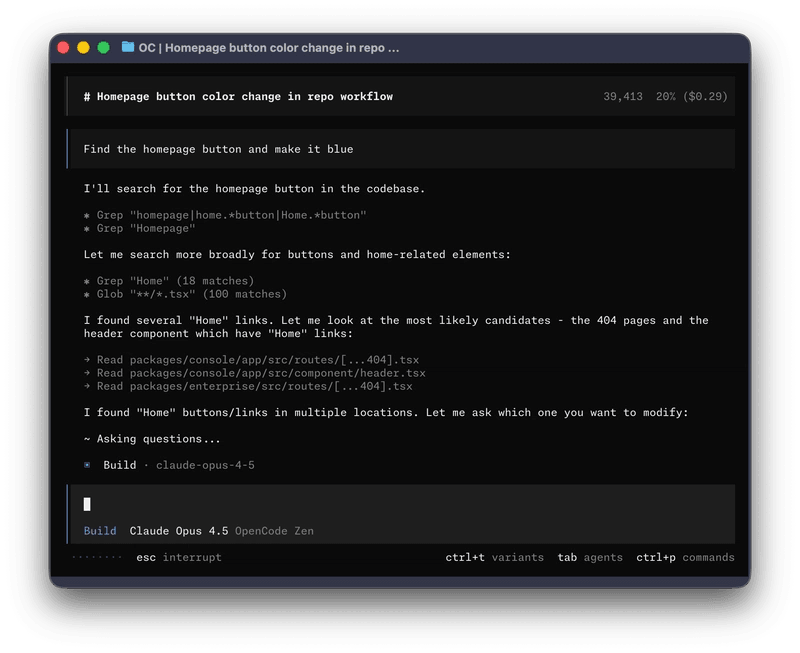
它的工具面在三者中居中,共 17 个工具,描述保存在单独的 .txt 文件中,共 2,757 个词。但它在 Princeton 研究结果上是最有趣的一个,因为它几乎原样实现了其中两项。
linter 护栏是真的。在 tool/edit.ts 里,编辑应用后,它调用 lsp.touchFile() 然后调用 lsp.diagnostics(),并将结果折叠到模型回读的内容中。这就是论文中 3 分发现的的生产版本,而且比论文的版本更好:不是语法检查,而是你实际的语言服务器,和你的编辑器向你展示的诊断信息一样。
遗忘是刻意的且可调的。session/compaction.ts 有两种机制,带有命名的常量。Prune 在 TOOL_OUTPUT_MAX_CHARS = 2_000 处截断旧的工具输出,同时保持最后 DEFAULT_TAIL_TURNS = 2 轮完整。Compact 在上下文溢出时进行摘要。保留最近的观察,剔除旧的观察,并附上配置文件。
这里有一件事我在其他地方没见过:脚手架围绕模型重塑自己。在工具注册表中,GPT 系列模型被给予 apply_patch,而 edit 和 write 被移除,而其他所有模型则相反。系统提示词也是按模型系列选择的,Anthropic、GPT、Codex 和 Gemini 都有单独的文件。OpenCode 悄悄得出结论:没有最好的工具面,只有对给定模型最好的工具面。在三者中,这是对 Princeton 结果最尖锐的解读。
权衡是真实存在的。根本没有 OS 级别的沙箱。权限是进程内检查,使用最后匹配规则取胜的方式求值,默认是 ask,bash 工具使用 tree-sitter 解析命令来推导每条命令的权限模式,而不是一次性请求所有 shell 访问权限。这是相当不错的工程,但它仍然只是一扇门上的锁,而不是没有门的房间。
不过在架构上,它是三者中唯一有真正的客户端-服务器分离的:AI 智能体作为一个无头 HTTP 服务器运行,其 OpenAPI 规范生成客户端 SDK,终端 UI 只是它的一个消费者。
其中两个正在悄悄建设的下一个东西
这是我没想到在两个代码库中同时发现的。
Codex 的三个最新模型配置了 "tool_mode": "code_mode_only"。在该模式下,整个工具面塌缩成一个名为 exec 的自由形式工具,其载荷是调用工具作为普通 API 的源代码。不是模型一次选择一个项目的菜单,而是一个它编写的程序。Codex 还支持延迟工具,这些工具根本不在请求中包含,模型通过 tool_search 调用按需找到它们。OpenCode 在一个实验性标志后面有相同的想法,一个名为 execute 的工具,它将每个工具的列表交换为模型编写代码所依据的类型目录。
想想这对上下文意味着什么。不再为每轮每个工具描述付费,而是只付一份费用,让模型用自己的推理来组合其余部分。这就是 Princeton 教训走到极致的结果:脚手架的工作不是向模型展示它可能需要的一切,而是在保持一切可触及的同时展示尽可能少的东西。
我真正想说的
脚手架添加的大部分东西是减法。它向模型展示文件的窗口而不是整个文件,丢弃过期的工具输出,并在工具边界拒绝破碎的编辑,而不是让模型三轮后发现。那些都是限制,在论文中正是这些获得了最高分。这不是一年的更大上下文窗口公告会让你期望的。
三者对应该减去多少有着不同的赌注。Claude Code 相信工具面,花更多的词描述其工具而不是指导模型,并构建了一个缓存管道使这变得可负担。Codex 相信现代模型已经知道终端,所以它只提供少量工具、一个几千词的提示词和三个内核沙箱。OpenCode 相信答案取决于模型,所以它根据你加载的模型交换自己的工具和提示词,并把服务器交给你自己运行。
如果你今天要选一个:如果你不介意 token 账单,要最深入的工具链,选 Claude Code;要速度和真正可防御的沙箱,选 Codex;要拥有整个技术栈并自带模型,选 OpenCode。但脚手架只是一个循环、一个工具列表和一组关于丢弃什么的决定,一旦你能看到这一点,你就可以在一个下午读完任何一个代码库,不再猜测你的 AI 智能体为什么会原地打转。
每个人还在争论哪种动物最强。测量结果一直指向的是背带。