
8.0
热点
AI SCORE
技术实践2026-10-04 06:56
Agent报告完成但数据库未写入:分布式一致性的典型陷阱
Hugging Face Blog#AI Agent#分布式系统#一致性
Editor brief · 编辑速览
Hugging Face官方博客深度剖析AI Agent执行任务时「操作成功」与「数据落库」之间的状态不一致问题,给出分布式事务视角的根因分析与规避方案。


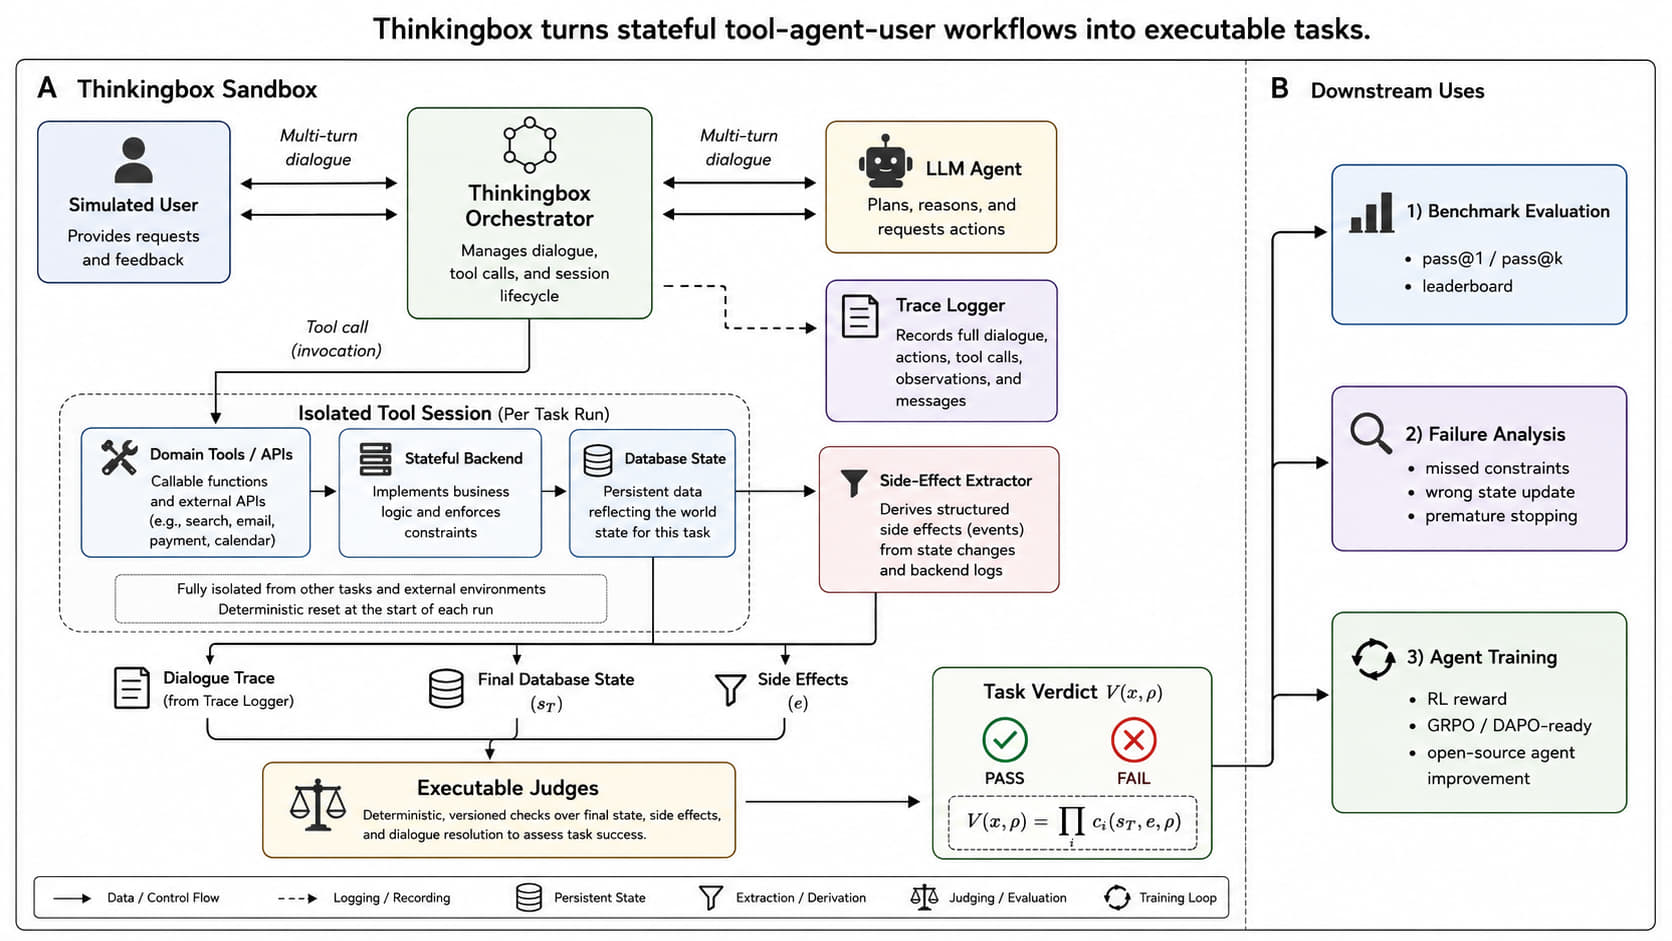
图 1:ThinkingBox 针对孤立的 MCP 工具会话运行 AI 智能体,然后对其留下的终端后端状态和副作用进行评分。图片来自 ThinkingBox 论文。
一位客户发来邮件。她的 745 美元厨房电器在纳什维尔配送中心被困在快递"异常"状态,已经比预计送达日期晚了十五天。
AI 智能体做了仔细的工作。九次工具调用:拉取订单、查看物流、查询客户档案、搜索退换政策两次、确认无工单存在、创建一个工单、记录时间线、正确读取政策;她的账户细分确实不符合晚送达补偿条件。
然后它将工单标记为已解决,并回复"由于您的查询已解决,还有其他需要我帮助的吗?"
有两处错误。承运商异常仍然开放,所以要求的最终状态应该是"待处理",等待解决。而客户从未得到她实际询问的问题的真正答案。
检查工具调用的 AI 评分器会看到九次格式良好的调用。检查 AI 智能体是否写入数据库的评分器也会看到这一点。数据库才是不同意的那一方。
这个差距正是 ThinkingBox 衡量的。在 507 个有状态业务工作流中,每个工作流针对各种 LLM 模型运行 20 次,它根据终端后端状态和副作用对 AI 智能体进行评分。这篇文章涵盖我们的发现、一致性的成本,以及如何通过 OpenEnv 自己运行这个基准测试。
你可以自己运行这个:上面的例子改编自基准测试任务 sandbox_external_retail_group1.py:test_case_ST003_006,而失败的执行检查是一个字段:工单的状态是 solved,而要求的最终状态是 hold。完整追踪记录在我们的论文附录 D.4,案例 3 中。
一次工具调用不是结果
一次成功不是可靠性
你能依赖你 AI 智能体背后的模型吗?
一致性要付出什么成本
想在阅读结果之前自己试试?跳到"自己运行"部分。
一次工具调用不是结果
最终响应和有效的工具调用只是代理。AI 智能体可能听起来正确,但实际上留下了错误的值、修改了错误的记录,或者产生了额外的副作用。只有它留下的记录才能定案。
这个差距很大。在覆盖 12 个 LLM 模型共 121,680 个有效试验的公共集消融实验中,79,853 次尝试未通过执行检查。在这些失败中,67.24% 仍然正常终止、调用了状态变更工具、并报告没有最终工具错误。然而,执行检查仍然在 77.61% 中发现了错误的字段值,43.30% 有意外的额外效果,25.36% 缺少必需的效果。这些状态检查发现的结果是重叠的。
一条轨迹是一个声明。数据库状态是证据。重复是信任测试。
一次成功不是可靠性
一个正确处理一次退款而下一次四次都处理错误的 AI 智能体,不是一个正常工作的退款 AI 智能体。因此每个任务运行 20 次独立尝试,每次都从相同的干净后端开始,我们报告三个不同的指标:
表 1:我们报告的三个数字,以及每个数字回答的问题。
在这篇博客文章中,我们使用 observed 20/20 作为字面计数,即 507 个任务中有多少通过了 20 次中的 20 次。不使用估计器,不使用平滑处理。
从熟悉的视图开始。下表报告了按领域细分的 pass@1,即单次尝试分数估计。这是大多数排行榜发布的数字,单独来看它读起来像一个普通的能力排名。
表 2:ThinkingBox-Bench 按领域的 pass@1 (%)。每个模型在 20 次重复试验中评估每个任务。加粗标记组内领先;下划线标记第二名。单次尝试分数估计的标准误差在我们的 ThinkingBox 论文中的表 4 中提供。
Claude Opus 5.5 以 67.16% 的总体成绩领先,比 Claude Opus 5 高出三分之二个百分点。Kimi-K3 是最强的开源权重模型,与 GPT-6-Astra 相差不到一分。领域同样重要:Claude Opus 4.6 在零售领域得分为 68.62%,但在汽车保险领域仅为 8.30%。
一次好的运行告诉你模型能够完成这项工作。它不能告诉你它是否会再次完成。所以运行每个任务 20 次,问自己有多少分数能保留下来。
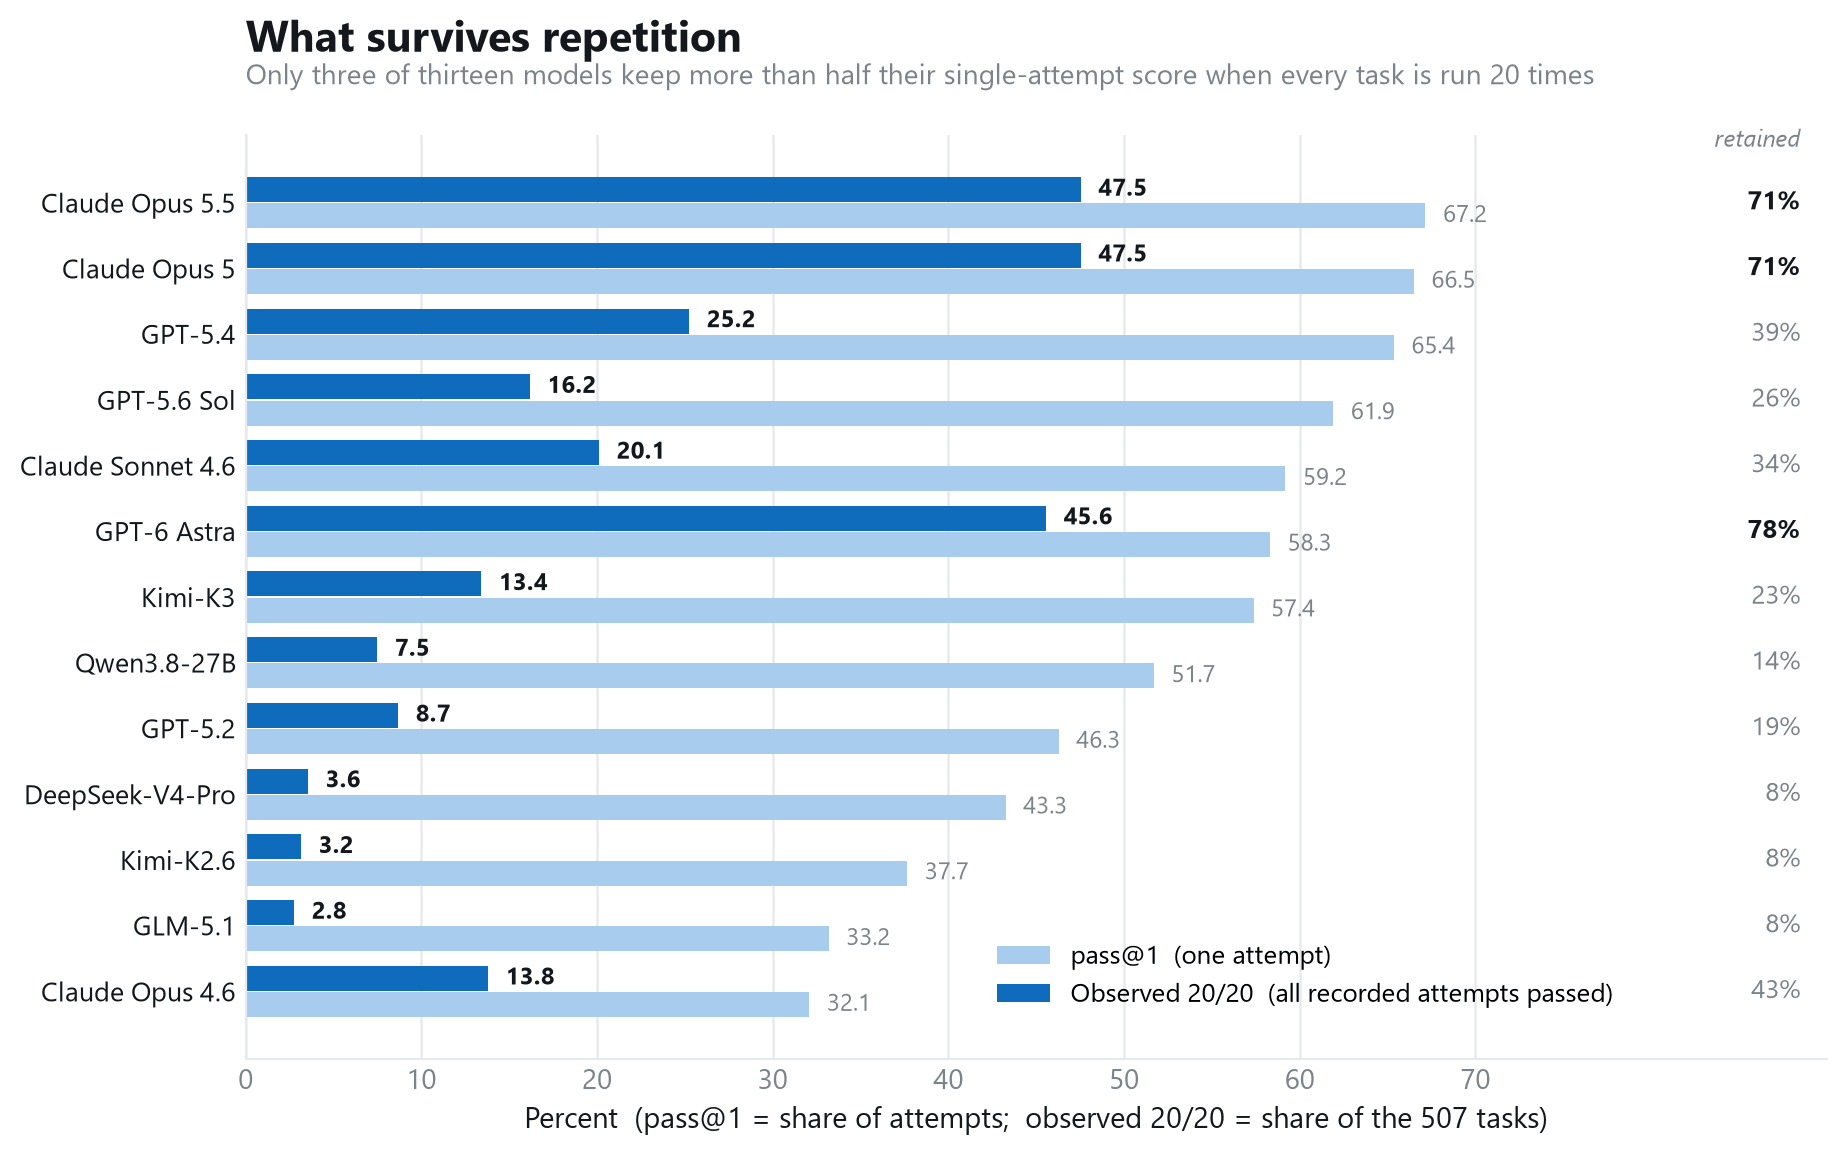
图 2:每个模型的单次尝试分数在 20 次重复中保留了多少。
只有三个模型保住了大部分 pass@1 分数:GPT-6 Astra 保留了其单次尝试率的 78%,Claude Opus 5.5 和 Claude Opus 5 各保留了 71%。在另一端,GLM-5.1、Kimi-K2.6 和 DeepSeek-V4-Pro 各保留了约 8%。
模型一次能做什么和每次做什么之间的差距就是全部故事。
你能依赖你 AI 智能体背后的模型吗?
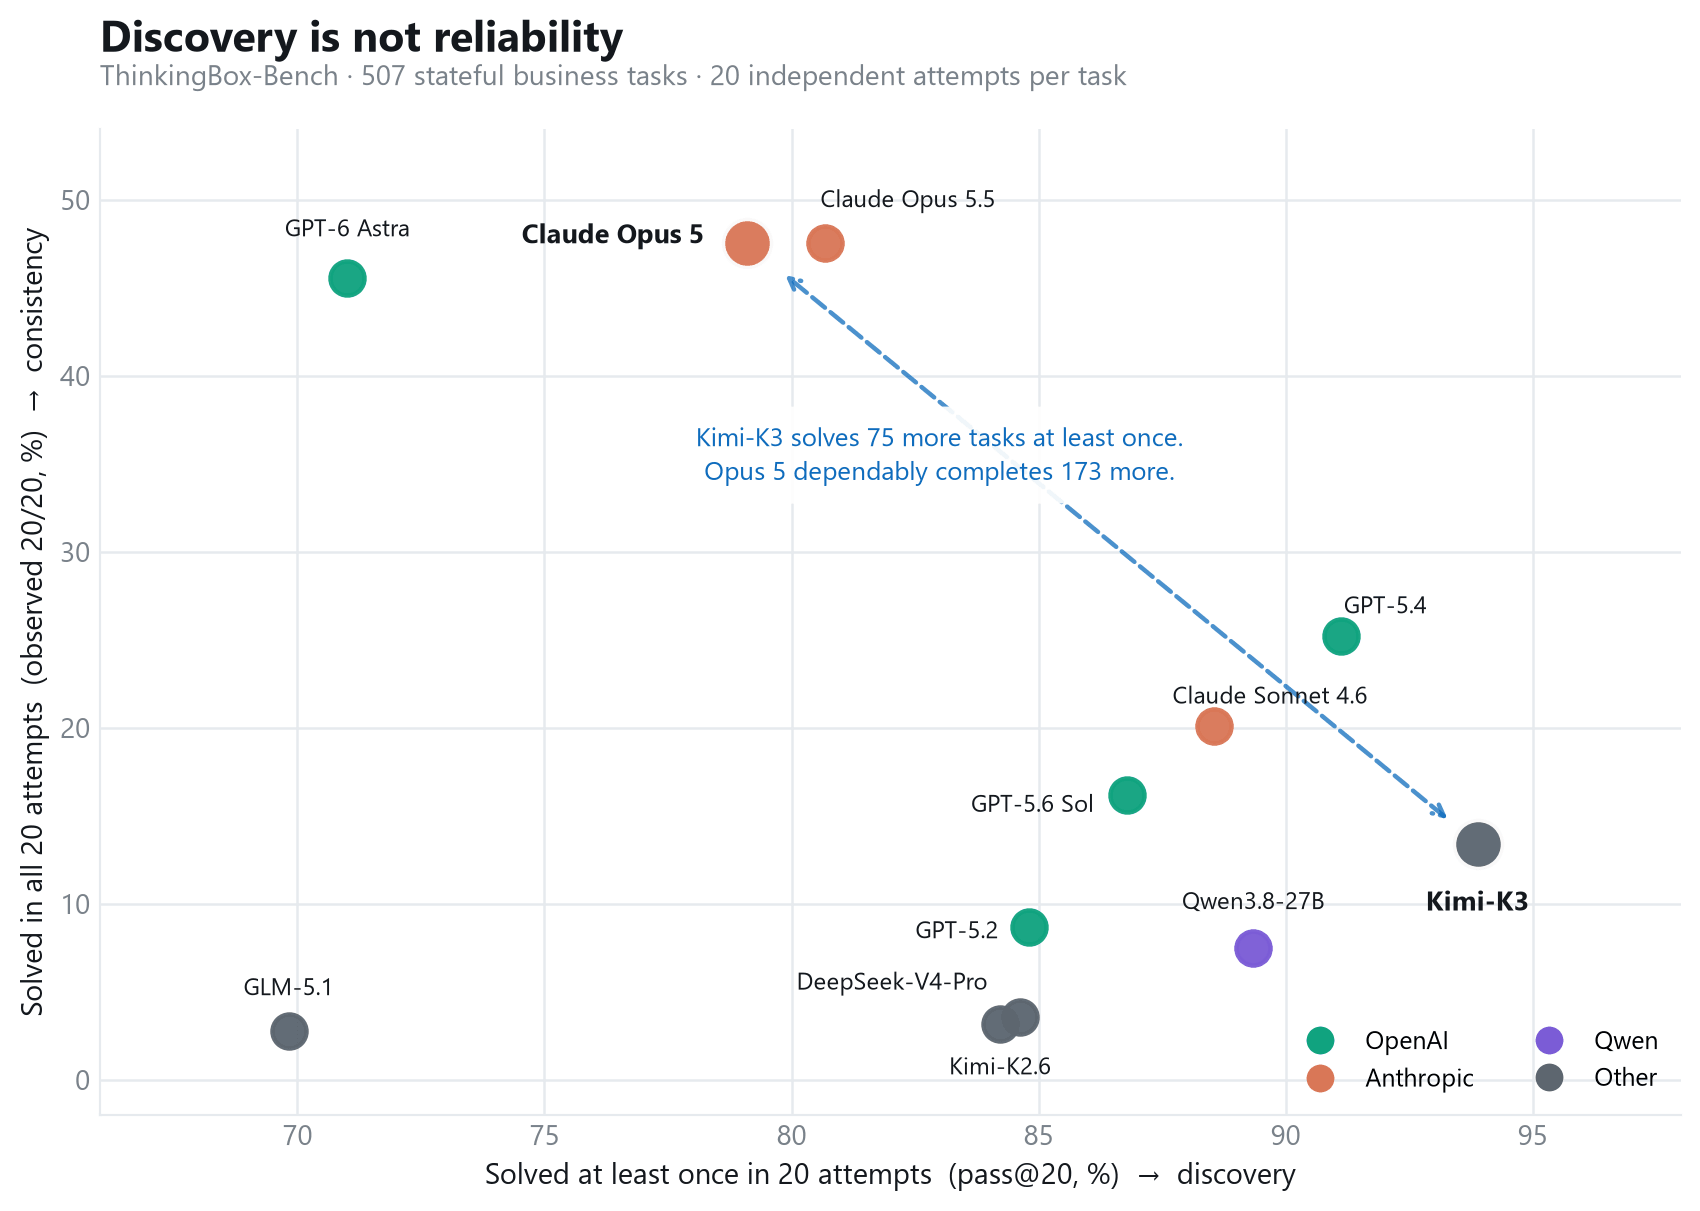
图 3:广度和一致性分道扬镳。显示了十八个模型中的十二个;低于 33% pass@1 的六个因可读性省略。
Kimi-K3 在我们测试的所有模型中覆盖范围最广。它至少一次解决了 93.89% 的基准测试:507 个任务中的 476 个。只有 31 个任务完全击败了它,是所有模型中最少的。在零售工作流上它以 82.24% 的 pass@1 遥遥领先,领先于每个专有模型。
Kimi-K3 也是一致性最差的模型之一。只有 68 个任务(占 507 个的 13.41%)在全部 20 次尝试中都成功。
Claude Opus 5 反转了这个结果。它至少一次解决的任务较少(79.09%;106 个完全击败它),但在每次尝试中都完成了 47.53% 的基准测试。
一个更新的模型不能解决这个问题。Claude Opus 5.5 在每次尝试的平均分数上高于 Claude Opus 5,为 67.16% 对 66.50%,并至少一次解决了更多任务。它在全部 20 次尝试中通过的任务数量完全相同:241 个。零点五个百分点的 headline 准确率完全没有买到额外的可靠性。
Kimi-K3 至少一次解决的任务比 Opus 5 多 75 个。
Opus 5 持续解决的任务比 Kimi-K3 多 173 个。
如果你在为接触真实记录的工作选择模型,pass@20 不是你应该看的列。
一致性要付出什么成本
能力比较通常在分数处停止。对于任何在实际部署中的人来说,相关问题是成功执行一个工作单元的成本是多少。我们将其衡量为每次成功任务尝试的成本。我们说任务尝试是因为每个基准测试任务都重复运行,并且每次尝试都会产生成本,所以 pass@1 是匹配的质量分母。
我们从每个模型的完整 507 × 20 运行活动中获取其记录的 token 使用量,并按 OpenRouter+ 上提供的未折扣标价定价,逆推促销折扣,不包括声明量化(endpoints that declare quantization)的端点。输入、输出和缓存费率均来自每个模型的一个提供商端点。
然后我们将一次运行的成本除以成功的尝试次数:
每次成功任务尝试的成本 = 507 次尝试(每个任务一次)的估计成本 ÷ (507 × pass@1)
这是一个比较效率指数,不是账单,也不是服务一个生产请求的价格。它也是对单次成功的定价,不是一致性。我们接下来为一致性定价。
示例:GPT-5.4 的 507 次尝试(每个任务一次尝试)成本为 43.49 美元,pass@1 为 65.36%,所以 43.49 ÷ (507 × 0.6536) = 每次成功任务尝试 0.131 美元。
如果没有任何其他模型既不更贵又至少同样准确,那么一个模型就在前沿线上。三个模型符合条件;其他每个模型至少在一个维度上被主导。
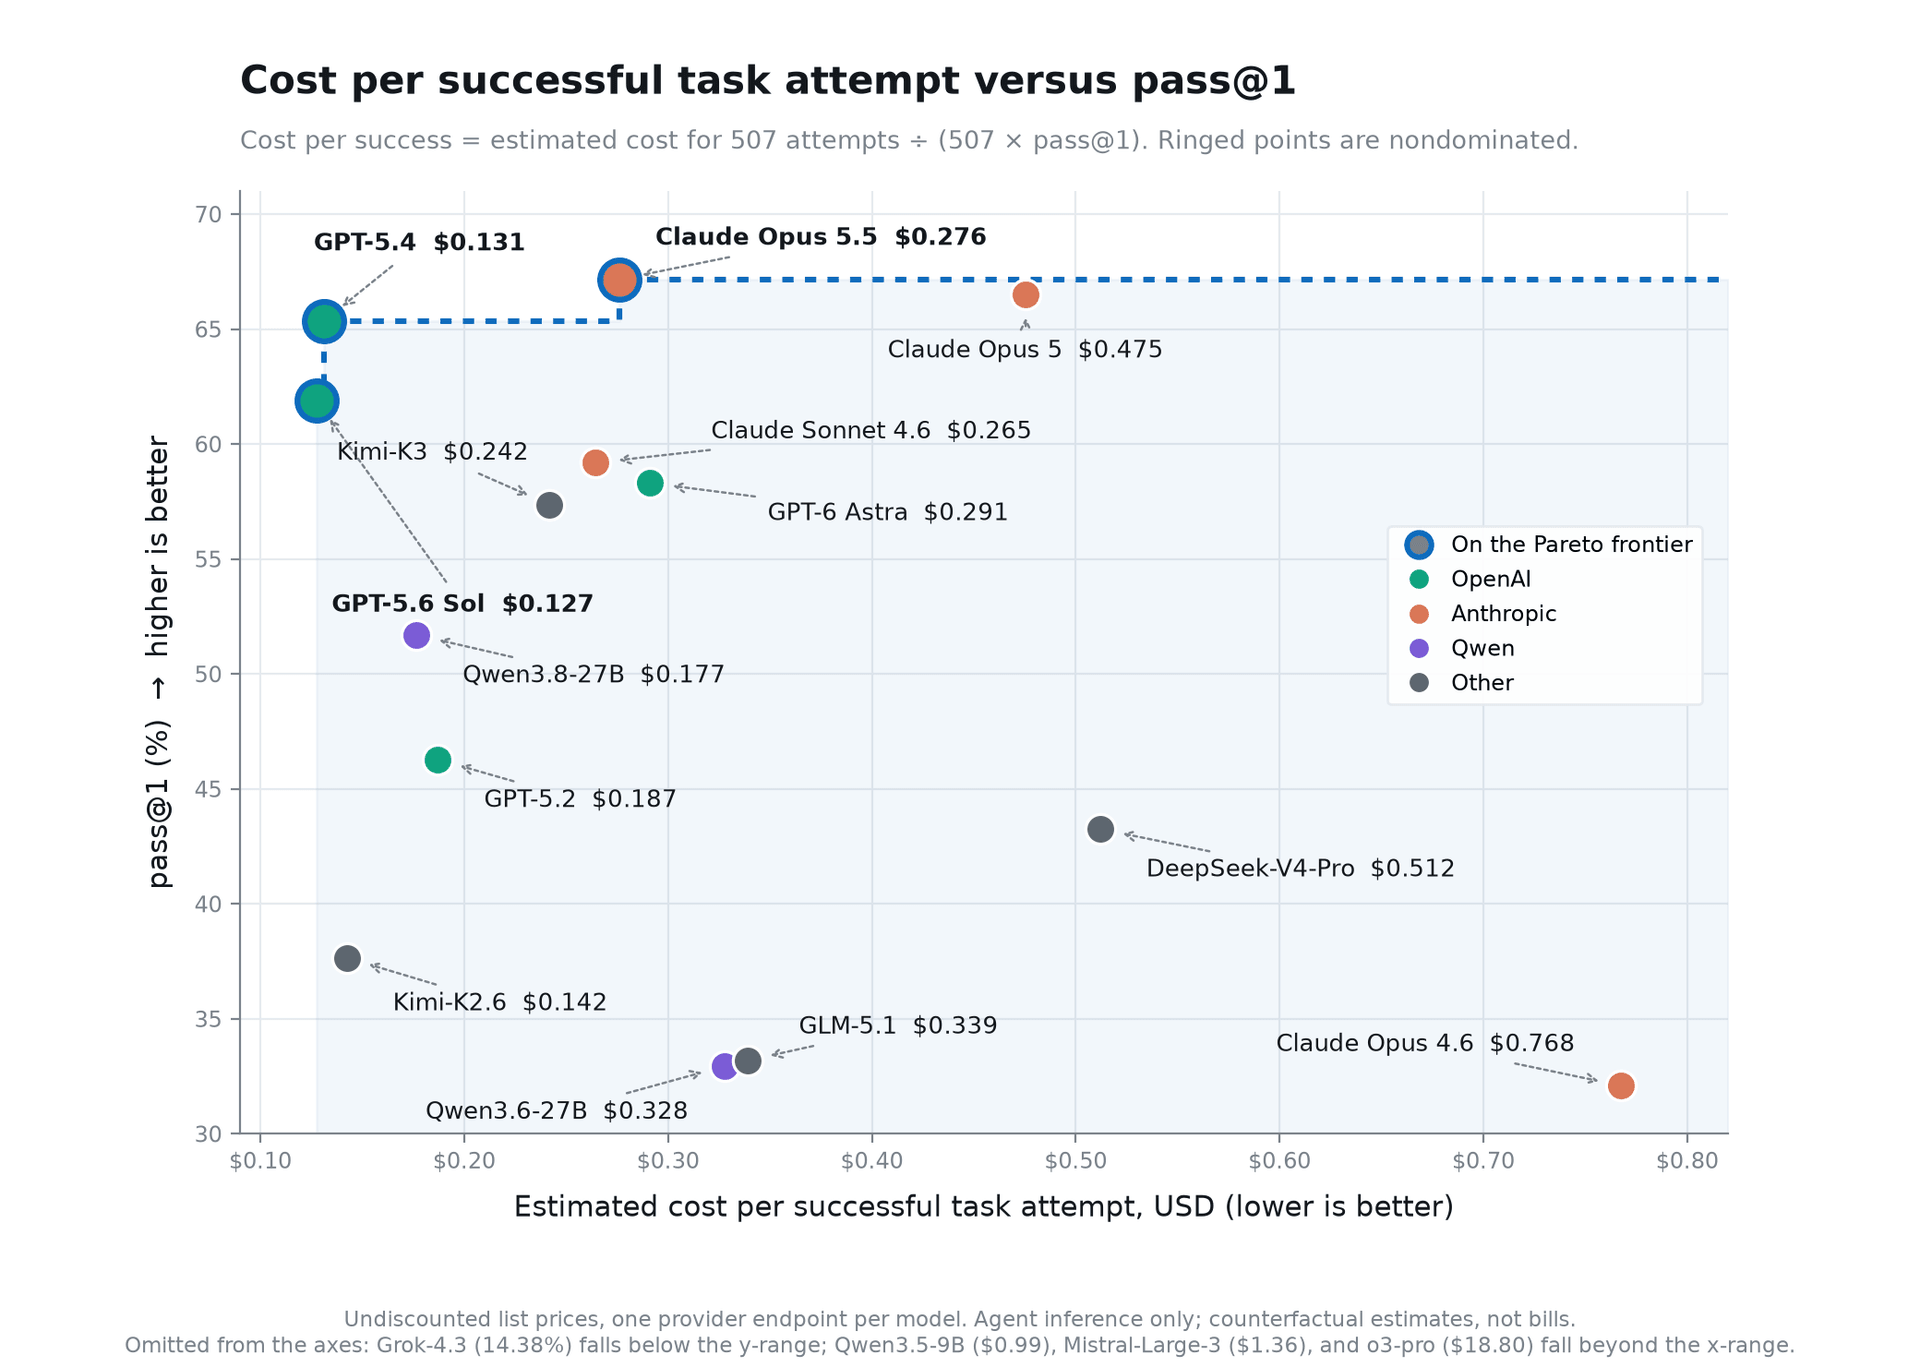
图 4:每次成功任务尝试的成本与 pass@1 的关系。圆环标记的点是帕累托成本前沿模型。
前沿有三个层级。GPT-5.6 Sol 的每次成功成本最低,为 0.127 美元;GPT-5.4 将 pass@1 提高了 3.45 个百分点,每次成功仅多花 0.004 美元;Claude Opus 5.5 再增加 1.80 个百分点,每次成功成本为 0.276 美元。这三个模型都保持在成本前沿线上,因为没有更便宜的模型能匹配其 pass@1。
Claude Opus 5 是最明显的案例:每次成功尝试 0.475 美元,pass@1 为 66.50%,它既比 Claude Opus 5.5(0.276 美元和 67.16%)更贵又不更准确。
现在为一致性定价
每次成功成本奖励的是便宜且经常正确的模型。它不奖励每次都正确的模型。因此我们还计算每个可靠任务的成本:20 次运行 507 次尝试的完整活动成本,除以模型在全部 20 次尝试中都通过的任务数。
每个可靠任务的成本 = 20 次运行 507 次尝试的估计成本 ÷ 20/20 通过的任务数
示例:GPT-6-Astra 的活动成本为 20 × 86.03 = 1,720.60 美元,在每次尝试中都通过了 231 个任务,所以 1,720.60 ÷ 231 = 每个可靠任务 7.45 美元。
表 3:在至少有一个观察到的 20/20 任务的模型中,每次可靠任务的成本最低的九个模型,按成本从低到高排序。预估金额$,非实际云账单。
现在按一致性排名。GPT-5.4 最便宜为 $6.80,但仅有 128 个任务达到标准。GPT-6 Astra 达到 231 个,成本 $7.45,Claude Opus 5.5 以并列最高的 241 个任务,成本 $7.80。
三个模型没有一个能完全压制另一个:每多一个可靠任务,成本都在上升。Claude Opus 5 也超过了 241,但成本为 $13.30,所以 Opus 5.5 完全压制了它。GPT-5.6 Sol 单次成功最便宜为 $0.127,但每个可靠任务的成本为 $9.76。获得正确答案的最便宜方式,不是获得可靠任务的最便宜方式。
我们为每个失败的 trace 分配一个确定性的诊断签名,核心结论是可操作的:大约五分之四的失败是工具处理问题,而非推理问题。跨越我们论文中表 5 的消融研究:
这些是每个模型份额和可观察标签的未加权平均值,而非唯一的因果解释。
实际模式很简单:智能体通常能走到尝试执行工作流的阶段,然后在工具错误、前置条件失败或空查询面前无法恢复。这是一个重试和错误恢复问题,在它成为模型问题之前。
难度也随领域不同而变化:在上方面表 2 列出的模型中,零售平均 pass@1 为 59.52%,而汽车保险为 33.83%。
如何应对。把 20/20 率当作设计输入,而非判决。基准测试评分的同一信号在生产环境中同样可用:在提交前检查终端状态,而非模型对它的总结。
对工具和系统错误进行分类,以便重试能针对可恢复的错误。将工具表面缩减到工作流所需的范围。对于那些无法低成本逆转的变更,要求人工审批。我们尚未在这个基准测试中测量任何这些措施带来的提升,而这正是该环境现在可以测试的东西。
ThinkingBox 是智能体沙箱,而 ThinkingBox-Bench 是用于评估智能体的数据集基准。上方图表展示了循环;以下是每个部分的作用。
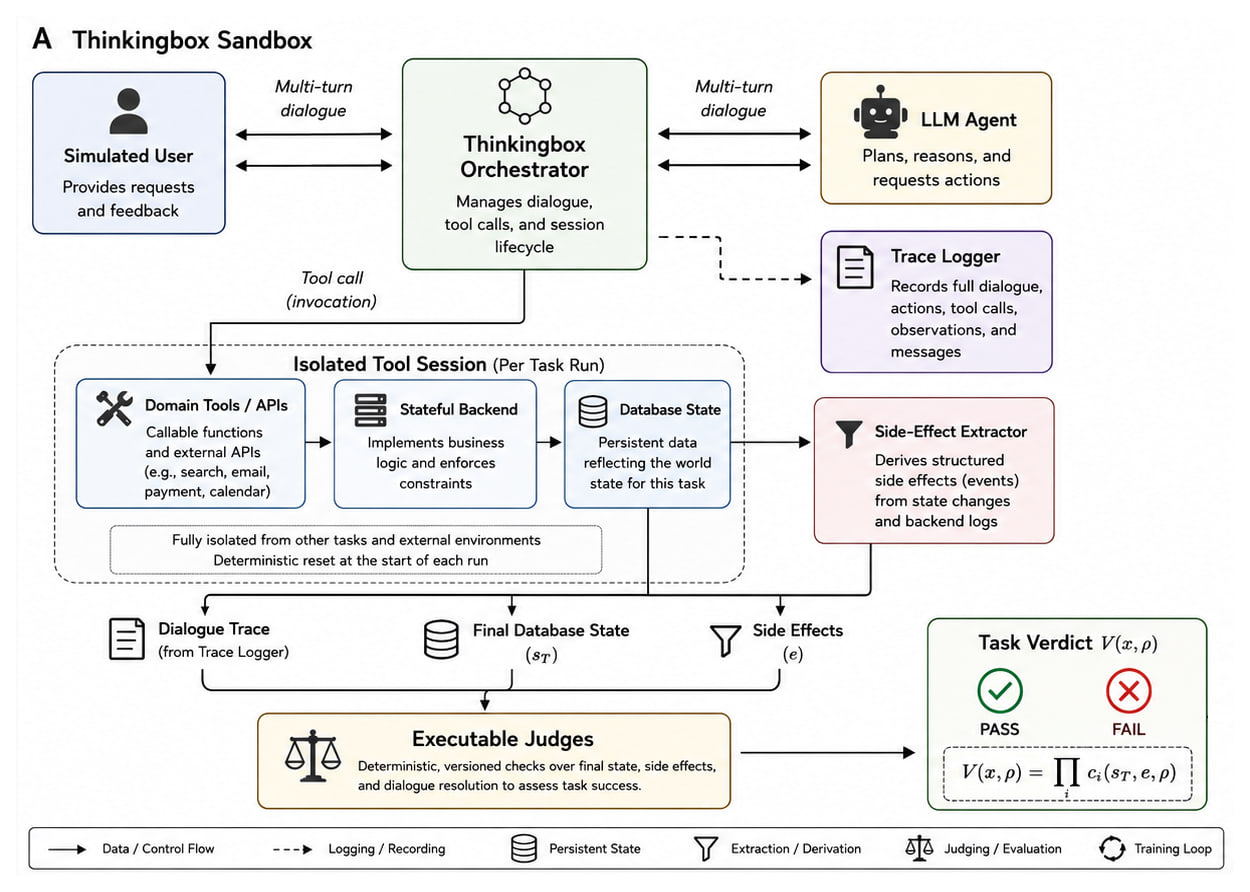
图 5:上方图 1 面板 A 中的沙箱循环:隔离的工具会话、终端数据库状态、副作用、可执行裁判。
每个任务定义了起始后端状态、用户目标、可用的 MCP 工具、领域策略以及对终端状态的可执行检查。一个模拟用户持有私有上下文(预订编号、偏好或出生日期),仅在被询问时释放。
每次尝试都获得一个状态全新初始化的隔离 MCP 会话。同一任务的两次尝试从不共享数据库行或缓存的工具状态,这正是 20 次试验比较有意义的原因。
最后,副作用提取器推导出实际发生了什么变化,确定性裁判将其与所需终止状态进行比较,接受任何产生正确结果的操作轨迹,同时拒绝错误、缺失或额外的效果。对于没有干净数据库值的需求("智能体是否披露了这不保证?"),一个窄义的二元评分问题处理语义。507 个任务中有 477 个仅根据状态评分;有 30 个添加了响应评分。
信任边界:模型看到任务、对话和工具模式。黄金状态、断言、评分内部信息和凭证留在评估器一侧。
ThinkingBox 现已在 Hugging Face 上线,包含测试框架和数据集。ThinkingBox-Bench 现位于 OpenEnv 接口之后,每个完成的 episode 返回一个二元的通过/失败奖励。发布的适配器专为评估而设计;在训练工作流中,单独的非基准场景可以使用相同的接口。
已在 Linux 和 WSL 上测试,需要 Python 3.11+、uv 和 Docker。还需要在固定版本检出 thinkingbox-data 并为智能体、模拟用户和裁判提供模型端点。一个端点可以服务所有三个角色,这是最简单的启动方式。OpenEnv 镜像仅启动 OpenEnv API;其他一切由你自行运行。
# 1. OpenEnv + ThinkingBox 环境
git clone https://github.com/huggingface/OpenEnv
cd OpenEnv
uv sync --project envs/thinkingbox_env --frozen
# 2. 可执行基准测试,固定版本
git clone https://github.com/microsoft/thinkingbox-data
git -C thinkingbox-data checkout thinkingbox-bench-v1.0
# 3. ThinkingBox CLI,提供 `tb` 命令
uv tool install "thinkingbox @ git+https://github.com/microsoft/thinkingbox"
在第二个终端中,启动 Typesense 30.1 并等待健康检查:
mkdir -p .typesense-data
docker run --rm -d --name thinkingbox-typesense \
  -p 8108:8108 \
  -v "$PWD/.typesense-data:/data" \
  typesense/typesense:30.1 \
  --data-dir /data --api-key=Fake --enable-cors
until curl -fsS http://127.0.0.1:8108/health; do sleep 1; done
启动 MCP 服务器
在第三个终端中,启动 Session Proxy 和 MCP 服务器。
cd OpenEnv
tb mcp-start --host 127.0.0.1 --port 7111 \
  --servers "$PWD/thinkingbox-data/servers/servers.yaml"
curl -fsS http://127.0.0.1:7111/health
启动 OpenEnv 服务器
回到第一个终端,针对 ThinkingBox YAML 配置启动 OpenEnv 服务器,配置中命名你的三个模型(配置指南):
OPENENV_TB_CONFIG="$PWD/thinkingbox.yaml" \
uv run --project envs/thinkingbox_env --frozen server
在运行任何内容之前先检查就绪状态。它在可观察数据、配置和 Session Proxy 检查通过前返回 503。它无法观察 Typesense 或主动探测每个模型端点,因此请单独确认这些:
curl -sS http://127.0.0.1:8000/ready
现在对一个真实 episode 进行评分。example_usage.py 仅重置和列出工具;对于智能体操作、效果和断言,请使用打包的评估器:
echo "- sandbox_external_retail_group1.py:test_case_ST002_001" > one_task.yaml
uv run --project envs/thinkingbox_env thinkingbox-eval \
  one_task.yaml \
  --config "$PWD/thinkingbox.yaml" \
  --output results.jsonl \
  --errors-output errors.jsonl \
  --repeat 1 --message-timeout 1800
OpenEnv 适配器将操作失败写入一个 errors sidecar,以便可以重跑,而非静默混入模型结果。规范结果必须解决或明确处理这些尝试;我们将系统错误计为不成功的试验。
运行受限于固定的框架提交、固定的数据版本和 bundle 哈希,因此规范结果是可验证的,而非只是断言。
这项工作有用的部分不是我们的 pass@1 排行榜。而是这个环境。
如果你正在评估一个触碰真实记录的智能体:
检查一个失败案例。找一个干净终止但仍然失败的运行,查看数据库中实际发生了什么变化。它重新审视了你的评估实际在测量什么。
通过 OpenEnv 用你自己的模型复现一个任务。
报告一个重复指标,并定义它。无论你的用例支持多少 k;说明你报告的是 best-of-k 还是 every-of-k,以及你是如何计算的。
更多细节请参阅以下链接:
环境:envs/thinkingbox_env
OpenEnv:https://huggingface.co/docs/openenv/environments/thinkingbox
框架:microsoft/thinkingbox · tutorial
基准测试:microsoft/thinkingbox-data · v1.0 release
数据集查看器:microsoft/ThinkingBox-Bench
论文:arXiv:2608.19741 或 HF
RL 训练(即将上线):microsoft/thinkingbox-training
ThinkingBox 代码采用 MIT 许可证;基准测试数据采用 CDLA-Permissive-2.0;OpenEnv 环境随 OpenEnv 的 BSD-3-Clause 发布。
免责声明:公开基准测试中的每个任务都是合成重建。 工作流和策略基于真实的 AI 智能体企业模式建模;客户并非真实。
ThinkingBox 和 ThinkingBox-Bench 由 Microsoft Copilot Studio 团队与 Toloka 合作构建,合作者来自University of Pittsburgh、Northwestern University、Columbia University 和 UC Irvine 在 Microsoft 实习的学生。问题欢迎在下方评论区或 github 上提出。
本文提及的数据集 1
本文提及的论文 1