本地模型与云端API如何分工
文章比较自托管模型与云端API的成本和适用条件,讨论硬件能承载的模型规模,以及本地与云端之间的请求路由。
AI 深度解读
自建 LLM 还是调用云 API,不必一次选死。n8n 这篇文章给出的方案是:把两条路径接进同一套工作流,先检查数据能否出网,再根据任务难度和请求规模选择模型。
它最有用的部分,是把「模型部署在哪里」拆成了模型选择、硬件约束、成本核算和路由执行几个问题。不过,文章没有提供性能实测或成本对照,更适合用来梳理方案,不能直接当作采购依据。
自建模型,先找能完成任务的最小型号
作者建议先通过 OpenRouter 或其他服务试用开放权重模型(open-weight model),找到能可靠完成任务的最小型号,再考虑部署到自己的基础设施。
这里的「开放权重」指训练后的模型权重可供下载和运行。能下载,不代表现有机器就能顺畅运行,更不代表型号越大越适合业务。
参数量描述模型规模。例如,24B 模型大约有 240 亿个学习参数。更大的模型可能能力更强,但也需要更多计算资源和内存。作者给出的升级条件很实际:只有额外能力能让工作流的结果得到可衡量的改善,才值得增加模型规模。
自建系统通常包含五层:
- 硬件提供 GPU 显存和算力,决定能容纳哪些模型,以及响应速度。
- 模型负责具体任务,需要按实际输入和输出要求选择。
- Ollama 或 vLLM 等推理运行时负责加载模型,并通常通过 API 对外提供服务。
- 检索层通过检索增强生成(RAG)查找私有或领域资料,再把相关内容加入模型请求。
- 应用层可以是聊天界面、API,也可以是消费模型结果的工作流。
显存(VRAM)是重要约束。模型权重和运行时需求能够放进 GPU 显存时,计算可以较少依赖速度更慢的系统内存;放不下时,推理引擎可能把数据或计算卸载到系统内存、CPU,性能就可能下降。
量化通过更少的位数表示权重,降低加载模型所需的内存。适度量化可能保留大部分输出质量,压缩过猛则可能影响数值推理等复杂任务。
原文提到了模型清单和最低推荐显存,但提供的正文没有列出具体条目。因此,不能据此得出某个型号需要多少显存的配置结论。
请求该走哪里,先看数据边界,再看能力和成本
自建模型能够帮助控制数据流向,前提是模型和处理请求的工作流都运行在自己控制的基础设施内。
如果只是模型部署在本地,请求处理过程中仍经过外部服务,就不能仅凭「本地推理」判断提示词始终留在内网。
作者把隐私和合规放在路由判断的前面。文章以 GDPR Chapter V 对跨境传输的条件为例,解释为什么部分数据不能随意发往外部提供商。但作者也明确指出:自建不会自动带来合规,访问、日志和存储仍需相应保障;部分提供企业服务等级协议(SLA)的云服务,也可能拥有更强的访问控制和防护措施。
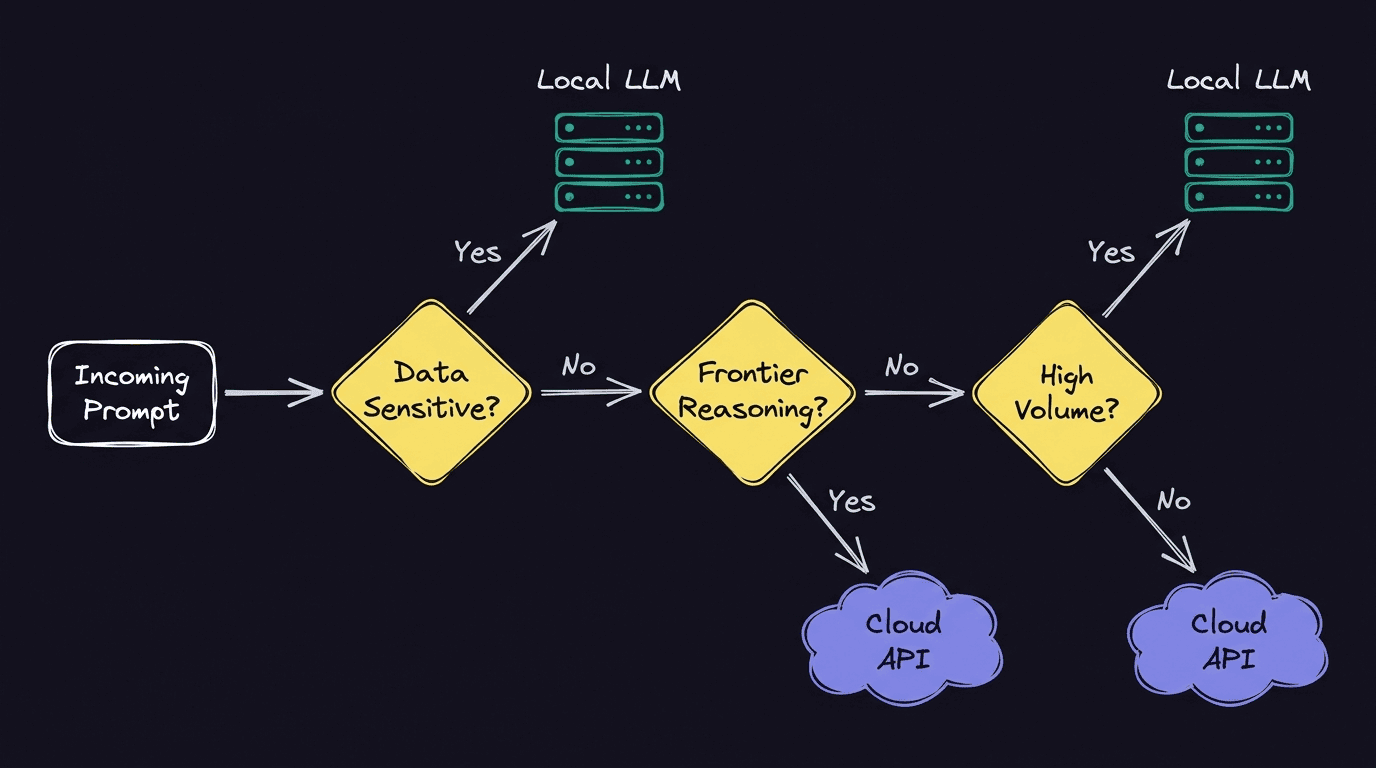
数据允许出网之后,再比较能力、成本与延迟。
云 API 通常按使用量收费,token 越多,账单越高。自建则要承担硬件和运维人员的成本,再把这些成本分摊到请求上。请求量低或难以预测时,云服务可能更经济;请求量大且稳定时,自建才更有机会达到盈亏平衡点。
文章没有给出具体价格、请求量门槛或计算公式。「量大适合自建」在这里是判断方向,还不是可直接套用的结论。
延迟也不能只看部署距离。本地推理省去了访问外部服务的网络往返,但大模型挤在资源有限的机器上,可能比经过优化的云服务慢得多。遇到复杂推理任务,云端前沿模型提供的额外能力,也可能值得接受更高延迟。
因此,路由要解决的是每类请求的实际需求,而不是证明哪种部署方式全面胜出。
n8n 怎样让两条路径共用一套规则
文章后半部分介绍 n8n 的作用:把本地和云端模型连接到同一个工作流,集中执行路由规则。否则,这些判断可能散落在不同应用里,模型和规则增多后,就越来越难检查、修改。
作者建议优先使用已有信息决定路由,例如敏感性标记、任务类型、请求量或复杂度评分。能够直接读取可靠字段,就不必额外让模型猜一次。
接入本地路径时,添加 Ollama Chat Model 节点,并在 Ollama 凭据中填写实例的 Base URL。需要调用工具的 Agent,可以把聊天模型连接到 AI Agent 节点。云端路径则接入 OpenAI Chat Model 或 Anthropic Chat Model 等节点。
之后要区分三种路由方式:
- 同一个 Agent 或链需要按规则切换模型时,使用 Model Selector。它按顺序检查规则,提供第一个匹配的模型。
- 两条路径后面需要执行不同步骤时,使用 If 节点拆分工作流。
- 存在多条分支,而且各自下游步骤不同,使用 Switch 节点。
Model Selector 的规则顺序会直接影响选择结果。一个宽泛条件如果排在前面,后面的细分条件就可能没有机会匹配。
敏感性检查必须发生在请求进入云端模型之前。
如果判断敏感性本身需要读取内容,作者建议先在本地完成检查。先把全文发给云端分类器,再决定是否允许出网,已经错过了控制数据流向的时机。
原文的示例从 webhook 接收数据,依据请求来源切换本地和云端路径;进入云端分支后,再由小型分类模型评估复杂度,为 AI Agent 选择合适的 LLM。
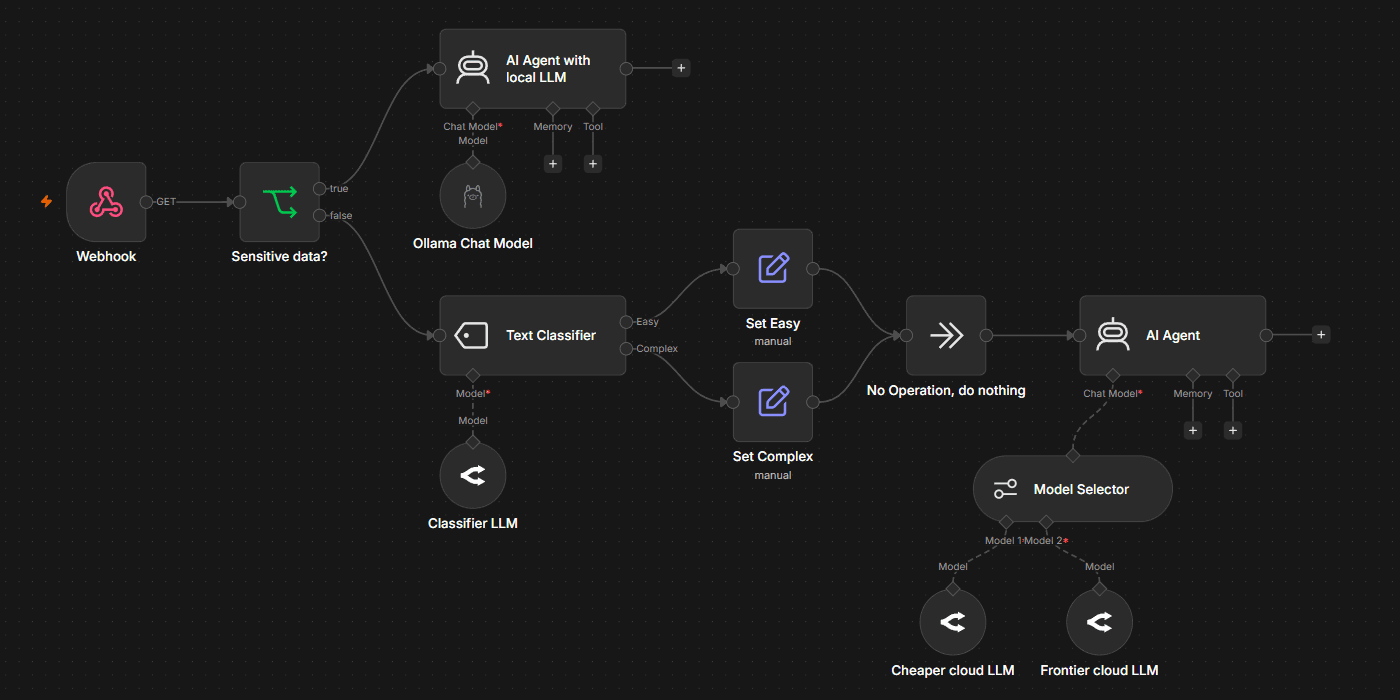
最后要分别运行有代表性的本地和云端请求,检查执行记录。作者特别要求加入敏感测试用例,验证受限数据没有进入云端分支。验证重点是规则有没有按预期执行,而不只是最终有没有生成回答。
我的判断
这篇文章最值得采纳的,是把数据边界放在模型能力之前,并把路由变成可以检查的显式规则。对于同时接入本地模型和云 API 的团队,这比仅凭任务描述临时决定去向更容易核对。
但它也是一篇介绍 n8n 使用方式的产品文章。原文没有展示具体模型、硬件配置、量化等级、并发负载,也没有成本和延迟的对照数据。「小模型通常更快」「稳定大流量可能更适合自建」都有适用前提,不能替代业务测试。
n8n 的价值在于集中展示流程,尤其适合不同分支还要连接其他处理步骤的场景。不过,作者没有证明它一定优于在应用中编写路由逻辑。对于只有少量判断条件的 Node 服务,直接用代码维护规则,也可能更容易融入现有测试和发布流程。应当比较的是维护成本,而不是画布与代码谁天然先进。
另外,原文没有说明本地模型不可用、请求超时或没有规则匹配时怎么办。这些属于实际落地还要补齐的部分,不能把示例图直接视为完整生产方案。
能拿来做什么
- 准备自建模型时,先收集业务中的代表性请求,通过 OpenRouter 等服务试用开放权重模型,筛选能稳定完成任务的最小型号,再评估硬件。
- 在 Node API 或自动化入口整理任务类型、数据来源和敏感性字段,让路由优先读取明确的信息,减少不必要的模型分类。
- 使用 n8n 时,先判断自己需要「同一个 Agent 换模型」,还是「整条处理流程分叉」,再选择 Model Selector、If 或 Switch。
- 为本地和云端路径各准备测试请求,并加入禁止出网的敏感用例;通过执行记录核对实际去向,再评估输出质量、延迟与运行成本。