Flint发布400亿参数本地编程模型
Recursive推出面向本地编程的400亿参数MoE模型Flint,称其借助内部AI研究系统在四个月内完成开发。该系统可自主测试和优化架构,但能否实现持续自我改进尚待证明。
AI 深度解读
Recursive 发布了编程模型 Flint,但更值得关注的是它的研发方式:内部 AI 系统 Eureka Machine 参与提出方案、执行实验、评估结果,再安排下一轮研究。Flint 是这套流程交出的首个公开模型,用了四个月完成开发。
它试图回答两个问题:本地编程模型能否兼顾速度和能力,AI 能否承担更多模型研发决策。目前前一个问题有了厂商公布的成绩,后一个问题还只有初步证据。读这篇报道,关键是分清产品表现、研发自动化和递归自我改进之间的距离。
Flint 的速度优势从哪里来
Flint 采用混合专家架构(MoE),总参数为 400 亿,每个 token 只激活 25 亿参数。可以把它理解为:模型保留较大的参数库,但每次生成只调用其中一部分,从而减少计算量。总参数规模与单次计算量因此可以分开设计。
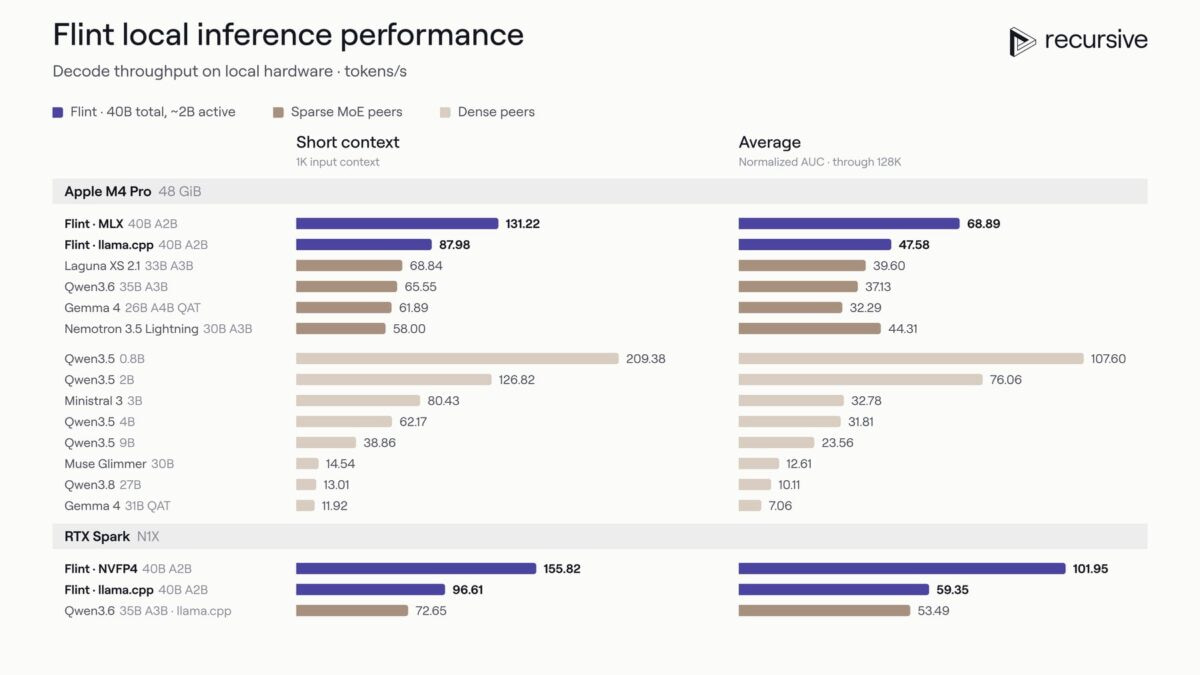
Recursive 希望它达到 250 亿至 400 亿参数稠密模型的能力,同时快五倍以上。稠密模型在计算时会使用全部参数,因此不能只拿总参数量比较两类模型的运行成本。
根据公司公布的数据,Flint 在 MacBook Pro 的 M4 Pro 上,短上下文生成速度超过 125 tokens/s;在配备 64 GB 内存的 Nvidia RTX Spark 上超过 150 tokens/s。与相近 MoE 模型相比,短上下文速度最高约为两倍。这与前面的「五倍以上」采用了不同参照对象,不能混成同一个结论。
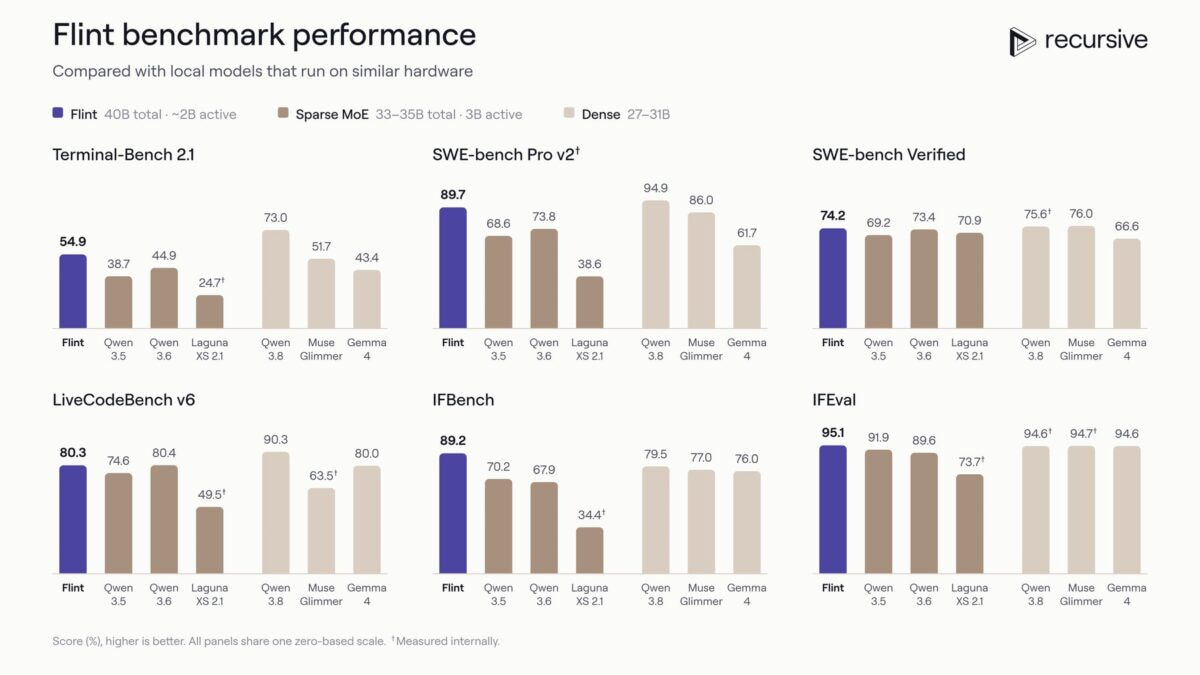
能力方面,公司称 Flint 在 SWE-Bench Pro v2、Terminal-Bench 2.1 和 SWE-Bench Verified 等测试中,领先于总参数少于 500 亿的 MoE 模型,包括 Qwen3.6-35B-A3B 和 Laguna S 2.1。报道同时指出,这些成绩尚未获得独立验证,Qwen 3.8 等稠密模型在部分测试中仍然更高。
另一张对比图显示,在配备 48 GB 内存的 M4 Pro 上,Flint 可以达到一些运行更慢的 270 亿至 310 亿参数稠密模型的基准成绩。
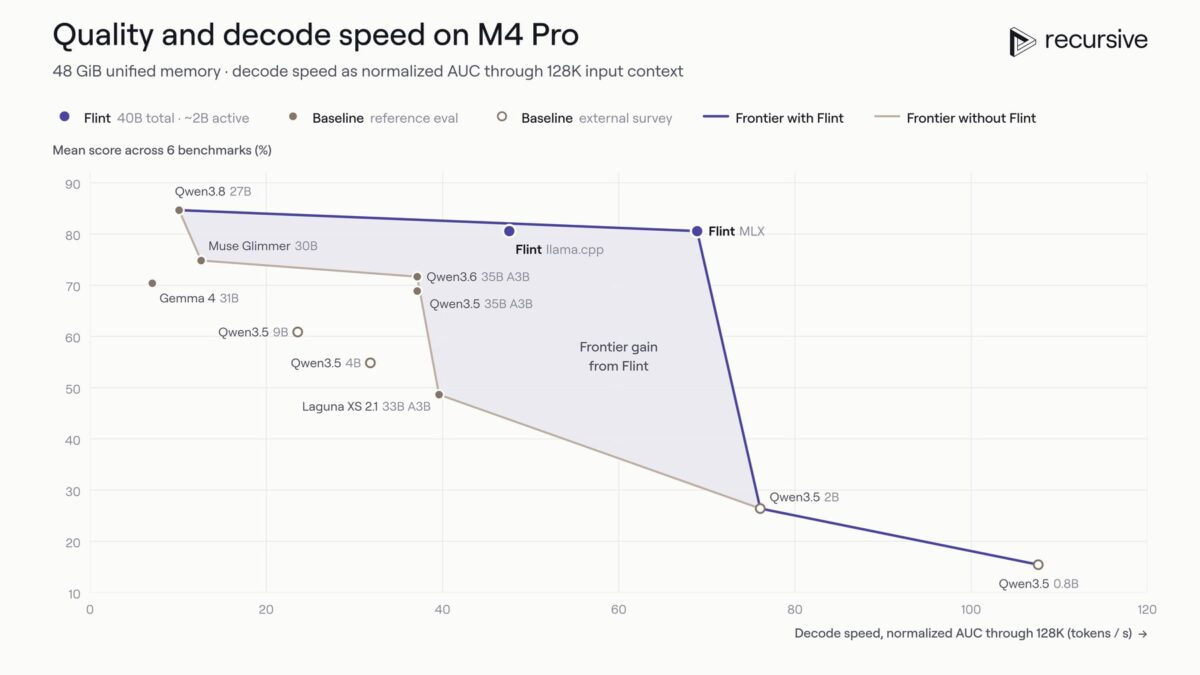
Flint 展示的是特定硬件、测试和上下文条件下的速度与能力取舍,尚不能据此认定它全面领先。
Eureka Machine 到底替研究员做了什么
按 Recursive 的描述,Eureka Machine 会并行尝试多个研究方向,覆盖训练数据、优化器、架构设计和推理调优。报道给出的三个例子,比「AI 研发 AI」这个口号更有信息量。
第一是专家配置搜索。起点是总参数 350 亿、激活参数 30 亿的架构,系统测试了不同配置,最终选出总参数 400 亿、激活参数 25 亿的方案。它并非单纯增加规模,而是在已测试的变体里,寻找编程能力与速度的较好平衡。
第二是量化。系统把输出层也降到了 4 bit,再增加蒸馏步骤,尝试补回精度损失。量化减少参数的存储精度,蒸馏则帮助压缩后的模型学习参考模型的输出行为。公司称,这套方法需要的训练步数约为此前方法的一半,最终 NVFP4 版本在基准上的成绩仅比 16-bit 版本低 0.7 分。
这里缺少更细的实验说明:报道没有交代「此前方法」的完整配置,也没有解释跨基准的 0.7 分如何汇总。它能说明公司报告了一个结果,还不足以让其他团队直接复现收益。
第三是底层计算优化。Eureka Machine 为 Apple Silicon 和 Nvidia RTX Spark 构建专用计算内核。在 Apple M4、M5 上,Metal megakernel 将 token 生成阶段的整个前向传播合并成一次操作。
这部分很关键:Flint 的速度来自架构、量化和硬件执行方式共同作用。只比较模型参数,很容易漏掉推理实现带来的差异。
能跑在本地,离独立完成复杂任务还有多远
Flint 的权重以 Apache 2.0 许可证发布在 Hugging Face,支持 llama.cpp、Ollama、LM Studio、vLLM 和 SGLang。Recursive 还提供了面向 Apple Silicon 的自有推理引擎 rec。
上下文窗口最高支持 512,000 tokens,但公司建议限制在 256,000 tokens。这个差别应该保留:最高支持长度,并不等于日常使用的推荐长度;短上下文的速度,也不能直接外推到长上下文。
对程序员来说,本地运行的直接价值是可以在设备上处理代码,无须把代码发给外部服务器。不过,现有工具链是否还有其他联网环节,仍要看具体配置。
公司也承认,面对复杂任务,Flint 比大型闭源编程模型需要更多指导,并建议把大任务拆成小步骤。对日常 AI 编程,这会影响实际成本:生成速度快,并不保证整个任务完成得快。如果需要更多轮提示、检查和返工,单看 tokens/s 就容易高估收益。
我的判断
我认为,这次发布更有说服力的部分,是 AI 参与了一组具体研发决策,并产出了可下载的模型。架构配置、输出层量化、专用内核,都比笼统宣称「研究自动化」更容易接受检验。
但「能参与研发」与「能持续改善自身研发能力」之间,还有一道未被证明的因果关系。
Recursive 由 Richard Socher、前 DeepMind 研究员 Tim Rocktäschel 等人创立,2026 年 5 月结束隐身状态,融资 6.5 亿美元,估值 46.5 亿美元。这些信息能说明投入规模,不能代替技术验证。
公司设想,每一代新模型都让 Eureka Machine 成为更好的研究员,再加速下一代模型开发。要证明这件事,需要展示新模型确实改善了研究系统的表现,而不只是展示它产出了一个模型。
报道提到,对超过 700 份任务日志的研究发现,AI 承担了大量工作,但多数关键研究判断仍由人类完成。Anthropic 和 OpenAI 也在使用 AI 参与模型研发,自动化究竟走到哪一步,仍有争议。Oriol Vinyals 认为 AI 辅助自我改进具有现实可能,但不看好智能爆炸,研究创意与可靠评估仍是难点。
Flint 是自动化研究的一个具体产物,还不是递归自我改进已经成立的证据。
与人工主导、AI 辅助实验的常见方式相比,Eureka Machine 声称接管了更多决策;但报道没有提供受控对照,无法判断它究竟节省多少研发时间、算力或人力。四个月是开发周期,不是自动化收益的对照数据。
能拿来做什么
- 如果你已有本地编程模型工作流,可以用 Flint 测试同一组真实任务,例如修复前端缺陷或修改 Node 模块,同时记录完成质量、耗时和人工介入次数。
- 评估本地速度时,分别测试短上下文和实际项目输入长度,并记录硬件、量化版本与运行时,避免把超过 125 tokens/s 的厂商数据直接当作自己的预期。
- 使用 Flint 处理复杂修改时,可以按公司建议拆成小步骤,每一步给出明确目标和验证方式,再观察额外指导是否抵消了生成速度的优势。
- 阅读下一次「AI 自己研发 AI」的发布时,可以追问新模型是否让研究系统更会选实验、更可靠地判断结果。这比只看新模型的排行榜位置更接近递归改进的核心。