排查智能体故障,别只修改提示词
文章把智能体视为带有不确定性组件的分布式系统,将故障分为工具边界、返回数据、模型决策、副作用和循环控制五类。超时、数据截断、重复写入等问题,需要超出提示词层面的工程处理。
AI 深度解读
Agent 出错后,补一条 system prompt 很容易,判断错因却更重要。这篇文章转述 Tommy Tran 在 ACM Queue 于 2026 年 10 月 15 日发表的论文:Agent 是一个包含不确定性组件的分布式系统,许多故障应该由执行框架处理。
它值得读的地方,是把「模型犯傻」拆成了可定位、可治理的问题。不过,证据来自注入故障的玩具 Agent,不能直接推导出生产环境里大多数失败的占比。
先看故障发生在哪,再决定要不要改提示词
Agent 的运行过程是一个循环:模型提出动作,执行框架(harness)调用工具,结果再交回模型。框架承担协调工作,依赖的服务和网络却不受它控制。原文认为,这与分布式系统过去 40 年处理的问题有大量重合。
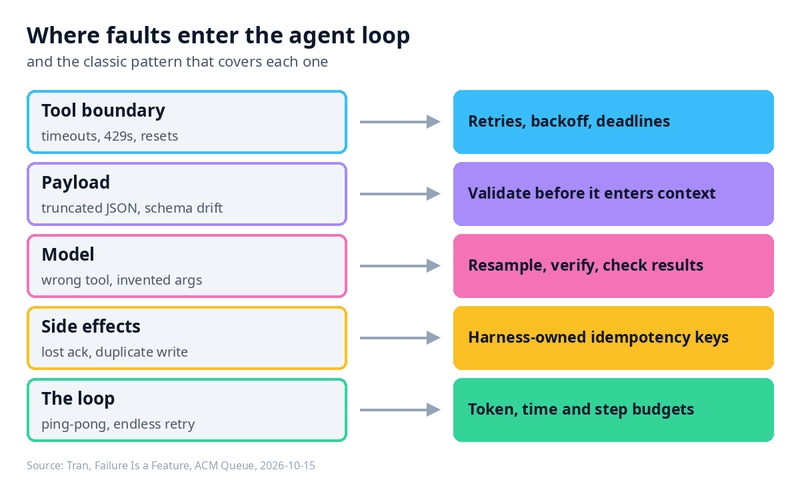
作者把故障入口分成五类:
- 工具边界会发生超时、429 和连接中断。
- 返回载荷可能是截断的 JSON、HTML 错误页,或者已经变更的数据结构。
- 模型可能选错工具、编造参数,或者没验证就宣布成功。
- 副作用可能已经发生,但确认消息丢失,重试便重复执行。
- 循环本身可能失控,例如两个工具来回调用、整晚重试失效 API,或者耗尽上下文。
其中,第三类直接指向模型行为。其他几类通常需要先检查调用、校验和执行控制。
例如,原文用余额从 "balance": 1000 被截断成 "balance": 1 说明风险:数据看起来仍然能被理解,模型便可能继续推理。请求返回了内容,不代表业务数据完整。执行框架需要设置明确的验收条件,不能把所有返回内容直接交给模型解释。
重试、去重和停止条件,应该由谁负责
模型负责决定做什么,执行框架负责控制一次动作怎样可靠地执行。
原文最具体的建议,是让框架生成幂等键(idempotency key)。它相当于操作凭证:同一个动作重发多次,接收方据此识别重复请求,避免重复退款等副作用。
下面这段代码解决的是同一步骤重试时,幂等键必须保持一致的问题:
def run_side_effect(task_id, step_id, tool, args):
    key = f"{task_id}:{step_id}:{tool}"  # same on every retry of this step
    return call_with_retries(tool, {**args, "idempotency_key": key})
要看的是 key 的来源:它由框架控制的 task_id、step_id 和 tool 组成,并覆盖参数中的 idempotency_key。如果让模型自己填,重试时换一个值,去重就可能失效。
但这段代码有边界。模型重新规划、再次提出动作时,会获得新的 step id;原文把它视为新决策,而非旧请求重发。因此,它解决的是步骤内重试去重,不能自动消除跨步骤的业务重复操作。接收方也必须实际支持幂等处理。
第二条建议是给任务同时设置时间、token 和步骤上限,并在每个新步骤开始前检查。原文举的例子是:让任务在第 20 步带着明确原因失败,避免整晚调用已经失效的 API。20 是示例,不是通用推荐值。
第三条是把瞬时错误的重试留在框架里,通过退避和随机抖动控制请求间隔。模型只接收最终结果或类型明确的失败,否则每次重试都消耗 token,还会把上下文塞满错误叙述。
依赖持续不可用时,熔断器可以返回 {"error": "circuit_open", "retry_after_s": 30},让模型知道当前依赖暂时不能使用,再决定后续路径。
我的判断
我认同这套职责划分。对会调用工具、修改外部状态的 Agent,只改提示词无法保证请求不重复,也无法阻止无限重试。与单纯增加重试相比,幂等控制和执行预算能限制故障扩散。
但「多数失败不是幻觉」在这份材料里,仍缺少足够完整的统计支撑。原文提到固定故障配置下的实验,以及其他模式带来的额外 6 个百分点,却没有展示完整结果、指标定义和基线,无法据此判断收益大小。
实验也给出了反例:故障随机出现时,熔断器反而降低了任务成功率;依赖真正持续宕机时,它才更有价值。可见,治理机制需要匹配故障形态,不能整套照搬。
原文借 tau-bench 强调,单次成功率容易掩盖连续执行的不可靠:需要连续成功八次时,整体表现会更脆弱。这个提醒成立,但材料没有给出对应成功率,也没有展开各次失败是否相关,不能直接计算八次执行的结果。
能拿来做什么
- 在 Node 工具调用层区分网络错误、载荷错误和模型决策错误,给响应增加结构校验,再决定是否把结果交回模型。
- 为会写入外部状态的工具固定步骤内的幂等键,并确认服务端支持去重;同时单独检查重新规划后重复提交同一业务动作的情况。
- 给日常 AI 编程任务配置时间、token 和步骤预算,让终止原因进入日志,方便区分正常失败与循环失控。
- 评估 Agent 时保留连续多次运行的结果,并注入超时、429、异常载荷和确认丢失等故障;除了成功率,也检查是否产生重复副作用。