
8.0
热点
AI SCORE
编程提效2026-09-19 22:00
SpaceX 工程师月均 2000 条 PR 背后的验证工程实践
The New Stack#工程实践#AI编程#DevOps
Editor brief · 编辑速览
曾任职 Cursor 和 Meta 的 Lauren Tan 在 SpaceX Grok 团队分享高吞吐 PR 策略:验证环节是支撑 2000 PR/月的关键工程能力。
Lauren Tan 是 SpaceX AI 旗下 Grok 团队的工程师,此前曾在 Cursor 和 Meta 工作。她最近发布了一份个人 Agent 工作流 pstack 的指南。其中最引人注目的数据是:pstack 使她能够每月向生产环境推送 2000 个 Pull Request(PR),且信心十足。这意味着一位工程师在每个工作日几乎能推送将近 100 个 PR。
这个数字令人惊叹,不可否认属于极端个例,但方向并不令人意外。我此前曾论证过,编程 Agent 将使团队在人数不变的情况下产生十倍的代码。真正令人惊讶的是,这些不仅仅是代码输出数字——这些是实际落地到生产环境的变更。
据 Tan 所述,该工作流最关键的环节是验证(verification)。一种验证技能让 Agent 能够检查自身的工作成果,并持续迭代直到任务完成。她将其视为"关键基础设施",而非众多技能之一。
验证技能背后依赖的是一项更底层的能力:一个丰富的运行时,Agent 可以驱动它、检查它,并从中获得结构化的答案。对于单个应用来说,这个运行时就是应用本身,按需启动。对于由数十甚至数百个服务组成的系统,默认情况下并不存在这样的运行时,而提供一个能够跟上数百个并行 Agent 步伐的运行时,正是困难所在。
验证是整个环节的核心,数学逻辑也证明了这一点
她关于 Agent 式验证的论证本质上是一个吞吐量论证。一个能够检查自身输出的 Agent 会持续工作直到任务完成;一个只能给你一个 diff 然后等待的 Agent,会让你成为整个环节中最慢的组件。正因如此,她声称强大的验证技能可以将团队产出放大 100 到 1000 倍。
"一个能够检查自身输出的 Agent 会持续工作直到任务完成。一个只能给你一个 diff 然后等待的 Agent,会让你成为整个环节中最慢的组件。"
以每月 2000 个 PR 计算,如果每月全勤工作,手工审查每个变更平均每个 PR 只有约 5 分钟的时间。人肉审查在这种体量下不可能成为验证层。无论什么来执行检查,都必须无需人员介入即可运行,且必须与生成工作的 Agent 并行执行。
该模型假设 Agent 可以运行整个应用
她描述的验证技能会为应用生成一个命令行界面(CLI)和一张特性地图。CLI 让 Agent 能够启动应用、导航操作、检查状态,并读取结构化的 JSON 结果返回。每个 Agent 都获得一个完整的应用副本,并能对变更进行端到端测试。
她毫不讳言这个运行时有多重要:"我个人认为 Agent 式验证极其重要,以至于我会认真地建议自己去构建丰富的调试工具,甚至更换技术栈,以在软件构建中获得不公平的优势和极致的生产力。"
她的方法之所以有效,是因为应用本身是单进程的。前端、编译器,或带有数据库的单个服务,都可以在几秒内从 CLI 启动,并在用完后丢弃。
"我会认真地建议自己去构建丰富的调试工具,甚至更换技术栈,以在软件构建中获得不公平的优势和极致的生产力。"
对于构建复杂分布式应用的团队来说,他们的系统并不具备这个特性。应用是订单服务、支付服务、库存服务、一个队列、若干数据库和若干第三方 API 之间交互的总和。在更大的厂商那里,服务数量可能达到数千。一个针对某个服务的 PR,只有在触发它发出的调用和接收的调用时才能得到验证。CLI 可以启动变更后的服务,但无法启动整个系统。
现有运行时都无法在数百个并行 Agent 下存活
带 Mock 的本地运行时成本低廉,可以借助 worktree 或 CDE 实现完全并行。问题在于保真度(fidelity)。Mock 编码的是上一次有人查看时依赖项的行为,一旦真实服务发生变化,Mock 就会漂移(drift)。一个基于 Mock 进行验证的 Agent,实际上是在对虚构之物闭环,失败只会在合并之后才显现出来。
每个变更对应一套完整栈的副本既保真又隔离。但其成本随服务数量乘以并发变更数量的乘积而增长,在数百个 Agent 的场景下成本难以承受。时间是更大的问题。完整栈需要数分钟才能完成配置,而她描述的闭环需要 Agent 在仍在处理某个变更的期间反复测试。如果环境在 Agent 已经转向下一次尝试时才就绪,那对 Agent 毫无用处。
共享预发布环境(staging)既保真又廉价,因为只有一套,这就是全部问题所在。单个可变环境无法承载数百个并发变更。Agent 之间会相互覆盖彼此的部署,一个 Agent 的破坏性变更会成为所有其他 Agent 的测试失败,使工作流赖以成立的那个闭环属性荡然无存。
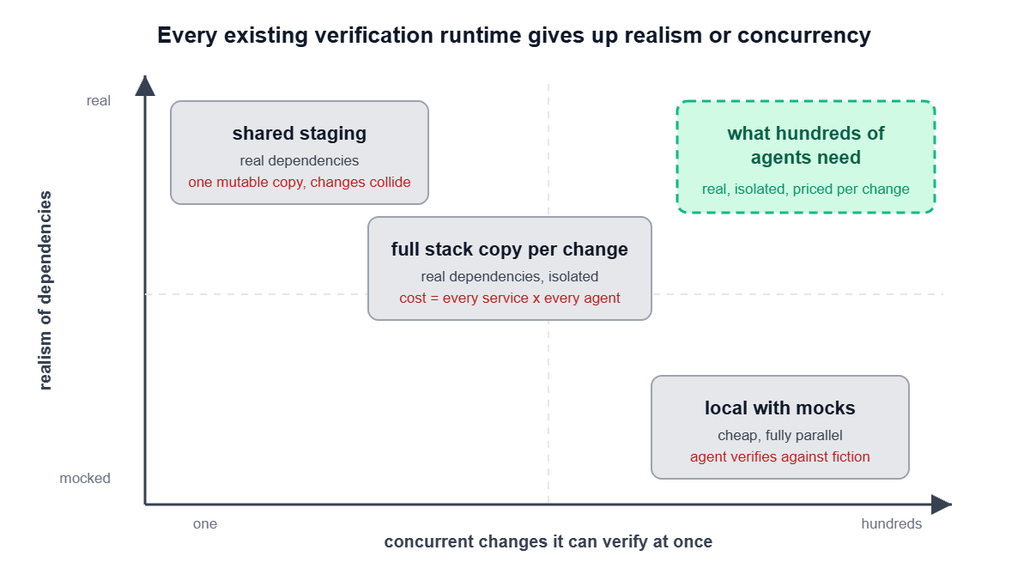
当调用方是 Agent 时,验证需要什么
把 Lauren 的工作流当作需求文档来阅读,会浮现出五个属性:
变更必须针对真实依赖项运行,否则验证毫无意义。
数百个并发变更之间必须互不可见。
环境的成本必须随变更的规模增长,而不是随系统的规模增长。
环境必须在数秒内就绪,因为 Agent 如果在等待配置的过程中空转,那等于为未使用的并行性付了费。
所有这一切都必须可通过 Agent 已在使用的 CLI 或 MCP server 触达,因为调用方是 Agent。
第一条和第三条需求朝着相反的方向拉扯。保真度要求完整副本。成本压力要求尽可能共享。共享预发布环境通过放弃隔离来化解这个矛盾;每个变更对应完整栈则通过放弃成本效率来化解。同时满足全部五条需求的设计,必须既共享又隔离。
虚拟化全栈环境共享系统但隔离变更
实现这一点的架构将环境视为一个运行中系统的视图(view),而非副本(copy)。一组共享的稳定服务持续运行,从主分支部署,以生产环境的运维方式保持健康。当某个 Agent 需要验证一个变更时,它只需运行自己修改的那个服务——可以在本机上运行,也可以作为集群中的轻量级部署——然后将其加入到共享栈中,作为一个全新的隔离环境。
"实现这一点的架构将环境视为一个运行中系统的视图,而非副本。"
在这个环境内部,变更后的服务是记录在案的版本,而其他所有调用都会穿透到共享的稳定版本。Agent 看到的是一个完整、真实的系统,其他一百个 Agent 也是如此——每个 Agent 看到的系统与基准线的差异,仅限于其自身变更的增量。当请求跨越服务边界时,会携带其环境标识,这确保了一个 Agent 的流量不会到达另一个 Agent 的待测版本。对于无法安全共享的有状态副作用(如队列主题或可写数据库),会在需要的地方生成每个环境一份的副本。
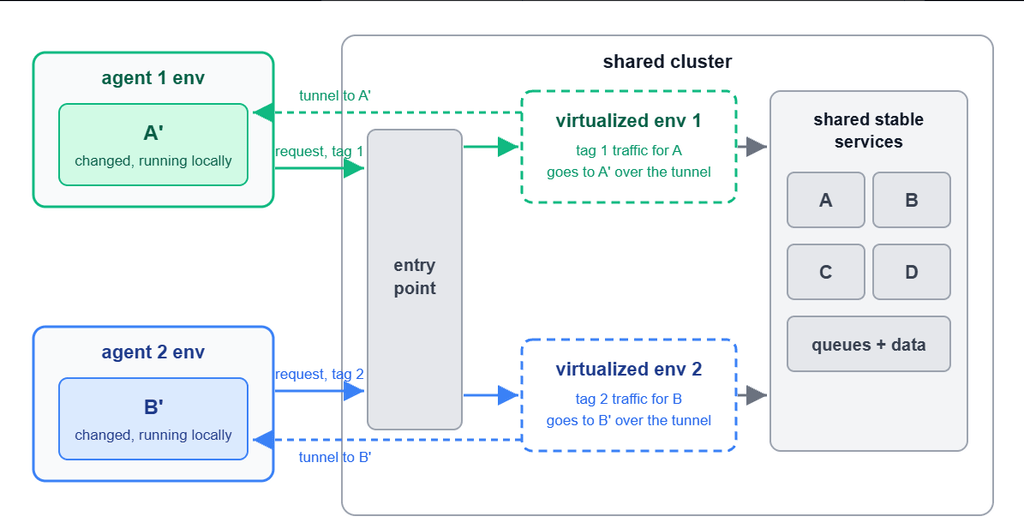
成本模型随之而来。一个环境的成本是一个或两个运行中的服务,而非六十个;它在单个服务启动所需的时间内就绪,而且可以在 Agent 自身的工作流循环内创建和销毁。这正是 Signadot 为 Kubernetes 打包的模式,共享稳定栈运行在团队现有的集群中。
端到端的完整闭环,以 Agent 作为执行者
把两个部分合在一起看,使得她每月能向生产环境推送 2000 个 PR 的工作流,几乎可以不加改动地迁移到分布式系统。Agent 领取一个任务并修改其中一个服务。它为这个变更请求一个环境,并在其服务启动所需的时间内获得一个。随后它通过系统入口点驱动真实请求,观察请求在真实依赖图中的遍历过程——只有自己的服务运行着新代码。它读取结构化结果,修复失败的部分,然后再次运行。当检查通过时,它打开 PR,环境在合并时消亡。
"环境不再是平台团队分发的东西,而是变成 Agent 按需创建、使用和丢弃的东西。"
对于平台团队来说,工作的基本单位发生了变化。今天它负责配置环境——无论是保持共享预发布环境存活,还是为其压印完整副本。在这个模型中,它运行一个共享稳定栈和虚拟化它的那一层:跨每个服务的上下文传播、无法共享的有状态依赖项的隔离机制,以及创建和销毁环境的工具。环境不再是平台团队分发的东西,而是变成 Agent 按需创建、使用和丢弃的东西。
验证容量是吞吐量的新上限
Lauren Tan 的这篇文章不是一个关于一位异常高产的工程师的故事。它展示的是当 Agent 运行完整闭环时会发生什么——自己写变更、自己验证、中间无需人员介入。验证基础设施是整个闭环所依赖的基石。
在分布式应用中,这个基础设施必须是一种运行时环境:它给每个 Agent 提供真实依赖项、保持数百个并发变更之间互不干扰、按变更而非系统副本收费、以及在 Agent 愿意等待的数秒内就绪。这才能将 Agent 的并行性转化为已推送的代码,而非更长的审查队列。这种运行时环境的模型正是我们构建 Signadot 的目的。