
8.0
热点
AI SCORE
技术实践2026-09-19 19:08
Google Dream-RSI:AI Agent 通过梦境回溯优化搜索策略
The Decoder#Agent#DeepMind#搜索优化
Editor brief · 编辑速览
Deepmind 提出让 AI 在历史搜索轨迹上「做梦」来测试新策略,无需真实重算即可改进。测试中迭代次数最多降低 2.43 倍。
Google 和 Deepmind 的研究者们开发了一种新方法,可以帮助 AI Agent 更高效地处理复杂搜索任务。该方法利用过往的搜索记录来测试新策略,无需重复昂贵的计算。
能够自我改进的 AI Agent 未来应当能够自主发现新算法、解开数学问题,或写出更快的代码。它们遵循相同的基本流程:提出方案、评估结果、从结果中学习、然后再试。经过数千次尝试,它们逐步趋近于一个好的结果。
对于复杂任务,搜索空间会变得极其庞大。Agent 必须不断决定哪些有希望的方案值得追求、哪些可以并行尝试、哪些应该放弃。这个被称为「探索」的过程,决定了搜索是成功还是浪费算力去追逐错误的方向。
Google 和 Deepmind 的一个研究团队推出了「Dream-RSI」,用于改进这些决策。该方法改变的是 Agent 的搜索方式,而非底层 AI 模型。
现有方法处理探索的方式总体上有两种。固定搜索策略无法从经验中学习,因此 Agent 可能会反复撞上同样的死胡同。在搜索过程中自适应调整策略可以避免这种僵化,但代价不小——需要大量尝试才能判断某个策略是否有效,而测试无数种替代方案则意味着重复那些耗时且昂贵的完整运行。
研究者们提议复用已完成搜索的数据,在 Agent 已经探索过的空间内测试替代策略。Agent 在搜索时记录其尝试及结果,这些数据日后可用于回放那些决策。
研究者将此比作在一片陌生区域中找路。初次造访时,你会撞上死胡同、折返、艰难地寻找路线。但一旦你有了 mental map,就可以规划另一条路线,而无需再次造访每个地点。
Dream-RSI 将这一原则应用于记录的搜索历史。Agent 不是在真实运行中测试新策略,而是针对存储的结果运行它。这让它能够检查:如果当初优先追求其他方案或放弃某些早期选择,会发生什么。该系统在回放过程中不会发明全新的解决方案;它只是在已记录的搜索树中测试不同的决策。
由于所有结果都存储在搜索树中,Agent 可以在不再调用模型或评估器的情况下测试数千种替代策略。
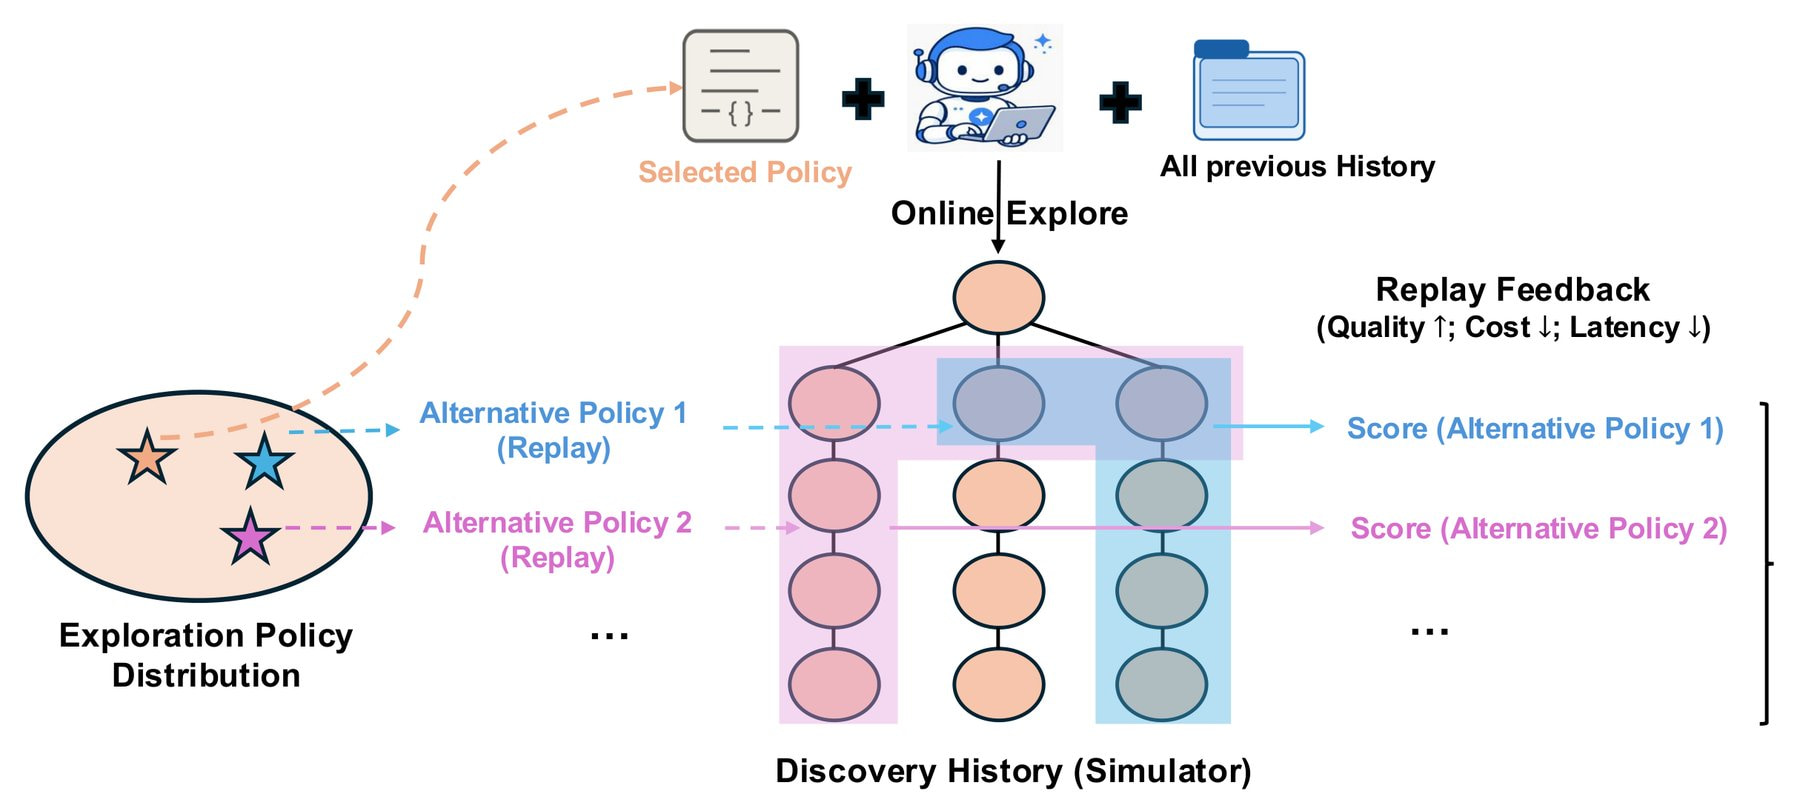
由于这些结果已然存在,Agent 无需再次生成或评估解决方案,避免了真实运行所需的高昂计算成本。这使得测试新搜索策略的成本大大降低。研究者将这一过程称为「做梦」。Agent 在其中演绎数千种变体,选择最佳方案后,再将其投入到真实搜索中使用。
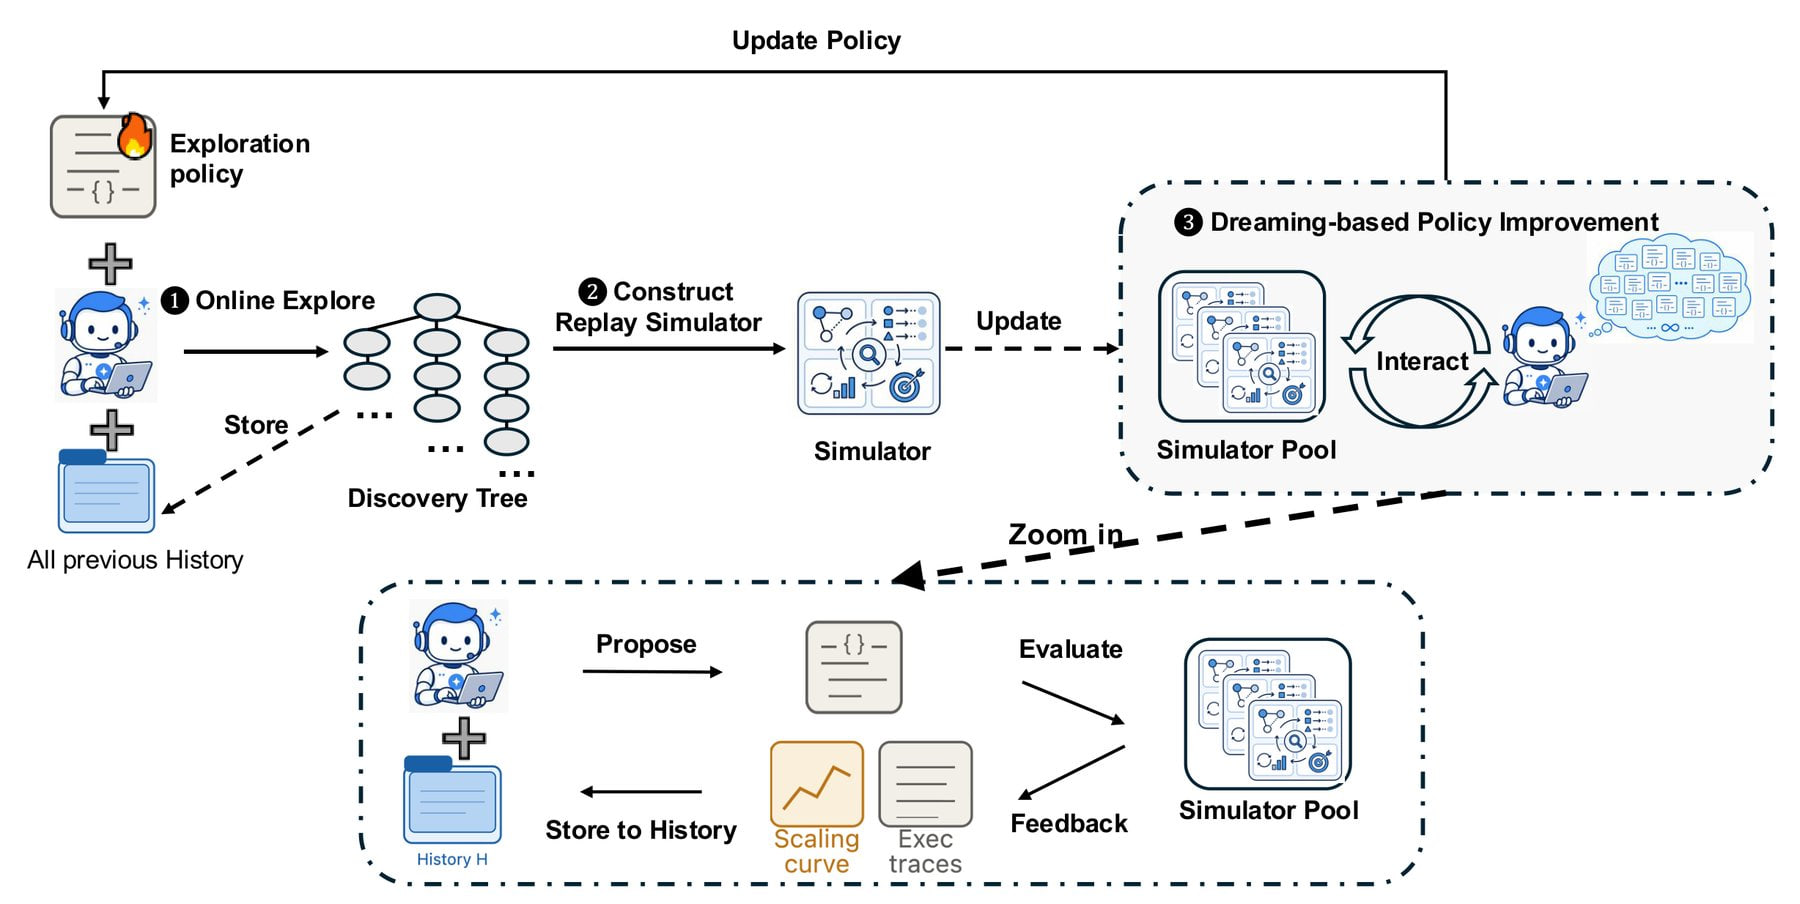
这个过程以循环方式重复。每次搜索后,Agent 利用记录的结果测试更好的策略,然后将改进后的版本应用于下一次真实搜索。在这个循环中,只有搜索策略发生变化;生成解决方案的模型本身则纹丝不动。
Dream-RSI 在真实搜索与已记录搜索历史的回放之间交替进行,在下一轮中使用改进后的策略。
研究者在八个任务上对 Dream-RSI 进行了测试,涵盖三个领域,使用 Gemini 3.1 Pro 和 Gemini 3.7 Flash 作为模型。每次对比都采用相同起始条件但使用固定搜索策略的基线。
有一项任务要求系统为基因组学和金融中常用的统计计算写出尽可能快的程序。Dream-RSI 生成的程序在全部六个测试数据集上均比 established 库 sklearn 和 glmnet 运行得更快。
使用 Gemini 3.1 Pro 时,平均运行时间从 3,587 毫秒降至 2,931 毫秒,同时尝试次数从 550 次降至 317 次。Dream-RSI 还击败了竞品系统 SimpleTES——后者需要 51,200 次运行,而 Dream-RSI 仅需 317 次。
习得的策略首先减少尝试次数,当进展停滞时再增加尝试量。
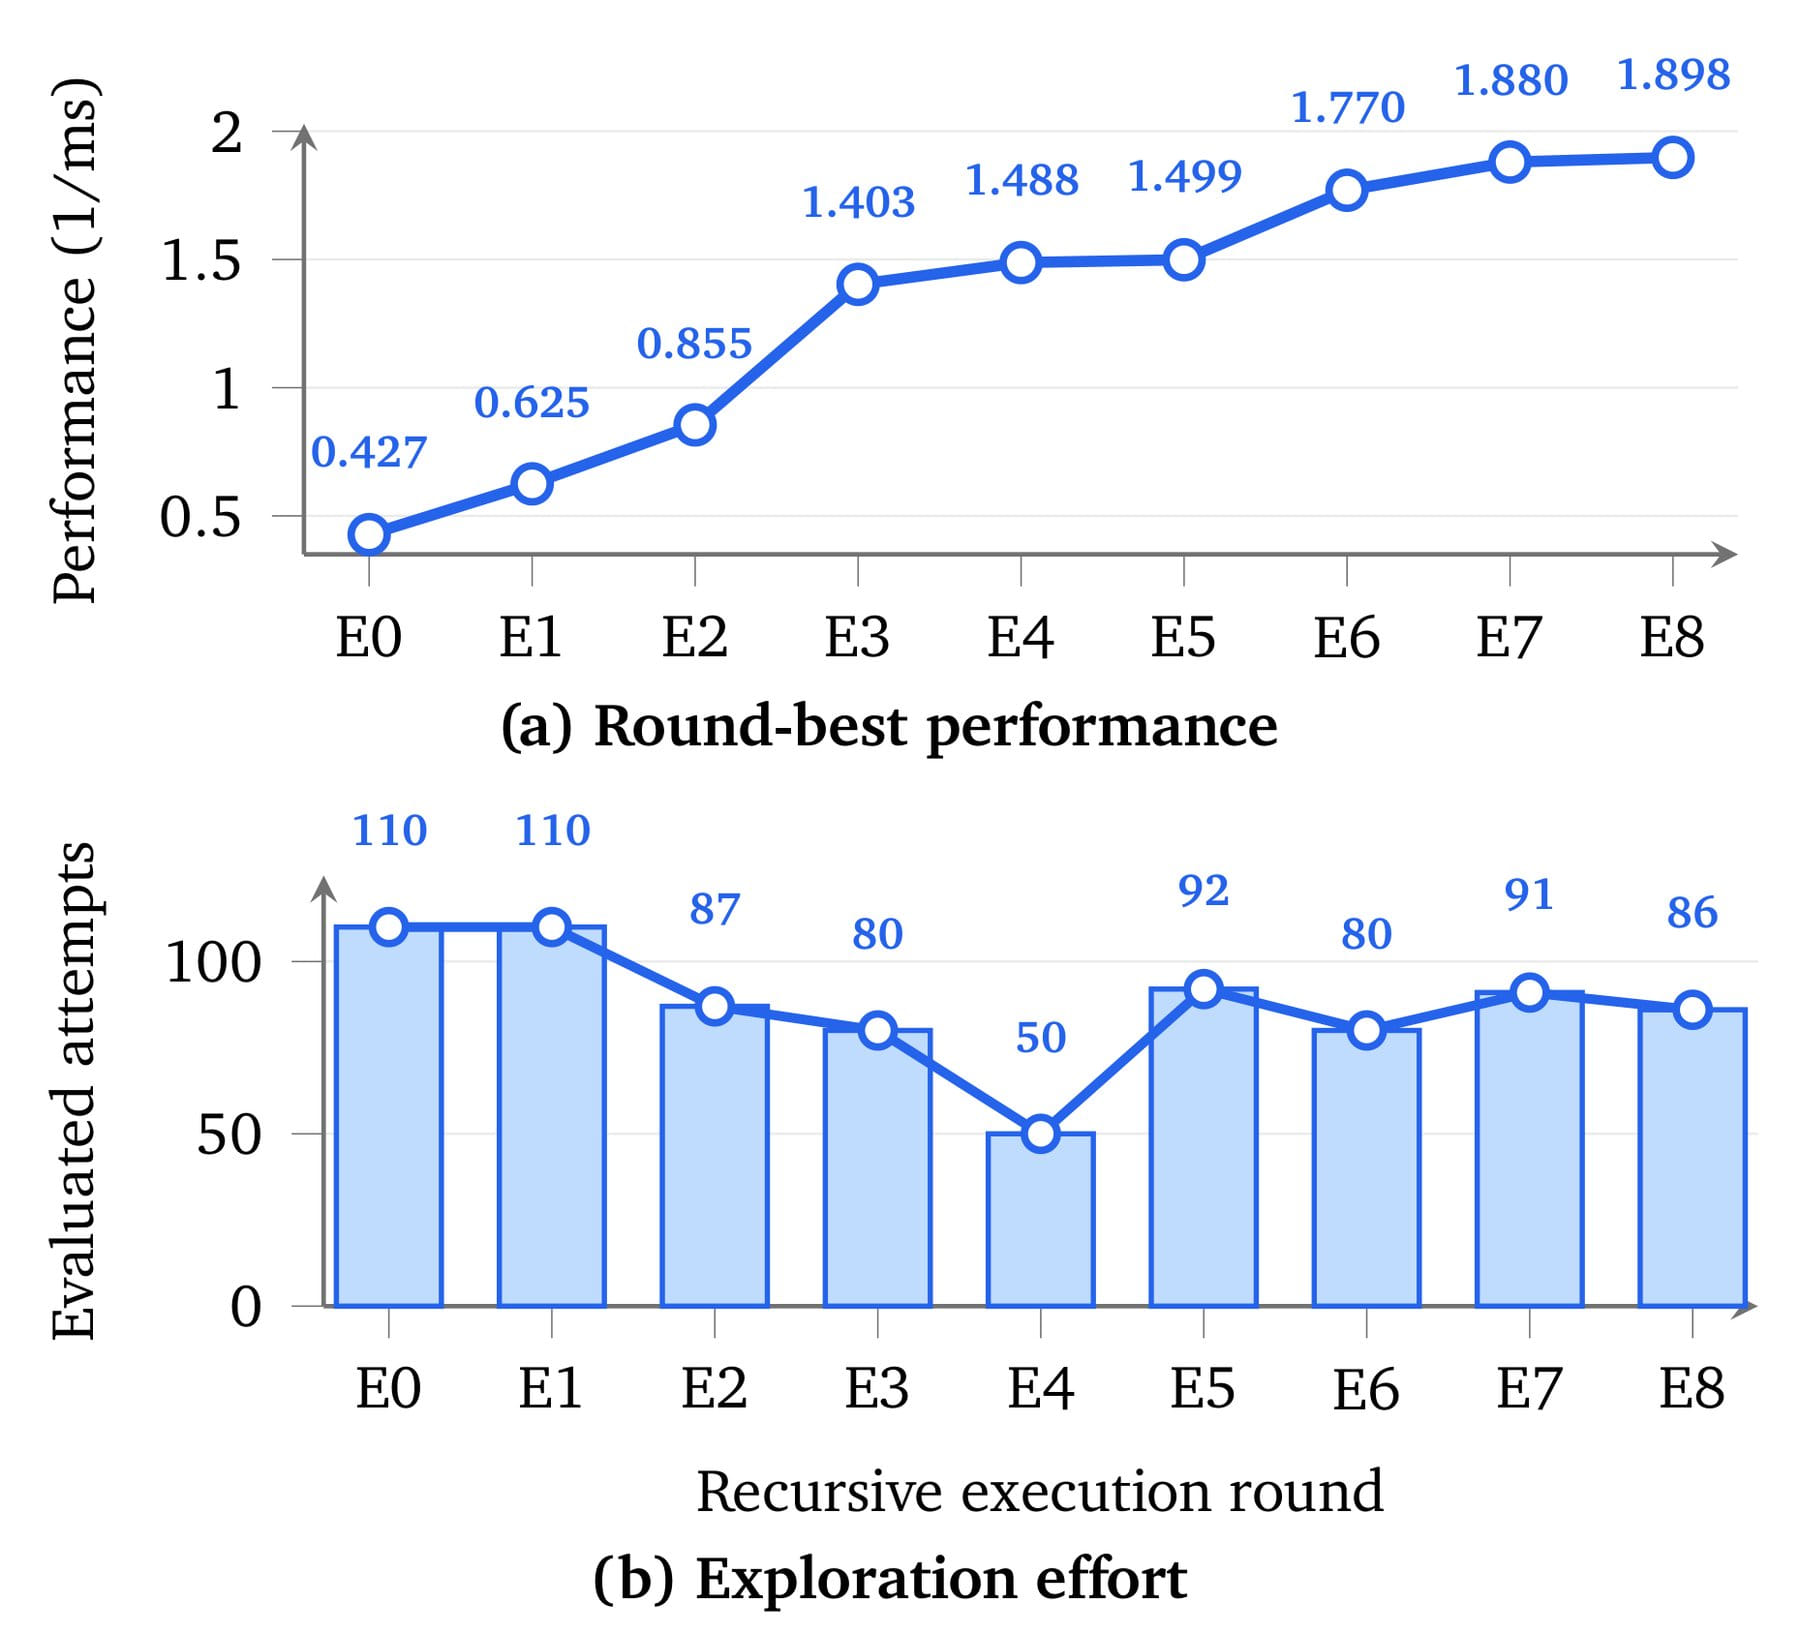
在数学优化任务和高效 GPU kernel 编写工作中也呈现同样模式,以更低计算成本取得了相当或更好的结果。在两个 GPU 任务上,Dream-RSI 在将运行次数减少最多 2.43 倍的同时达到了相同性能。在另外两个任务上,它在相同预算内实现了最高 2.09 倍的性能提升。
在 GPU kernel 任务上,Dream-RSI 以最多 2.43 倍更少的生成次数达到相同性能,或在相同预算内实现最高 2.09 倍的性能提升。
在后续分析中,研究者测试了另一种利用搜索历史的方式。他们没有通过回放来测试策略,而是将其压缩成指令,告诉 Agent 应该在哪里搜索。
在其中一个 GPU 任务上,带有这些指令的版本表现反而不如没有指令的版本。研究者认为,过于具体的指示会过度压缩搜索空间,阻止 Agent 探索更广泛的方案。
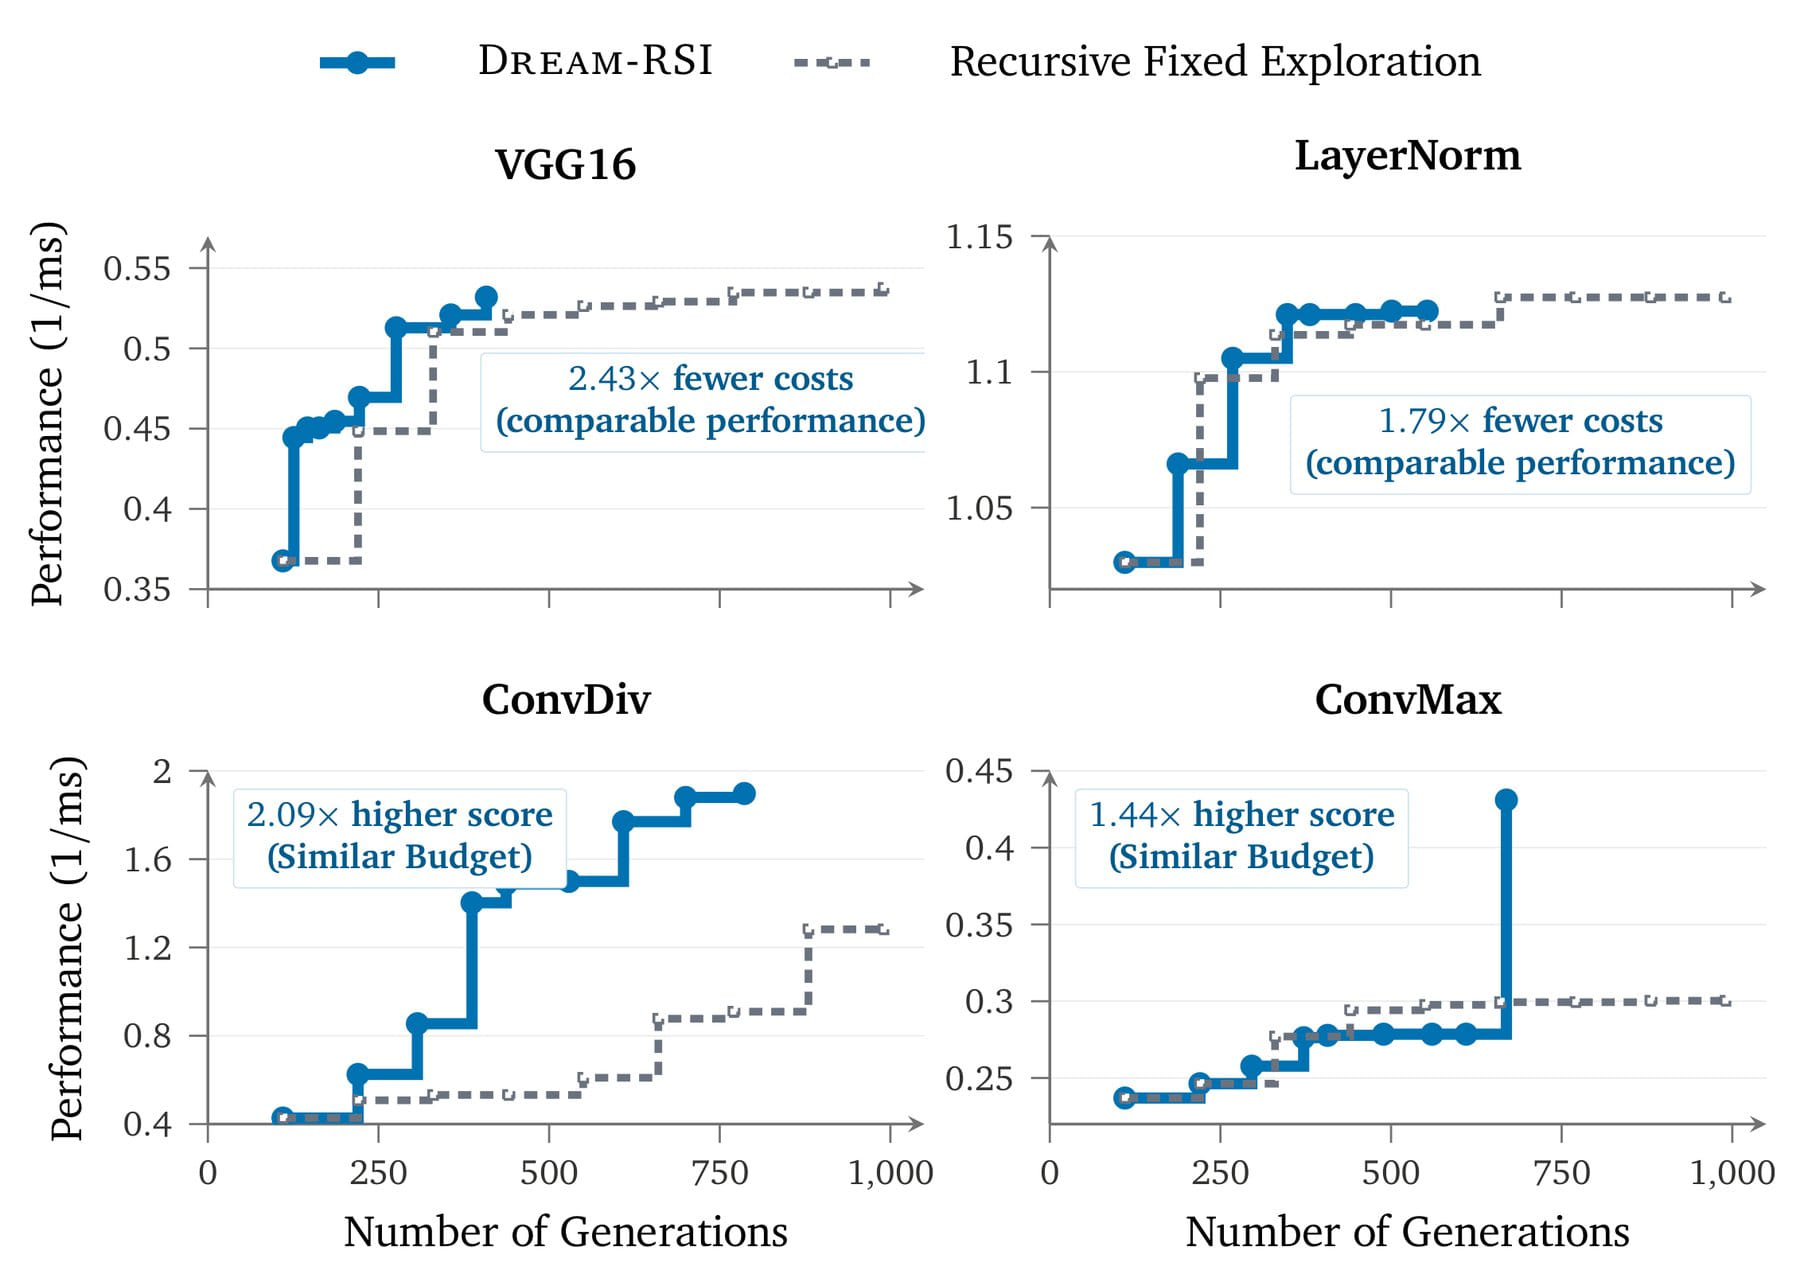
同一分析还展示了习得策略如何调整其投入力度。随着性能提升,它首先减少了尝试次数;当进展停滞时,它再次增加了搜索投入,而这恰好伴随了进一步的收益。研究者已在 GitHub 上分享了代码和更多细节。
递归自我改进近来引发了越来越多的关注。该领域的进展正是 Anthropic CEO Dario Amodei 最近对 AI 研究速度发出警告的原因之一。
Google Deepmind 于 2025 年推出了 AlphaEvolve,使用了相同的基本原理。Gemini Flash 生成代码提案,Gemini Pro 分析它们,进化算法选择最佳版本。Dream-RSI 在此基础上又提升了一个层次——它优化的是搜索策略本身。
AutoTTS 采用了类似方法,使用 coding agent 在模拟环境中搜索算法。这些算法决定 LLM 何时应该开始、扩展或放弃推理路径。结果显示,这些方法以更少的算力击败了手工设计的方法。
Google Research 最近展示了另一种复用过往运行的方式——WikiSkill。该系统在 wiki 中记录失败与成功,并将其转化为可供 Agent 重用的指令。Dream-RSI 的后续分析表明,此类显式指令在开放性搜索任务上可能限制探索。
Meta 更进一步,推出了 Hyperagents,允许 Agent 重写控制自身改进的机制。