AI工作流延迟优化:模型路由、缓存、并行执行的实战经验总结
n8n博客总结生产环境AI工作流延迟优化的实用模式:模型路由、缓存、并行执行、超时控制和预算管理。工程实践导向,可直接指导AI应用性能调优。
完整中文译文
AI 工作流的延迟来源可以拆解为三个层面:
模型推理是模型读取提示词并生成 token 所花费的时间。
工具和 API 调用涵盖了 Agent 发起的所有外部请求,包括检索索引和第三方接口。
编排开销是运行整个工作流所消耗的总时间、计算资源、文件传输带宽和内存。
每一层需要用不同的方式去解决。如果一个工作流在三次顺序执行的 API 调用上花了四秒,换模型对它毫无作用;而如果瓶颈来自跨可用区分布的 Worker 节点,并行化这些 API 调用也无法解决问题。你需要先定位延迟发生在哪里,再针对性地处理。
Token 生命周期:Prefill、Decoding 与首个 Token 生成时间
一次大语言模型(LLM)请求分为两个阶段:
Prefill 阶段一次性处理整个输入并产出第一个 token。这个阶段通常很快,而且在 GPU 上并行执行。
Decoding 阶段逐个生成其余 token。由于是串行执行,这个阶段耗时更长。
工程师可以追踪的一个重要指标是:从发出提示词到模型生成并交付第一个文本片段所经历的时间,即 Time to First Token(TTFT)。TTFT 低于 200 到 500 毫秒通常被认为是较优的。如果对于非推理型 LLM 而言 TTFT 达到一秒或更长,则可能意味着服务器负载过重或计算机内存不足。
工具调用与编排开销
工具调用可能耗时数秒。每次检索步骤和 API 查询都要结合网络往返时间(RTT)和目标系统的处理时间。如果彼此独立的调用顺序执行,它们的延迟会累加——例如,三次各需 800 毫秒的调用顺序执行就需要 2.4 秒才能完成;如果并行化这些调用,总耗时约 800 毫秒(不含任何编排开销)。
编排开销通常只会造成较短的延迟,正因如此容易被忽视。步骤之间 100 毫秒的延迟看起来无害,但当它乘以检索、推理和后处理的次数累加起来,用户能感知到的延迟就会达到秒级。
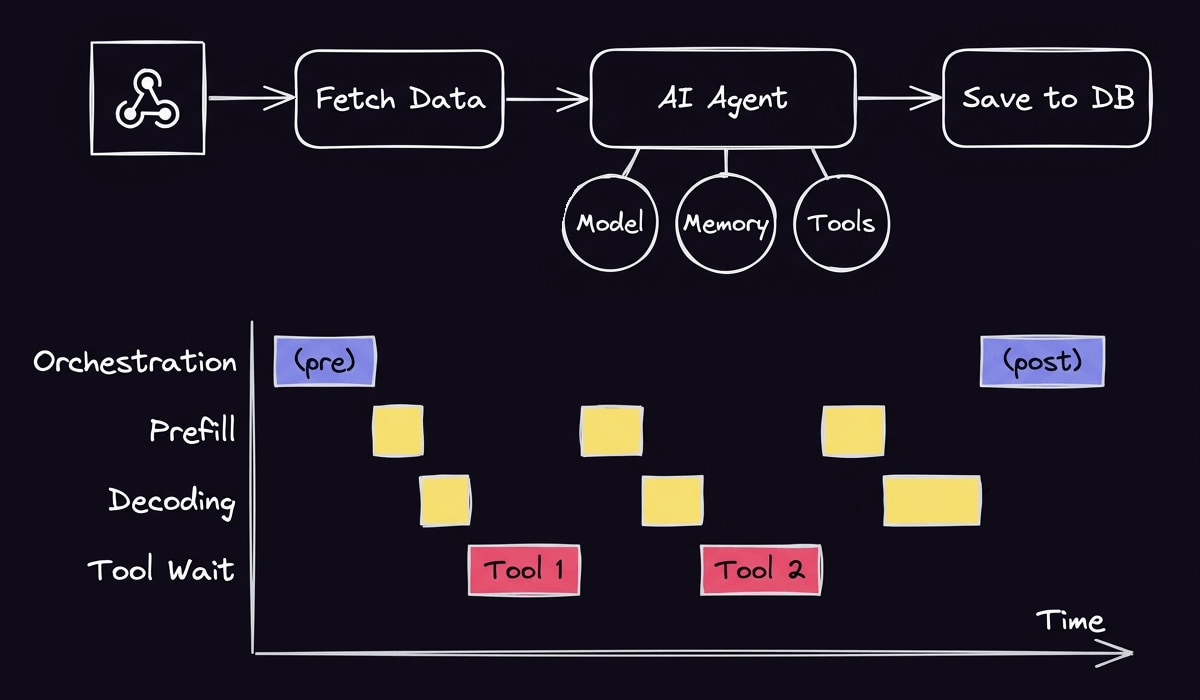
延迟预算(Latency Budget) 是工程团队或产品经理为 Agent 工作流的响应所设定的总允许响应时间。工作流设计者可以将总预算分配给具体的步骤,如数据检索或网络跳转。
但首先,要确认延迟确实是你的系统中的问题所在。你不会想花数周优化响应时间,而用户实际需要的是更好的准确性或检索能力。
如果你已经在 n8n 中构建了工作流,可以查看执行记录来分析某次运行把时间花在了哪里。一旦确认延迟是系统中的问题所在,就分析以下几个因素:
完成响应总时间(TTCR)。理解模型处理提示词、完成推理并交付完整响应所花费的总时间,对延迟优化至关重要。
TTFT。TTFT 对用户在系统中感知到的延迟影响巨大。尽量将其控制在 300 到 500 毫秒或更低。
每秒输出 Token 数(OTPS)。模型在初始响应之后生成新文本的速度,会影响用户体验以及复杂工作流完成后台任务的效率。将 OTPS 与 TTFT 相加即得到 TTCR。
工作流类型。实时或交互式工作流(如聊天 Agent 或客服机器人)需要比后台工作流(如数据同步)更快的响应时间。
具体需求可能因场景而异,以下是按工作流类型划分的端到端延迟预算示例:
- 实时工作流:500 毫秒或更低
- 批处理工作流:5 到 20 秒
- 后台工作流:30 秒以上
n8n 中的工作流层优化模式
自己构建编排层,可以永久掌控调度器和执行存储。n8n 允许你在工作流中直接配置并行执行、超时和缓存等模式,减少对自定义编排代码的依赖。具体方法如下。
在 AI Agent 步骤中并行运行工具调用
当 Agent 需要执行两个独立的查询时,模型可以在同一个回合中发起两个请求,AI Agent 节点会同时触发它们。
假设一个 Agent 需要查询两个货币汇率后再进行计算。模型可以并行执行两个汇率查询,而依赖其结果的计算器则等待两个查询完成后再顺序执行计算。
对于更复杂的架构,AI Agent Tool 节点可以将任务委托给专业 Agent。
当工具并行调用时,节省时间不仅来自堆叠工具执行时间,还因为减少了 LLM 调用次数——LLM 只在各工具执行完毕后才被调用一次。
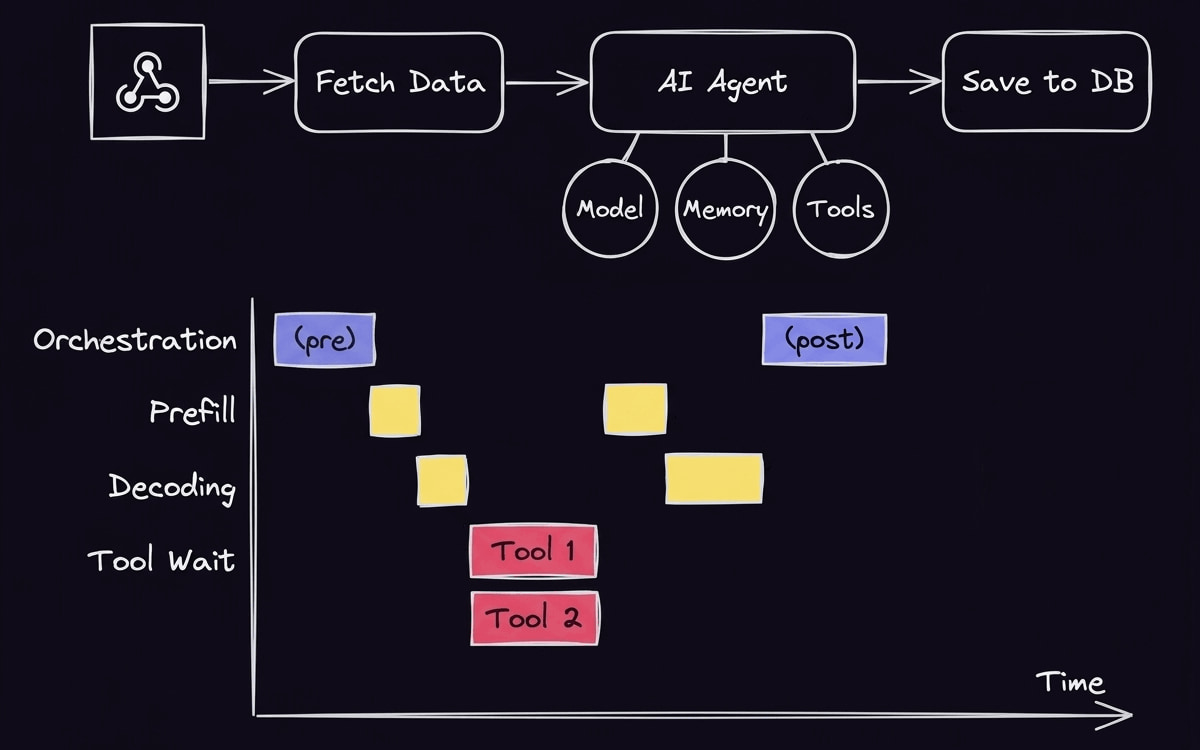
了解 AI Agent 节点中并行工具调用的工作方式
快速失败:超时、重试限制与护栏
一个挂起的 API 调用是代价最高的延迟之一,因为下游所有步骤都要等它完成后才能开始。
为外部调用设置硬超时。HTTP Request 节点支持超时配置,缓慢的端点可以在设定时间失败并触发预设的降级方案,而不是无限期地阻塞整个工作流。
重试可以提高瞬时故障的可靠性,但也会增加延迟。如果一次 API 调用正常耗时一秒,而系统运行三次重试、每次超时三秒,那么一次失败可能消耗工作流延迟预算的很大一部分。
使用 n8n 在节点或工作流级别处理重试的速率限制。如果想在节点上使用有限重试,点击该节点并打开设置,启用 Retry On Fail 开关,然后设置最大重试次数。如果想限制整个执行的时长,可以配置工作流设置,在超过一定时间后超时。
Guardrails 节点可以帮助捕获将导致 Agent 走入冗长无意义路径的恶意输入。你可以配置它检测违规内容(如 URL、正则表达式、密钥、个人身份信息)并用占位符替换。或者使用一套完整的护栏,将任何违规行为发送到 Fail 分支。
用子工作流隔离慢操作
有些步骤慢是因为客观原因无法修复的。如果供应商 API 需要八秒,把它移到一个新节点里并不能让供应商变快。但子工作流可以改善围绕这个慢操作的架构。
在 n8n 中用 Execute Sub-workflow Trigger 节点将工作流拆分为更小的部分。这样你可以给慢速步骤配置独立的超时、重试和并发设置,还可以控制父工作流是否等待它完成。
用并发和队列模式扩展执行
当 40 个执行实例同时到达,而你的实例全部并行运行时会发生什么?一切都会变慢,吞吐量问题开始表现得像延迟问题。
n8n 根据你的订阅计划限制了 Cloud 实例的并发执行数量。如果你托管 n8n,可以控制并发来限制同时运行的生产执行数量。如果启用队列模式,主实例处理触发器和 Webhook,再通过 Redis 将每个执行实例转交给 Worker 池处理。这样可以根据添加的 Worker 数量来扩展吞吐量。
立即开始构建你的第一个延迟优化的 AI 工作流,用 n8n Cloud 十分钟内即可上手——免费试用。
模型层优化模式:路由、Token 与缓存
推理延迟由两个变量驱动:你选择的模型决定了每个 token 的生成速度,而答案长度决定了需要等待多少个 token。LLM 延迟优化的起点是选对模型并最小化不必要的输出。
将任务路由到合适规模的模型
分类和短文本提取步骤适合用小模型运行。小模型生成 token 更快,因为每个 token 消耗的计算量更少,所以将一个大型 dense 70B 模型替换为更小的 MoE(混合专家)模型,每次查询可节省数百毫秒。把大模型(尤其是内置推理能力的模型)留给多步骤自动化任务。
先生成 Token,再优化输入 Token
生成的输出往往是最好控制的推理成本,因为解码是串行的。OpenAI 的延迟优化指南指出,输出与延迟的关系接近线性。如果削减 50% 的输出 token,延迟也可以削减约 50%。
要削减输出 token,先从限制模型的响应开始。设置最大输出长度,用短字段名请求结构化输出,并告诉模型用指定字数回答。
Prompt 缓存与语义缓存
模型提供商通常会控制 Prompt 缓存。当一个请求反复共享一个可缓存的前缀时,提供商可以避免重复计算部分输入处理。这可以减少输入处理的延迟,但无法消除解码阶段——模型仍然需要端到端运行。
语义缓存可以为与已有请求相似的新请求完全避免推理。
例如,一个用户问"How long do I have to send something back?",另一个用户问"What's your return window?"——两个问题措辞不同但问的是同一信息,语义缓存可以直接返回之前的答案,而不再触发模型。
在 n8n 中,Redis Vector Store 支持对重复查询实现零推理的缓存命中,不仅仅是精确匹配和语义缓存。
用 n8n 降低 AI 工作流延迟
降低 AI 工作流延迟的关键是按正确顺序进行优化。先测量你在模型推理、工具调用还是编排开销上损失了时间。先把工作流层的模式做对,再清理模型层的基础问题。
使用 n8n,你可以直接在工作流中测量执行情况并应用延迟优化模式。
立即体验 n8n,开始构建更快的 AI 工作流,无需编写自定义编排代码。