
8.0
热点
AI SCORE
开源项目2026-08-07 00:00
腾讯HPC-Ops联手SGLang开源高性能MoE内核
LMSYS / SGLang Blog#SGLang#LLM推理#MoE
Editor brief · 编辑速览
腾讯HPC-Ops开源高性能注意力、路由器GEMM和MoE内核,已在SGLang中集成,可显著提升LLM推理吞吐。
Attention、路由与专家:MoE 模型Serving 的三个热点路径
Attention:变长decode的负载均衡
围绕Live KV Work的调度
融合的Attention前奏
Router GEMM:在路由精度与吞吐量之间取得平衡
精确度感知的BF16公式化
MoE:降低小型专家GEMM的overhead
面向延迟的融合MoE Pipeline
从HPC-Ops Kernel到SGLang
性能评估
H20算子基准测试
H200算子验证
端到端性能
H200 Serving验证
HPC-Ops是一个面向LLM推理的开源算子库,已部署于腾讯大规模生产Serving环境。其核心算子(包括Dynamic Attention和Fused MoE)在混元的在线推理中发挥了关键作用,将Hy3模型的TPOT降低了最多48.8%。HPC-Ops的Attention、Router GEMM和MoE现已集成到SGLang的主分支,将这些经过生产验证的优化带给开源Serving社区。
在这篇博客中,我们介绍HPC-Ops中三个重要算子的设计及其与SGLang的集成。随后展示H20上的算子基准测试和Serving结果,以及H200的验证结果。这些集成针对NVIDIA Hopper GPU(SM90),已在Qwen3、Hy3和LongCat工作负载上完成验证。
Attention:在H20上,HPC-Ops的动态调度比静态split-KV调度快2.95倍,平均比FlashInfer和FlashAttention各测试案例中的最优者快2.25倍。在上游H200验证中,结合FP8 KV Cache的集成Hy3-FP8路径相比FlashAttention将输出吞吐量提升了3.7%–5.9%。
Router GEMM:在H20上,HPC-Ops比FP32 cuBLAS快1.30–3.22倍,其相对于FP32 cuBLAS的最大绝对误差为0.00177,而TF32 cuBLAS为0.06464。在上游H200 LongCat-Flash Kernel验证中,它比现有FP32路径快了4.31倍。
MoE:在H20上,HPC-Ops在Hy3上相比SGLang和vLLM基线中的最优者,TP8/EP1下平均batch加速1.08倍,TP1/EP8下平均batch加速1.21倍。在上游Qwen3/H200 Kernel基准测试中,八个token时比Triton快最多4.21倍。
端到端Serving:在8× H20 + Hy3-FP8配置下,同时启用HPC-Ops Attention和MoE,在batch大小4–64时将TPOT降低15.1%–48.8%,在batch大小4–16时将TTFT降低3.3%–6.0%。在8× H20 + LongCat-Flash-Lite-FP8配置下,启用HPC-Ops Router GEMM,在batch大小4–64时将输入吞吐量提升5.5%–6.1%。
Attention、路由与专家:MoE模型Serving的三个热点路径
生产环境的MoE Serving很少与隔离Kernel基准测试中测量的均匀工作负载相似。它在同一延迟敏感路径中结合了变长Attention工作负载、精度敏感的路由和稀疏的专家执行;长上下文、多轮和Agentic工作负载进一步扩大了Live KV长度的分布。因此,Serving性能不仅取决于原始矩阵乘法吞吐量,还取决于工作负载均衡、数值保真度和开销控制。
这些约束在MoE模型Serving的三个性能关键阶段中表现出来。在decode期间,每个新token都会Attend请求的完整KV Cache,因此Attention工作量随Live序列长度增长。一个具有16K缓存token的请求,其KV工作量大约是一个1K请求的16倍。在生产环境中,Prompt和输出长度差异很大,连续批处理将处于不同生成阶段的请求放在同一Launch中;因此一个Batch通常会混合短KV Cache与长达数万token的序列。
静态split-KV调度将工作映射到KV头、请求和KV块的固定Launch网格上,在整个Batch中共享一种分区策略。静态split-KV调度器通常遵循两种策略之一,这两种策略在变长Batch上都表现不佳。(1)固定split数量,则长请求产生更重的chunk:短请求CTA提前完成,而少数长运行CTA决定Kernel尾部。(2)改为固定chunk大小,则网格必须为最长请求预留足够的split,导致短请求持有空或近乎空的chunk,但仍消耗调度槽位。一种策略造成工作不均,另一种策略调度的实际不存在的工作。
围绕Live KV Work的调度
HPC-Ops用持久Kernel替代静态的按请求split,根据Batch的实际长度分布动态平衡KV tile在CTA之间的分配。对于每个decode Batch,分配Kernel从Live KV长度构建全局任务映射:它将每个序列切片为统一的64-token tile,跨所有头和请求求和tile计数,然后用tile总数除以持久CTA数量来设定每个CTA的tile预算。分配Kernel将每个CTA的bin填充至该预算上限,然后溢出到下一个,因此长序列按比例跨多个CTA,而短序列只贡献它们实际拥有的tile。当总工作量较小时,设置最小工作下限防止过度分区,保持下游Combine的低成本。任务映射每个decode步骤从设备端序列长度生成一次,并在Transformer层之间重用,分摊其成本。
在执行时,每个CTA排空其分配的bin。对于每个描述符,它在一个或多个连续KV tile上计算Attention,并写出带有其log-sum-exp统计量的部分输出;同一个驻留CTA继续处理下一个描述符,直到其bin为空。由于每个CTA只产生给定请求的部分部分结果,最终的Combine Kernel读取每个请求和头的实际chunk数量,并在正确的全局softmax归一化下合并部分结果。接近相等的bin大小确保CTA大致同时完成,消除了少数异常长请求原本会造成的Kernel尾部。
融合的Attention前奏
对于Hy3 FP8,HPC-Ops在QKV投影之后融合了Attention序幕:它在RoPE之前应用QK-Norm,以每token、每头的scale用FP8发射Q,并将K和V直接写入分页FP8 Cache。它将量化后的Q及其scale直接传递给主Attention Kernel,避免了重新量化。融合路径在Prefill和Decode中都消除了中间张量及其相关的HBM往返和独立Kernel Launch。
Router GEMM:在路由精度与吞吐量之间取得平衡
Router精度直接影响MoE模型质量。在每个MoE层,Router将隐藏状态投影为专家分数,然后对这些分数进行top-k选择来决定哪些专家执行。第k个和第(k+1)个专家之间的分数差异可能很小,因此该投影的算术精度决定了是否能选中正确的专家。
为保持Router精度,一些生产模型即使在隐藏状态为BF16时也保留FP32 Router权重。将这些权重Cast为BF16可以使用BF16 Tensor Core吞吐量,但会丢弃可能改变top-k决策的低阶尾数位。完整的FP32 GEMM保留了所有权重精度,但Tensor Core吞吐量较低。
精确度感知的BF16公式化
HPC-Ops 通过将 FP32 权重分解为两个 BF16 分量来解决这个问题。它通过直接截断提取 BF16 高位部分 $W_{\mathrm{high}}$,然后从缩放残差 $(W - W_{\mathrm{high}}) \times 256$ 形成第二个 BF16 分量。原始权重近似为 $W \approx W_{\mathrm{high}} + W_{\mathrm{low}} / 256$,因此矩阵乘积变为两个 BF16 GEMM,其结果通过缩放校正组合以恢复低位尾数贡献。单个内核执行两个 BF16 乘法:它从共享内存加载一次激活瓦片,在 FP32 寄存器中累加两个部分结果,在尾声(epilogue)中应用 1/256 缩放,然后将最终 FP36 路由器分数写入全局内存。这种公式化表达在 BF16 Tensor Core 上运行主要算术的同时,恢复了接近完整 FP32 GEMM 的精度。
在框架层面,SGLang 在模型加载时缓存分解后的权重对,并在请求和 CUDA 图重放中重用它。形状感知的调度在测量的交叉点处选择 HPC-Ops 内核和默认路径。在这些交叉点以下,单个 FP32 路径更快,因为双乘积的开销超过了 Tensor Core 的收益。
MoE:减少小型 Expert GEMM 周围的开销
在解码期间,MoE 层中的每个 expert 只接收少量 token。由此产生的 expert GEMM 很小且受内存限制,GPU 的 SM 在这些形状下利用率不足。负载不平衡问题进一步加剧:路由到每个 expert 的 token 数量在不同 expert 之间有所不同,且随步骤变化,使得难以将这些小型、不均匀的瓦片均匀地分散到可用的 SM 上。
除了 expert GEMM 本身,包围它们的操作也引入了大量开销。传统的 MoE 路径将路由、将 token 聚合到 per-expert 缓冲区、Gate-Up GEMM、激活和量化、Down GEMM 以及 top-k 加权归约回 token 位置链接为独立内核序列。聚合步骤在任何 matmul 开始之前就在 HBM 中物化完整的 token 张量,每个后续阶段都要为其自身内核启动和中间结果的 HBM 往返付出代价。当 GEMM 很小时,这种周围的开销占该阶段墙上时间的相当比例。
融合的、面向延迟的 MoE 流水线
对于小批量推理,HPC-Ops MoE 后端围绕任务映射驱动的持久化 expert GEMM 协调路由和索引预处理、Gate-Up、激活和 requantization、Down 以及 top-k 加权归约,构成低延迟流水线。
路由和索引构建。从选定的 top-k expert ID 开始,共享内存计数过程将 token–expert 分配组织为连续的 per-expert 输出范围,减少全局原子操作压力,并构建路由索引和 per-tile 任务映射,供持久化 expert GEMM 直接消费。
Gate-Up 和激活。Gate-Up GEMM 通过路由索引直接读取原始 token,跳过独立聚合及其额外的 HBM 流量。SiLU-and-mul 和 FP8 requantization 然后作为一个融合内核运行,其输出由 Down GEMM 直接读取。
以占用率为先,无需 warp 特化。单个 warp group 处理数据传输和矩阵运算,而不是保留独立的生产者和消费者组。这提高了 CTA 驻留,并将内存延迟隐藏从 intra-CTA 软件流水线转移到跨 CTA 硬件调度。持久化网格然后消费这些任务映射,并将小型、不均匀的 expert 瓦片分散到 SM 上。
PDL 链阶段。编程式依赖启动(Programmatic Dependent Launch)将每个下游内核启动与前一阶段的尾部重叠,减少 Gate-Up、激活、Down 和最终 top-k 加权归约之间的间隙,从而恢复 expert 输出到 token 顺序。
这些优化共同减少了关键路径上的中间流量和内核启动开销。
从 HPC-Ops 内核到 SGLang
通过 SGLang 的原生后端和调度接口,HPC-Ops 直接在服务运行时的现有状态上操作,同时保持为独立维护的算子库。Attention 消费分页 KV 存储和实时设备端序列元数据,无需额外的布局转换;Router GEMM 在请求和 CUDA 图重放中重用预处理权重和工作区;MoE 遵循 SGLang 的 expert ID 和分区,无需额外重映射。这些集成保留了每个算子的预期数据路径,同时符合 SGLang 现有的执行模型。
三种集成的算子路径总结如下:
本指南描述了如何在 SGLang 中使用 HPC-Ops Attention、Router GEMM 和 MoE 算子。
从源码安装 HPC-Ops:
git clone https://github.com/Tencent/hpc-ops.git
cd hpc-ops
make wheel
python3 -m pip install dist/*.whl
HPC-Ops 已包含在 SGLang 官方 x86_64 开发镜像中(lmsysorg/sglang:dev,或 CUDA 12.9 的 lmsysorg/sglang:dev-cu12),因此使用这些镜像时无需单独安装。
Attention 和 MoE 在 SGLang 中是独立的的后端选择,可以为 Qwen3 和 Hy3 等兼容模型单独或一起启用。以下示例同时选择两个 HPC-Ops 后端,并启用 FP8 KV-cache Attention 路径:
python3 -m sglang.launch_server \
  --model tencent/Hy3-FP8 \
  --tp-size 8 \
  --attention-backend hpc_ops \
  --kv-cache-dtype fp8_e4m3 \
  --page-size 64 \
  --moe-runner-backend hpc_ops
对于 BF16 KV cache,忽略 --kv-cache-dtype fp8_e4m3。要仅使用一个 HPC-Ops 算子,只需指定相应的后端选项。
在 SGLang 中,HPC-Ops Router GEMM 在 BF16 Tensor Core 上执行矩阵运算的同时,保留来自 FP32 路由器权重的低位信息。集成路径已在 LongCat-Flash Chat 和 Lite 上验证,对于支持的模型和路由器形状会自动选择。安装 HPC-Ops 后,标准 LongCat-Flash 启动即可使用它:
python3 -m sglang.launch_server \
  --model meituan-longcat/LongCat-Flash-Lite-FP8
性能评估
HPC-Ops 后端目前支持 NVIDIA Hopper 架构 GPU,并在 H20 上提供最佳性能。以下评估涵盖 H20 上的算子基准测试、8× H20 上的端到端 SGLang 服务,以及上游 SGLang pull request 中报告的 H200 结果。
H20 算子基准测试
Attention 调度器的突出优势出现在混合长度解码中,同一批次中的请求可能具有截然不同的 KV-cache 长度。我们评估从均匀分布到高度偏斜分布的 FP8 KV-cache 解码;在表中,A×B 表示 A 个请求,每个请求的 KV 长度为 B。为隔离调度效果,我们将 HPC-Ops 动态调度与其静态 split-KV 对应物进行比较,同时以 FlashInfer 和 FlashAttention 作为额外基线。动态与静态的收益随偏斜度增加而增长,从均匀 64×0.5K 批次的持平增长到 1×128K + 31×4K 混合的 2.95 倍。在所有六种情况中,动态调度平均比每种情况中 FlashInfer 和 FlashAttention 中的最佳者快 2.25 倍。
表 1:H20 上不同 KV 长度分布下的解码延迟。越低越好。
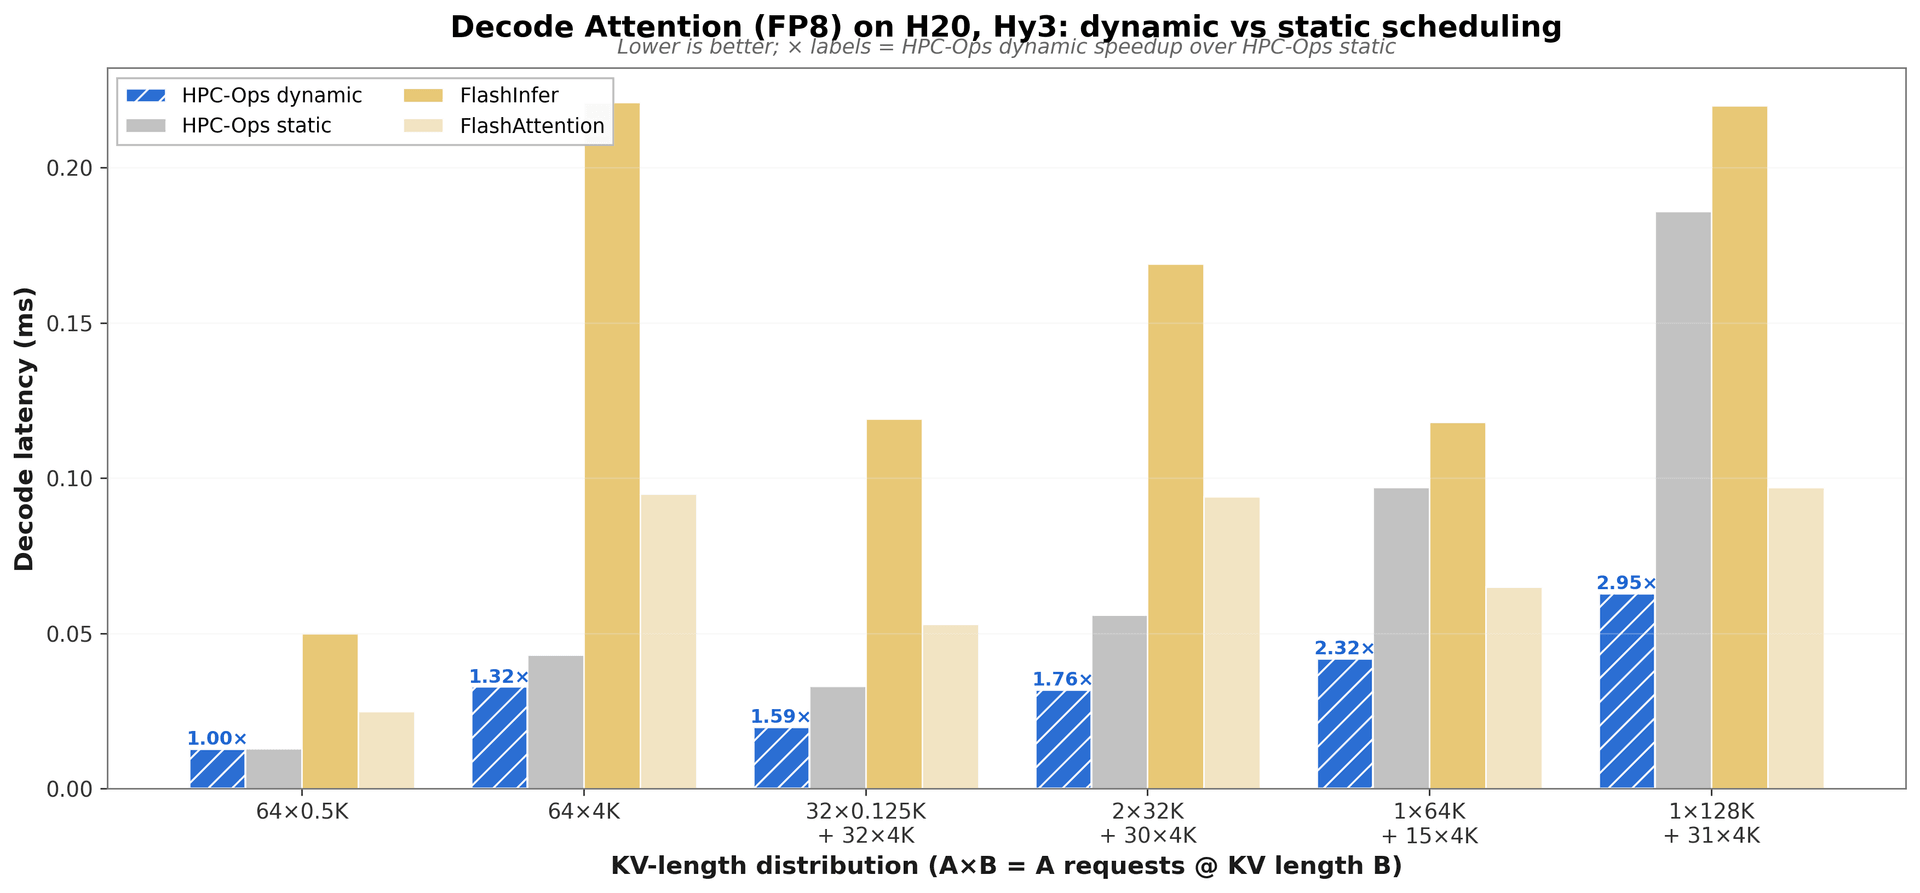
图 1:随着实时 KV 工作变得更加偏斜,动态调度变得越来越有效。越低越好。
我们首先用通用 K=4096, N=192 sweep 评估 Router GEMM。在所有测量的 M 值中,HPC-Ops 比 FP32 cuBLAS 快 1.30–3.22 倍,比 TF32 cuBLAS 快 1.25–1.78 倍。以 FP32 cuBLAS 为数值参考,最大绝对误差保持在 0.00177 或以下,而 TF32 为 0.06464。
表 2:H20 上 K = 4096, N = 192 时的 BF16 × FP32 Router GEMM 延迟。越低越好。
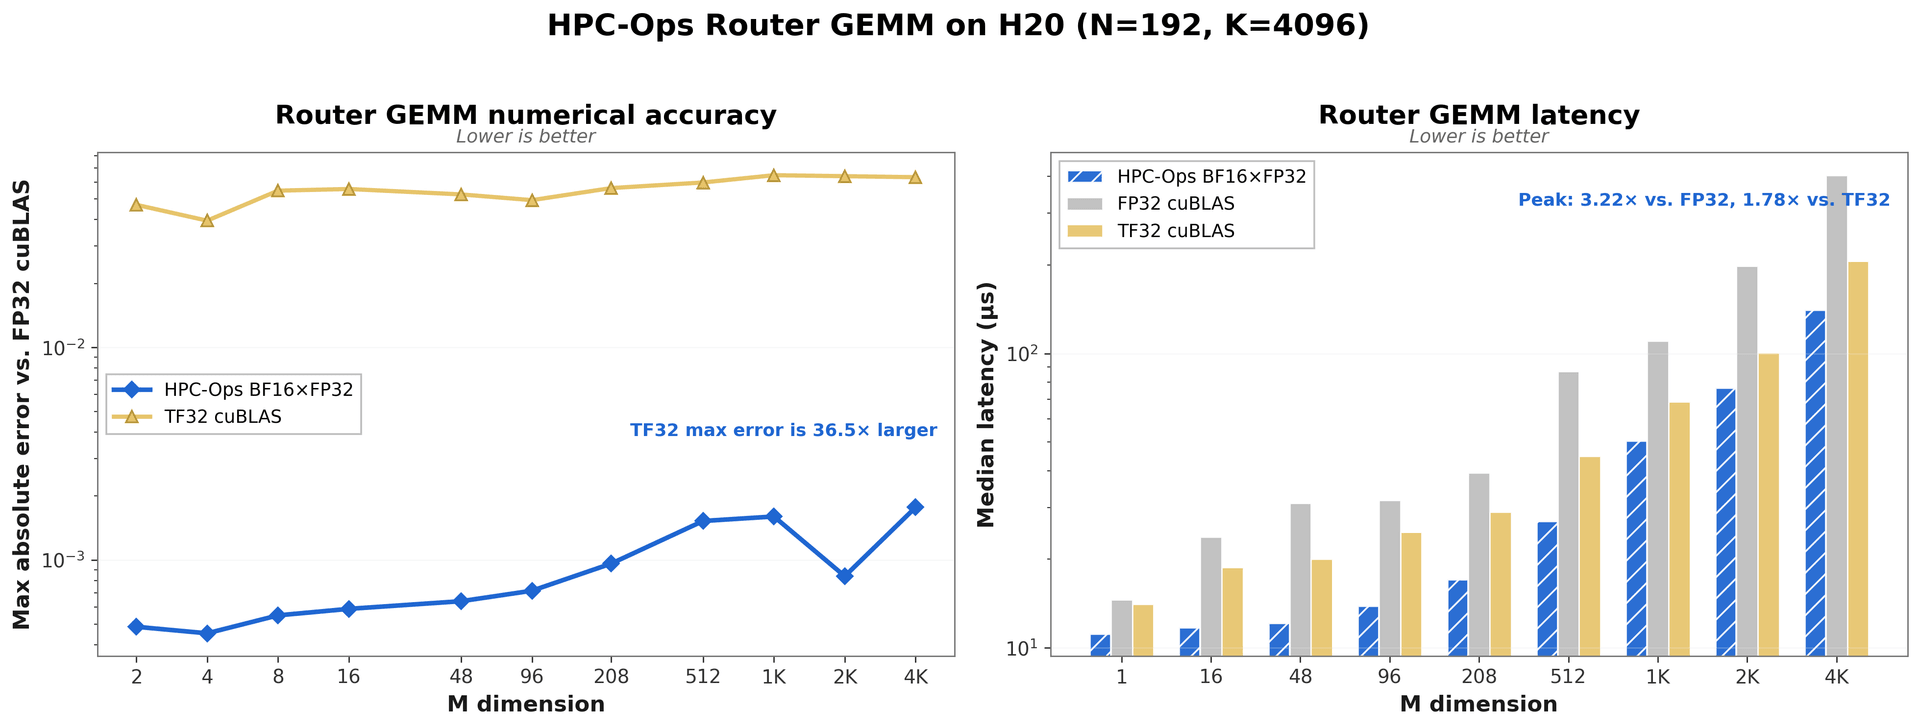
图 2:相对于 FP32 cuBLAS 的 Router GEMM 数值误差(左侧)以及与 FP32 和 TF32 cuBLAS 的延迟对比(右侧)。越低越好。
然后我们重新测试 LongCat-Flash 使用的两种路由器形状。在 SGLang 的模型感知调度范围内,HPC-Ops 相比 SGLang 默认提供 1.06–2.83 倍的加速(Chat 形状)和 1.09–2.46 倍的加速(Lite 形状)。
表 3:H20 上 LongCat-Flash Router GEMM 在 SGLang 调度范围内的延迟。越低越好。
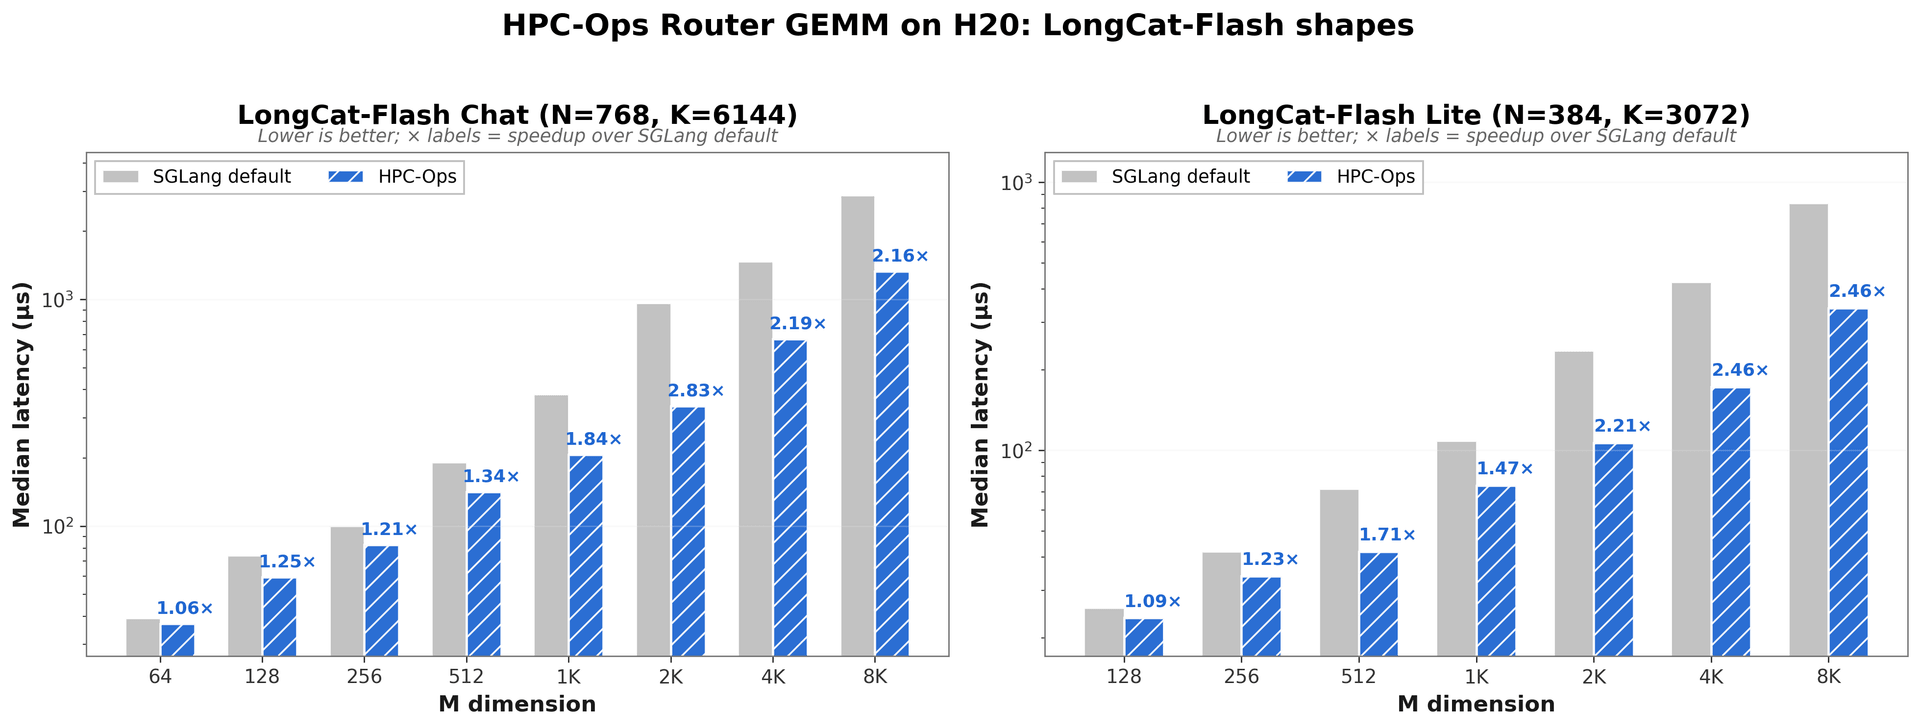
图 3:LongCat-Flash Chat(左侧)和 Lite(右侧)形状在 SGLang 调度范围内的 Router GEMM 延迟。越低越好。
For MoE,在 TP8 / EP1 和 TP1 / EP8 的 Hy3 形状下对完整融合算子进行基准测试,对比 SGLang、vLLM Triton 和 vLLM CUTLASS。以三个基准中每行的最低延迟为参照,HPC-Ops 在 TP8 / EP1 下实现平均每批次 1.08× 的加速,在 TP1 / EP8 下实现平均 1.21× 的加速,最大收益出现在低延迟解码场景常见的小到中等批次规模。
表 4:H20 上 TP8 / EP1 配置的 Hy3 MoE 延迟。越低越好。
表 5:H20 上 TP1 / EP8 配置的 Hy3 MoE 延迟。越低越好。
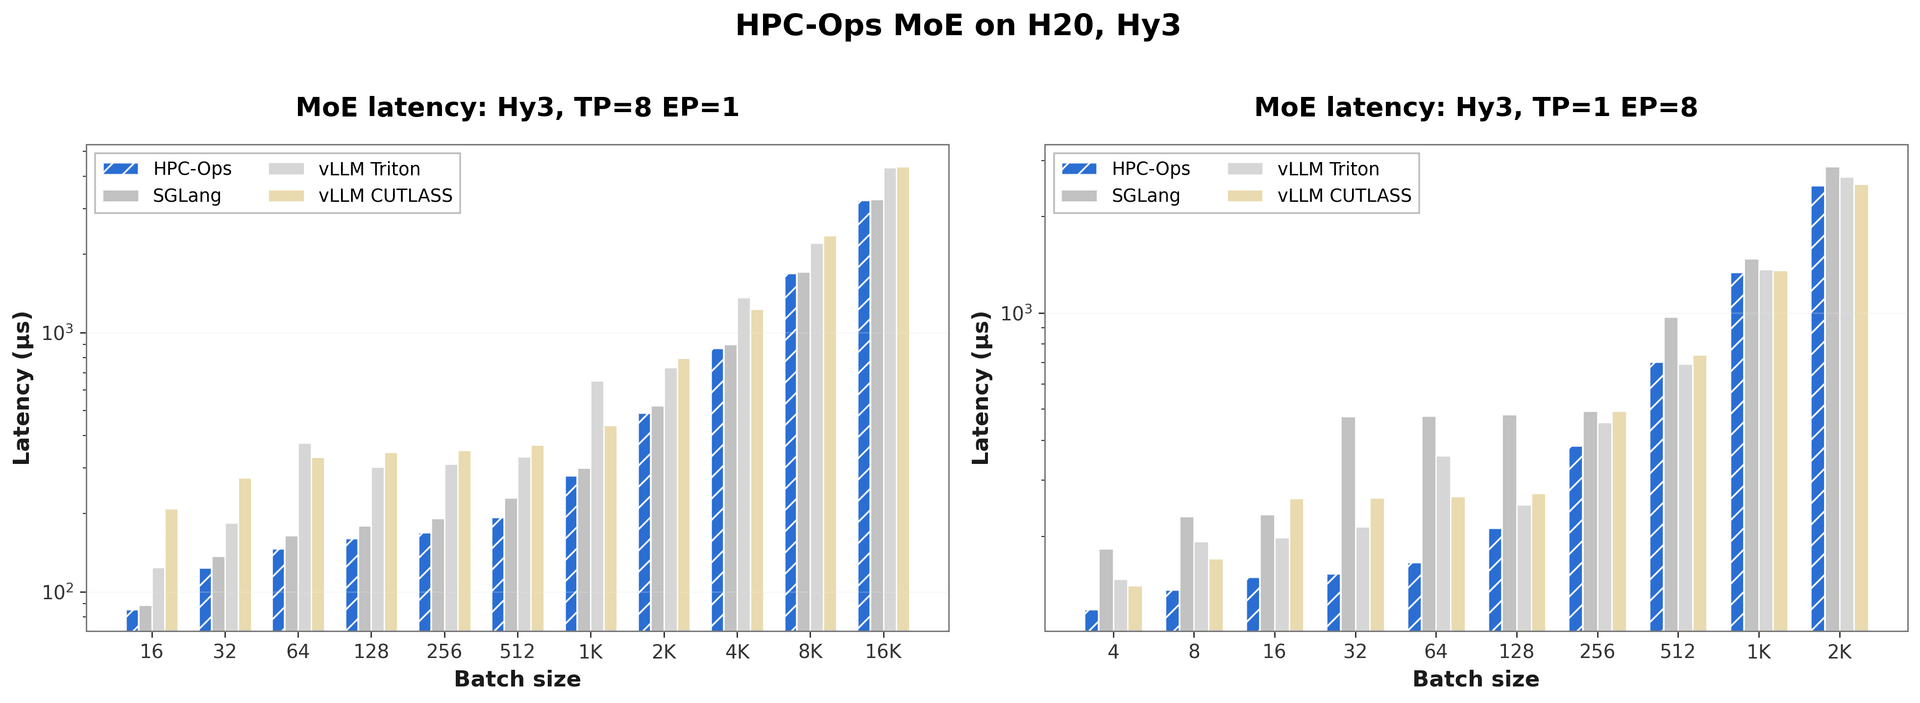
图 4:Hy3 MoE 在 TP8 / EP1 和 TP1 / EP8 配置下的延迟。越低越好。
H200 算子验证
上游 PR 中还包含 H200 服务结果,确认性能收益可泛化至 Hopper GPU。
表 6:上游 SGLang PR 中报告的算子验证结果。
端到端性能
端到端评估在 8× NVIDIA H20 GPU 上运行,对比相应默认 SGLang 实现。在 TP8 + FP8 KV 缓存的 Hy3-FP8 上,我们通过同时启用 HPC-Ops Attention 和 MoE 来测量综合服务影响。在 LongCat-Flash-Lite-FP8 上,仅测量 Router GEMM。我们还总结了上游 SGLang PR 中报告的 H200 服务验证。
Hy3-FP8:Attention 和 MoE。
在 8K 输入和 4K 输出下,HPC-Ops 在批次大小为 1 时将 TPOT 降低 3.3%。在批次大小 4–64 下,降低幅度达到 15.1%–48.8%。
表 7:启用 FP8 KV 缓存且同时开启 HPC-Ops Attention 和 MoE 的 Hy3-FP8 TPOT。越低越好。
在 8K 输入下,HPC-Ops 在批次大小 1–16 下将 TTFT 改善 3.3%–9.0%。
表 8:8K 输入下启用 FP8 KV 缓存的 Hy3-FP8 TTFT。正向改善表示延迟降低。
在批次大小为 16 时,我们还扫描了 2K 到 8K 的输入长度,禁用分块预填充和前缀缓存。HPC-Ops 在三种输入长度下将 TTFT 改善 2.3%–8.9%。
表 9:批次大小为 16 时不同输入长度下启用 FP8 KV 缓存的 Hy3-FP8 TTFT。正向改善表示延迟降低。
LongCat-Flash-Lite-FP8:Router GEMM。
Router GEMM 单独评估,输入为 1,024 token,输出为 128 token。在批次大小为 1 时输入吞吐量几乎持平,改善 0.5%,在批次大小 4–64 下改善 5.5%–6.1%。
表 10:启用 HPC-Ops Router GEMM 的 LongCat-Flash-Lite-FP8 输入吞吐量。越高越好。
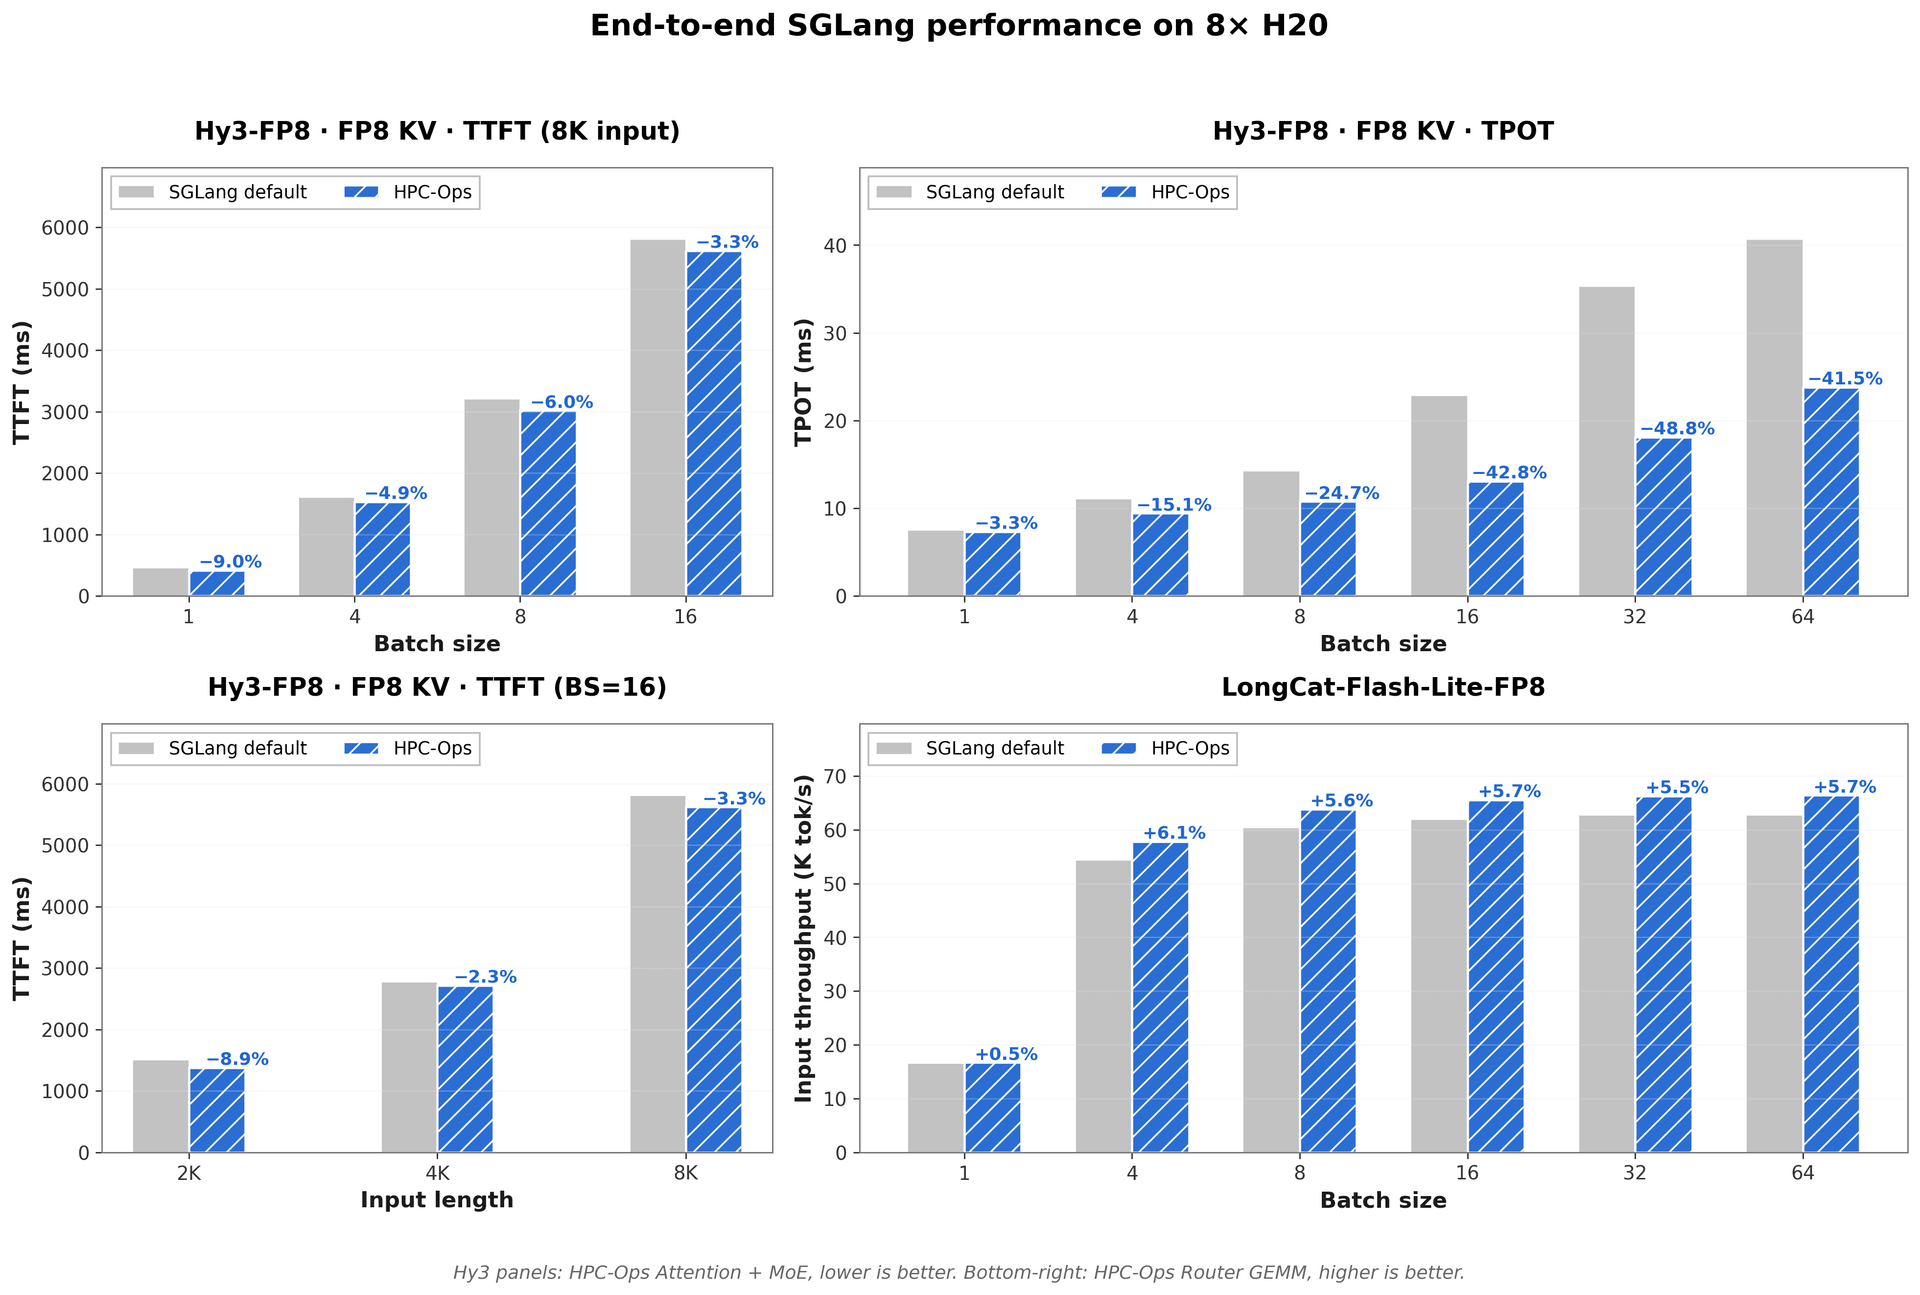
图 5:端到端 SGLang 结果。前三个 Hy3-FP8 面板使用 FP8 KV 缓存并同时启用 HPC-Ops Attention 和 MoE;右下方面板单独测试 Router GEMM。
H200 服务验证
上游 PR 还在 H200 上对 SGLang 服务循环中的集成算子进行了评估,提供了除主要 H20 调优目标外的模型级集成检查。
表 11:上游 SGLang PR 中报告的模型级服务验证结果。
上游集成还经过数值和模型级保真度检查。Attention 测试在 BF16 和 FP8 下均通过,评估的 Hy3 FP8 贪婪输出与 BF16 路径逐 token 匹配。Router GEMM 通过与 FP32 参考实现的对比,并保留贪婪输出。对于 Qwen3,HPC-Ops MoE 路径与 Triton 相比 FP32 的误差一致,余弦相似度为 0.99974,最大相对误差为 0.024。完整配置和每个案例的详细结果可在上游 PR 中获取。
这项工作是 HPC-Ops 与 SGLang 社区更广泛合作的一部分。我们将继续与 SGLang 维护者和贡献者合作,改进和扩展这些算子,并在 HPC-Ops 能力成熟时将其上游至 SGLang。非常欢迎反馈、问题和建议,我们也期待共同推进开源、高性能 LLM 推理的发展。
我们要感谢各团队中为将这些算子引入 SGLang 而共同努力的许多人:
Tencent Hunyuan AI Infra — 构建并优化了 HPC-Ops Attention、Router GEMM 和 MoE 算子,并将其贡献给 SGLang。Sethran Liu、Chase Shao、Shengy Wei、Theo Cheng、Ryann Xue、Lando Jiang、Looper Zhao、Haank Lin、Aiden Ren、Lehua Ding、Chengv Jiang、Steven Kuang、Liqi He、Kipper Gong、Reedlau Liu、Raccoon Liu、Dick Zhu。
Tencent Network Platform Department — 在通信优化方面紧密合作。Xuan Zhang、Haoran Zhao、Yuanyuan Gong、Yadong Liu、Jinzhu Wang、Yinben Xia、Xiang Li、Quan Wen、Zekun He。
SGLang — 提供开源后端接口、代码审查和设计讨论。Xiaoyu Zhang (BBuf)、Xinyuan Tong、Ke Bao 及整个 SGLang 团队。
NVIDIA — 在内核和性能优化方面紧密合作。Yuanhang Sun、Perkz Zheng、Yuxi Chi、Jiang Shao、Jun Gu、Meng Wang、River Liu、Gary Ji、Chandler Zhou。
我们还要感谢更广泛的开源内核社区,正是他们的工作构成了本文的基础和参照,包括 NVIDIA CUTLASS/CuTe、TensorRT-LLM、FlashInfer、FlashAttention 和 Triton。