
8.0
热点
AI SCORE
开源项目2026-09-20 15:39
Higgsfield:开源万亿参数模型分布式训练框架
GitHub Trending#分布式训练#GPU调度#开源
Editor brief · 编辑速览
Fault-tolerant GPU 调度框架,支持 ZeRO-3 和 PyTorch FSDP,可管理千亿至万亿参数模型的分布式训练任务,含 GitHub Actions 集成。
Higgsfield 是一个开源的、容错的、高度可扩展的 GPU 编排与机器学习框架,专为训练数十亿至数万亿参数规模的模型(如大型语言模型 LLM)而设计。
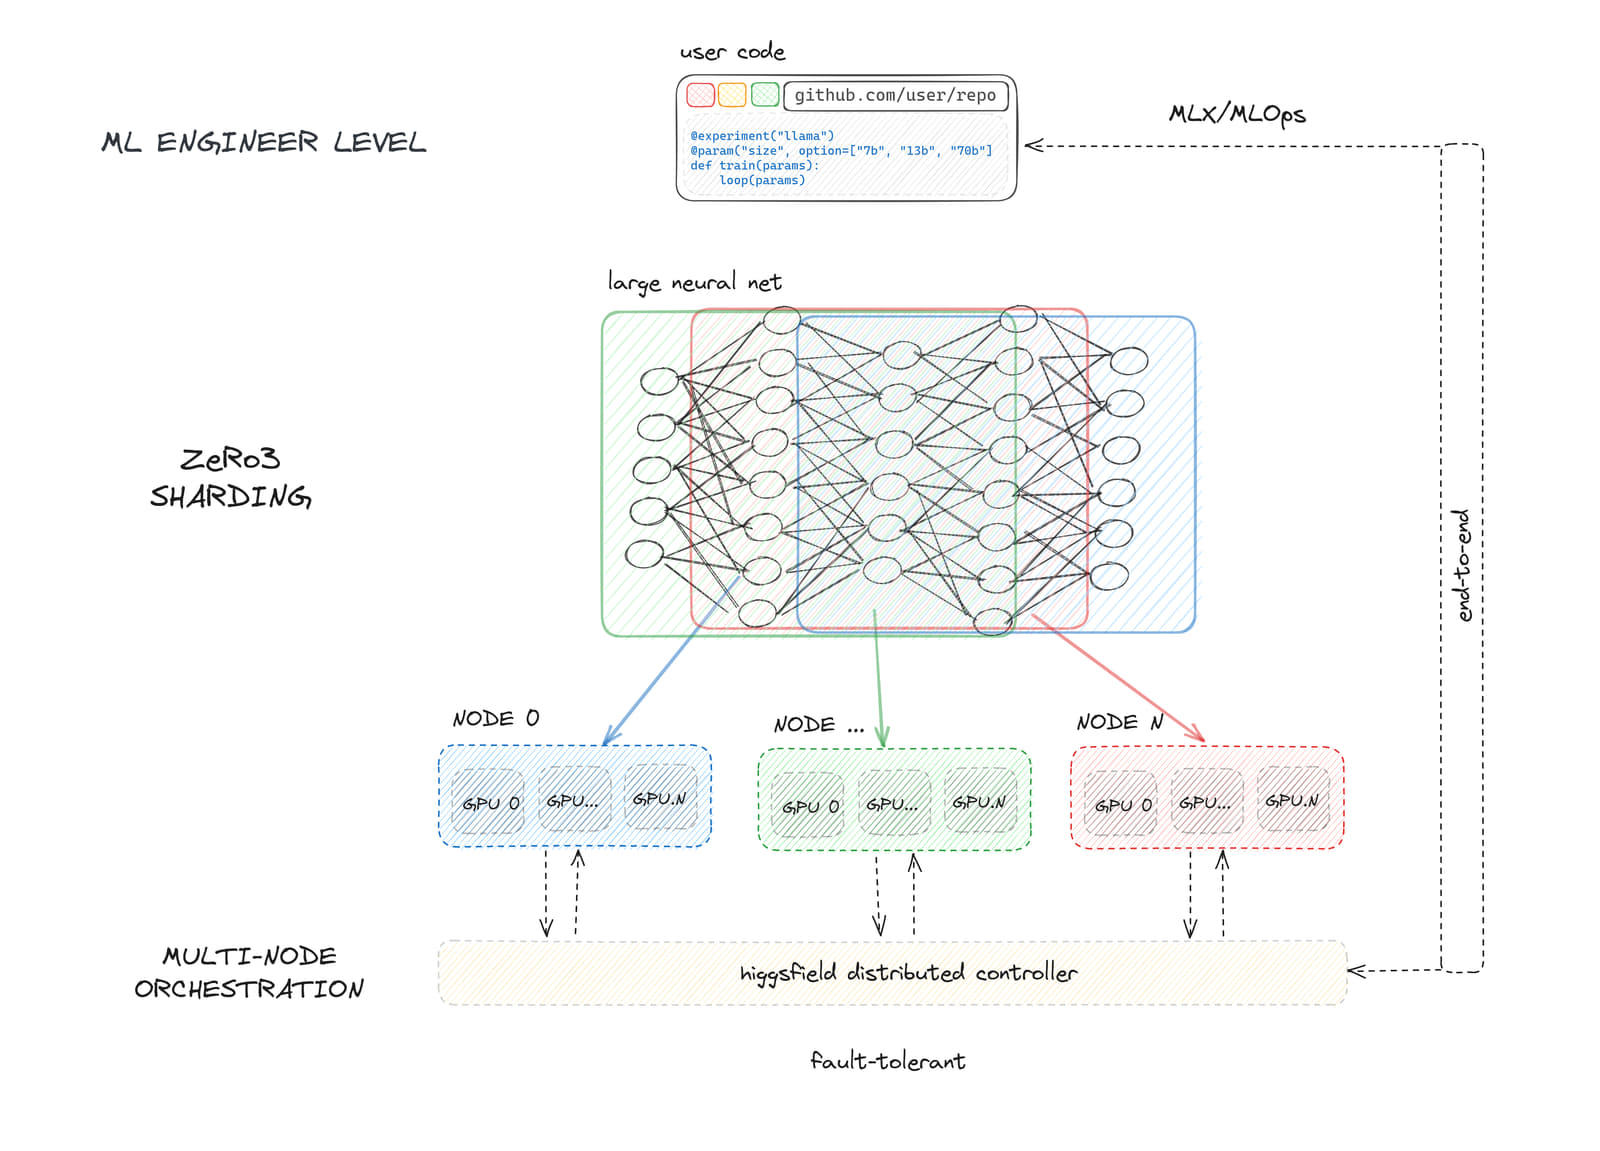
Higgsfield 作为 GPU 工作负载管理器与机器学习框架,提供五项核心功能:
为用户的训练任务分配计算资源(节点)的独占访问权限和非独占访问权限。
支持 ZeRO-3 Deepspeed API 和 PyTorch 的完全分片数据并行 API,实现万亿参数模型的高效分片。
提供在已分配节点上启动、执行和监控大规模神经网络训练的框架。
通过维护运行实验队列来管理资源竞争。
通过与 GitHub 和 GitHub Actions 的无缝集成,促进机器学习开发的持续集成。Higgsfield 简化了大规模模型训练流程,为开发者提供了强大而可靠的工具集。
$ pip install higgsfield==0.0.3
这就是在分布式环境下训练 LLaMa 所需的全部操作:
from higgsfield.llama import Llama70b
from higgsfield.loaders import LlamaLoader
from higgsfield.experiment import experiment

import torch.optim as optim
from alpaca import get_alpaca_data

@experiment("alpaca")
def train(params):
    model = Llama70b(zero_stage=3, fast_attn=False, precision="bf16")

    optimizer = optim.AdamW(model.parameters(), lr=1e-5, weight_decay=0.0)

    dataset = get_alpaca_data(split="train")
    train_loader = LlamaLoader(dataset, max_words=2048)

    for batch in train_loader:
        optimizer.zero_grad()
        loss = model(batch)
        loss.backward()
        optimizer.step()

    model.push_to_hub('alpaca-70b')
我们在你的服务器上安装所有必需的工具(Docker、项目的部署密钥、higgsfield 二进制文件)。
然后为你的实验生成部署和运行工作流。
一旦代码进入 Github,它就会自动在你的节点上部署代码。
然后你通过 Github 访问实验的运行界面,启动实验并保存检查点。
我们遵循标准的 PyTorch 工作流。因此,你可以加入我们提供的任何内容之外的东西,deepspeed、accelerate,或者从头实现你自己的自定义 PyTorch 分片。
不再需要不同版本的 PyTorch、nvidia 驱动、数据处理库。你可以轻松地编排实验及其环境,文档化并跟踪所有依赖项的具体版本和配置,以确保可重复性。
不需要为你的实验定义 600 个参数。不再需要 YAML 魔法。你可以在任何时候使用任何你想要的东西。我们只是引入了一个简单的接口来定义你的实验。我们甚至走得更远,现在你只需要设计交互方式。
我们需要你拥有的节点:
具有 sudo 权限的非 root 用户(需要无密码)
我们已测试过的云平台:
如果你在其他云平台上遇到任何问题,请随时提交 issue。
在这里你可以找到关于如何设置节点和开始训练的快速入门指南。
初始化项目
设置环境
是时候设置你的节点了!
运行你的第一个实验
系好安全带,是时候部署了!
大型语言模型训练中常见任务的 API。
使用分布式模型
优化模型参数
训练稳定化技术