
8.0
热点
AI SCORE
模型发布2026-10-07 03:47
Google 开源 EmbeddingGemma 2:740M 参数端侧向量模型,191MB 内存跑离线 RAG
The Decoder#Google#开源#端侧AI
Editor brief · 编辑速览
Google 发布 7.4 亿参数的 EmbeddingGemma 2,支持文本/图像/视频/音频/代码向量化,在部分任务上超越两倍体量模型。搭配 Gemma 4 可完全离线运行,无需数据上云。
Google 发布了 EmbeddingGemma 2,这是一款开源模型,能够将文本、图像、视频、音频和代码转换为数值向量,从而更方便地查找和比较相似内容。Google 表示,这款模型拥有 7.4 亿参数,是同类中最紧凑的模型,在多模态嵌入基准测试中优于参数规模高达其两倍的竞品。
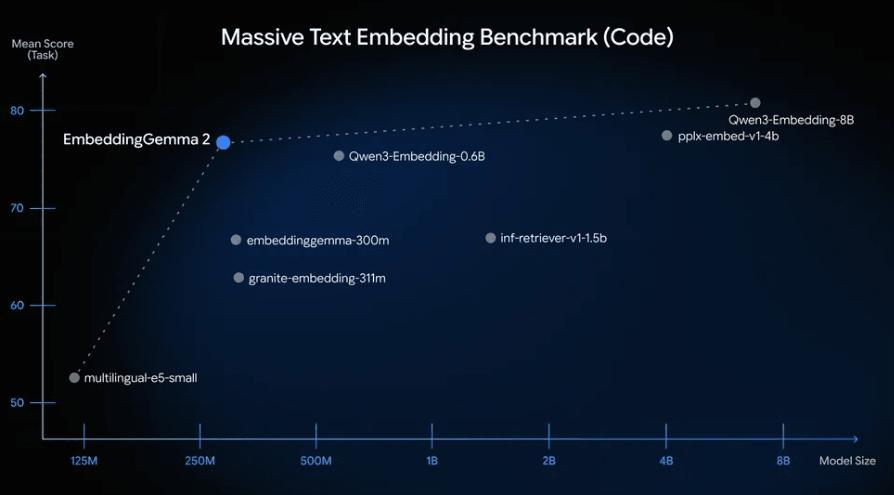
EmbeddingGemma 2 在 Massive Text Embedding Benchmark(Code)上得分为 78.68,比前代模型(68.76)提升了近 10 分。这使其与规模更大的模型处于同一水平线。
该模型无需 API 密钥即可本地运行。通过 WebGPU 在浏览器中运行,每次查询耗时约 20 至 70 毫秒。内存占用仅需约 191 MB,本地向量数据库存储空间最高可缩减至原来的六分之一。对于纯文本任务,2.7 亿参数版本已足够使用。
配合 Gemma 4 等小型开源模型使用,EmbeddingGemma 2 可以运行离线 RAG 应用,无需将数据发送到外部服务器。模型权重已在 Hugging Face 和 Kaggle 发布,同时提供开发者指南和文档。