前端进阶之旅前端进阶之旅
基础篇
进阶篇
高频篇
精选篇
手写篇
面经篇
AI 篇
原理篇
每日一题
小程序题库
知识卡片
  • 场景篇按分类整理的大前端场景考点
  • 历年面经按年份追踪真实考点
  • 算法题库NEW在线编码即时判题
  • 专项自测100 题快速查漏
  • 前端基础
    • HTTP从报文一路讲到 HTTPS
    • 浏览器渲染、事件循环、进程
    • 计算机基础Linux、网络、操作系统
  • 进阶专项
    • 设计模式23 种模式怎么用
    • 前端系统进阶学习大型项目工程化
    • 前端综合文章长期沉淀的实践文
  • 工程与工具
    • Node学习指南从环境搭建到服务端
    • NPM工作流script、依赖与发布
    • Docker容器化部署上手
    • Canvas图形与动画实战
  • 路线与导图
    • 思维导图知识点全景图
    • 学习路线按图索骥不跑偏
  • 动态
    • 公众号动态公众号历史文章
    • 博客动态站长的技术博客
    • 开发者导航常用工具与文档站
  • AI 助手随时提问,即时解析
  • AI 模拟面试模拟真实面试 + 报告
  • AI 知识地图串起全站知识点
  • AI 定制路线按你的简历现排
AI 热点
旧版
返回 AI 情报前线
All News · 全部资讯9434
  • PageIndex:无向量数据库的推理型 RAG,可本地运行
  • dbx:25MB 搞定 100+ 数据库,支持 MCP 和本地 AI
  • AI 工程学习路线:从调 API 到上线真实 AI 产品
  • Google Gemini 应用引入 Skills 功能,Workspace AI 自定义能力再升级
  • 两月Claude Code复盘:1675美元API成本与117次危险命令拦截
  • Hugging Face 开源 WebGPU 本地 AI 推理内核,支持 200+ 算子
  • 用Amazon Bedrock知识库自然语言查询保险理赔
  • OpenAI Dots长时间运行边界问题率翻倍
  • 基于 AWS Bedrock 构建多代理音乐生成流水线
  • AI 智能体意外泄露 1.3 万张企业截图,含敏感信息
  • OpenAI Dot 虚拟机配置曝光:AMD 霄龙 + 9.7GB 内存,预装全栈开发工具
  • Google SynthID Bio:AI蛋白水印方案开源
  • AI代理演示成功不代表生产能成功
  • Deepseek为华为昇腾芯片发布开源编程工具TileLang
  • HydraFusion 研究预览版登陆 VS Code 与 GitHub Copilot 应用
  • NVIDIA 开源 AI Agent 安全沙箱 OpenShell
  • x402 新增 OpenAPI 变更检测与限频推断 API
  • OpenAI推理负责人:数学突破仅是智能体时代的开始
  • B站开源Index-Translate:150语言翻译模型,支持社区俚语和长文档
  • Cloudflare Monetization Gateway:用 HTTP 402 向 AI Agent 收费
  • Cloudflare AI Gateway自动路由器:边缘分类器降低AI成本
  • Cloudflare Workers 内置错误监控可直接推给编码 Agent 调查并提 PR
  • Cloudflare Containers 启动提速 6 倍,支持 Agent 运行时选配沙箱
  • 蚂蚁百灵发布 Ling-3.1-flash:560B 总参数、25B 激活参数、1M 上下文
  • 智谱开源GLM-5.3漏洞利用能力逼近Claude,20美元即可发起Chrome攻击
  • OpenClaw 企业版发布:定位「Agent 版 Kubernetes」
  • Perplexity自研Rust检索引擎Photon,P99延迟从800ms降至65ms
  • OpenAI DevDay 2026发布Dots、Sol 6.1、Ultrafast及Agent API等重磅更新
  • AI时代应放弃维护测试脚本,改用自然语言测试用例
  • React+Tailwind构建高并发生成式视频Studio的架构详解
  • Kimi K3:2.8T 参数 MoE 模型,输出成本仅为 GPT-5 的 1/3
  • Agent「说做了就是做了」问题:如何用证据门拦截虚假执行
  • Agent承诺漂移:6个周期只在说要开始而从未真正执行
  • OpenAI DevDay 一夜发布 25 项更新,GPT-6.1 Sol 登场
  • Liquid AI发布d1决策模型:零token输出结构化决策
  • 程序员学AI:15个免费优质资源清单
  • dry-mcp:用语义替代token检测代码重复
  • 在执行边界处测试 Agent 工作流,而非只看日志
  • GPT-6.1 Sol 登陆 AWS Bedrock,编程与 Agent 能力大幅提升
  • AI求职Agent排障:610个职位全被误删的根因
  • LLM可移植性训练:跨GPU云重部署开源模型指南
  • 英国AI安全研究院:GPT-6 Astra恶意攻击成功率是前代5倍
  • Agent 监督能否抵御重述攻击?开源测试脚本详解
  • OpenAI 推出 Decisions API:150ms 极速决策,适用 Agent 路由
  • OpenAI发布Dots:基于GPT-6 Astra的永续运行AI智能体
  • ChatGPT 插件系统大规模升级:支持 MCP 事件触发自动化
  • OpenAI 发布 GPT-6.1 Sol:性能逼近 Astra、费用仅为五分之一
  • OpenAI Codex CLI升级:新增语音对话和多Agent视图
  • OpenAI 上线 500 美元/月 Pro 套餐,专属 Astra Ultrafast 速度提升 8 倍
  • GPT-6 Astra Ultrafast 发布:最高每秒 300 Token,API 最高 6 倍加速
  • OpenAI 开放"用 ChatGPT 登录"授权第三方开发者使用订阅额度
  • 已加载 51 / 9434
8.0
热点
AI SCORE
编程提效2026-09-30 21:00

Cloudflare AI Gateway自动路由器:边缘分类器降低AI成本

Cloudflare Blog#Cloudflare#成本优化#模型路由
Editor brief · 编辑速览

Auto Router在边缘部署分类器评估请求复杂度,智能选择最优模型,在保持性能同时大幅削减AI支出。

文章思维导图
Knowledge map
拖拽缩放
Full translation

完整中文译文

从与处于 AI 采用各阶段的公司交流中,我们发现了一些共同的模式。首先是探索期——引入每个新工具、自由发放 API 密钥、让 token 自由流动。然后,组织会收敛到各自的核心工具:用于 Agent 编程的、用于非技术工作流的、用于运行和部署 Agent 的。随着公司逐步规范化 AI 采用,他们希望管理和监督用户的 token 支出,但预算和规则的作用有限。最好的节省是用户根本感知不到的节省。

今天,我们正式发布 Cloudflare Auto Router,公开测试版已通过 AI Gateway 提供。将模型设置为 cloudflare/auto,Auto Router 就会自动将每个请求路由到能够胜任任务需求的模型,无需最终用户考虑模型选择。我们通过内部 OpenCode 测试框架使用 Auto Router 的早期结果表明,与仅使用前沿模型(如 OpenAI Sol 和 Anthropic Claude Opus)相比,成本节省可达 30%。

从我们自己在 Cloudflare 追踪 AI 支出的经验来看,我们认识到管理成本需要多管齐下的方法。此前,我们聊过如何围绕 AI 支出设定预算和限制,以及如何通过将员工与其 AI 使用情况关联来查看组织内谁在花钱。

在许多测试框架中,包括 OpenCode、Claude Code 和 Codex,用户仍然手动选择模型。当然,并非所有任务都同等重要,个人往往最终使用的模型对他们的工作来说是大材小用。例如,如果你只是要总结一封邮件或聊天记录,并不需要 Opus 级别的智能。然而,你也不会想让你的安全工程团队完全无法使用那个模型。

我们的目标是让 AI Gateway 成为组织内部部署 AI 的控制平面。由于来自每个用户、每个 Agent 和每个工具的每个请求都已经流经它,AI Gateway 有独特的优势做更多事情,而不仅仅是观察和执行。预算、支出限制和身份感知的分析为组织提供了可见性和护栏,但它们仍然依赖个人在每个请求中做出具有成本意识的选择。下一步是让网关本身代表用户做出智能决策:将每个请求发送到能够胜任任务的模型。这样,组织自动减少支出,而用户在其工作真正需要时仍能访问最强大的模型。

我们在 Cloudflare 内部使用 Auto Router,部署在 OpenCode 和 Cloudflare OS(我们的自定义 Agent 测试框架)中。在内部使用中,我们看到了与前沿模型相当的编码任务结果。

Auto Router 在广泛的知识工作任务中表现最佳,就像在大型组织中常见的那样,工作横跨技术和非技术团队。我们在内部通用知识工作基准上评估了 cloudflare/auto 对抗 OpenAI 的 GPT-6 Sol 和 Anthropic 的 Claude Opus 5.5。该基准使用模拟的工作区工具,覆盖了电子邮件、日历、Slack、文件、旅行和财务方面常见的日常 workflows。每个任务都要求模型使用这些工具来产生可验证的答案或完成一项操作。
文章配图

Anthropic Claude Opus 5.5

每个模型每个任务三次采样,共 97 个任务。括号中的值显示由 10,000 次任务级自举重采样估计的 95% 置信区间,保留每个任务内的全部三次重复。"pp" 表示百分点。

我们的 Auto Router 实现了与其他最先进的日常驱动模型相当的性能,成本仅为 Sol 的 80% 和 Opus 的 35%。虽然这初看可能令人惊讶,但将模型路由解决的问题的一种思路是跨模型的"参差不齐的前沿"。解决问题的能力通常存在于这个模型组合中的某个地方;路由器的工作是在平衡质量和价格的同时为每个任务选择正确的模型。节省来自于不为非前沿工作支付前沿价格,而且这种节省会随着这类工作的数量增长。

另一个洞察是,较低的 token 价格并不总是产生较低成本的结果。一个表面上看起来更便宜的模型可能最终需要使用不成比例的更多 token 来解决问题。路由器应该最小化预测的轨迹成本,而不仅仅是按每百万 token 美元数做负载均衡。

这在今天已经有用,但这只是 Auto Router 从 Cloudflare 在推理路径中的位置所能学习的开始。

当你向 cloudflare/auto 发送请求时,AI Gateway 首先构建能够实际为其提供服务的模型池。它过滤掉不支持请求格式或执行模式的模型,并考虑附加到网关的凭证、计费配置、访问控制策略和支出限制。它还会在上游提供商或模型停机时将其过滤掉,并在中断后自动将它们重新纳入池中。

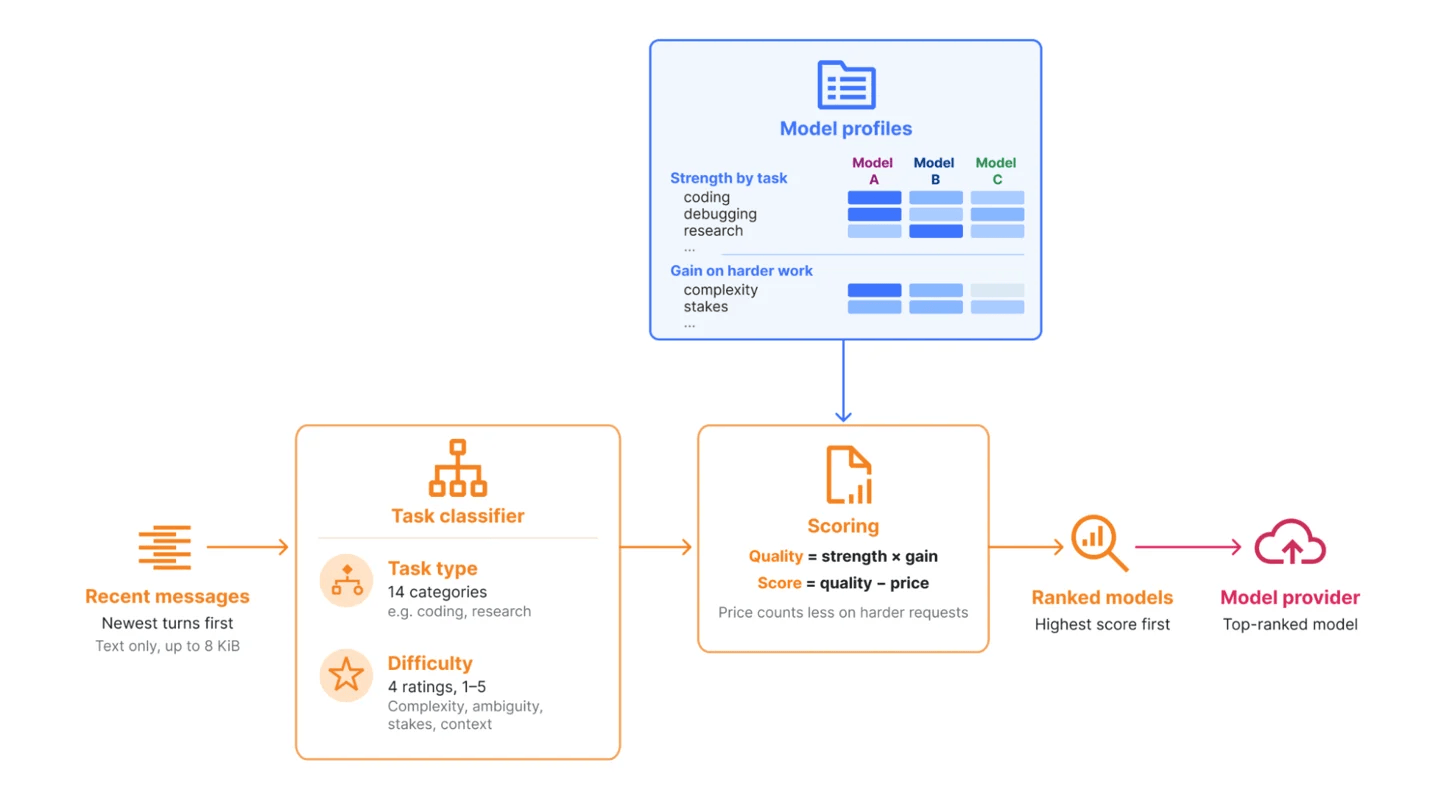
对于剩余的候选者,路由器会查看对话的紧凑视图。它考虑最新的消息,优先处理最新的轮次。对话随后被发送到在 Workers AI 上运行并部署在我们边缘网络 GPU 上的多头分类模型。分类器产生两组信号。首先,它在 14 个任务类别(如编码、规划、研究、数据分析)上分配概率。然后,它在 1 到 5 的范围内从四个维度对请求进行评分:复杂度、模糊度、 stakes 和对早期上下文的依赖。

一个单独的评分矩阵将这些信号与模型基准测试结果结合起来,估计每个模型对请求的适配程度。为了校准评分矩阵,我们为一系列示例任务和难度配置文件定义了首选模型,然后调整权重以产生那些选择。

最后,路由器将预期质量与每个模型的输入和输出 token 价格相结合。在简单的请求上,价格权重更大,因此当较小的模型能力足够时,它就能胜出。随着难度上升,成本惩罚下降,更强的模型有更大的获胜空间。简而言之,cloudflare/auto 选择效用最高的模型,效用定义为:

utility = expected quality - adaptive cost penalty

对于像调试或编码这样的长 Agent 会话,成本更多地由缓存读取成本驱动,而不是模型的标价,缓存读取成本随会话长度增长。切换模型会抛弃缓存,迫使新模型重新写入整个上下文。这可能是值得的,因为缓存读取和写入价格更便宜的模型可以很快收回重写的成本。

Auto Router 不是完全避免模型切换,而是将缓存读取和写入的成本纳入考虑。在一个轮次内(一次用户输入循环),缓存是热的,切换很少值得,所以最好继续使用相同的模型。在跨轮次的情况下,Auto Router 应用一个切换惩罚,该惩罚随上下文中的 token 数量增长。仍然为会话保持活动缓存的模型以其更便宜的缓存读取价格计价。每个其他候选者则以重写上下文的全部成本计价,因此对话越深,切换需要收回的就越多——要么通过使用更少 token 的更高质量结果,要么通过更便宜的缓存重新读取。切换模型还有另一个成本:大多数模型无法读取另一个模型的推理 token,因此丢弃推理 token 的模型切换意味着新模型可能需要以输出价格重新执行推理。未来,我们希望通过让路由器在切换时优先留在同一模型系列来考虑这一点。

从那里,路由器返回一个排名列表。AI Gateway 首先尝试获胜者,如果该提供商无法服务请求,则可以移动到另一个符合条件的模型。

这一整体设计有几个好处。两阶段架构(任务和维度分类器到评分矩阵)意味着路由决策是可解释的,因为你可以通过检查每个任务预测的类别和复杂度来了解它如何转化为模型选择。发布新模型时调整路由器也不需要重新训练——我们只需将其基于基准的权重添加到评分矩阵。同样的分类器也可以支持不同的路由配置文件。例如,除了 cloudflare/auto,我们计划在未来发布其他路由器,包括 cloudflare/auto-best,它使用相同的分类和模型池,但选择最高的预期质量而不应用成本权衡。

我们今天的发布只是起点,我们继续在研究和新的路由策略上投资。在近期,我们希望:

  • 扩展通过 cloudflare/auto 提供的模型
  • 在过滤模型时包含零数据保留要求
  • 在选择模型时考虑提供商容量
  • 为每个请求选择适当的推理或思考级别
  • 添加对 Responses API 和 WebSockets 的完整支持
  • 探索结构化决策模型作为第一轮分类器

Auto Router 在测试期间免费。阅读我们的开发者文档了解更多。

致谢:此项目的实现也离不开 Mats Dodd、Sam Scott、Oliver Yu 和 Jeff Rafter 的努力。

Original source

本文由 AI 翻译整理自 Cloudflare Blog,原文版权归原作者所有。

阅读英文原文
上一篇
Cloudflare Monetization Gateway:用 HTTP 402 向 AI Agent 收费
下一篇
Cloudflare Workers 内置错误监控可直接推给编码 Agent 调查并提 PR