EKS 新沙箱为每个 Pod 提供虚拟机隔离
据文中介绍,AWS Nitro Sandboxes 可通过 Pod 运行时配置启用独立轻量虚拟机,并提供结合证明文档释放密钥的机密运行模式。文章还说明编码智能体的出站白名单、身份配置和共享资源限流。
AI 深度解读
AWS Nitro Sandboxes 想解决一个很具体的问题:让 Kubernetes Pod 保持原来的部署方式,同时拥有独立虚拟机的隔离边界。按原文介绍,AWS 于 2026 年 11 月 9 日发布这项 EKS 功能,在 EKS Auto Mode 中,Pod 增加一个字段就能启用。
对运行 AI 编程代理、多租户任务和构建作业的团队,它提供了比共享内核更强的隔离选择。但虚拟机解决不了所有问题:代理能访问哪些服务、拿到什么凭证,以及共享节点会不会被拖慢,仍然需要单独设计。
一个字段,究竟改变了什么
普通容器共享宿主机操作系统内核。这样启动快、资源开销小,但内核漏洞也可能把单个容器的问题扩大到整台机器。给敏感任务单独分配 EC2 实例可以缩小影响范围,代价是机器经常吃不满。
Nitro Sandboxes 的做法是在 Nitro Partition 内启动轻量虚拟机,把 Pod 放进去。CPU 和内存边界由 Nitro Hypervisor 在硬件层强制执行,节点上的 kubelet 仍然把它当作普通 Pod 管理。
在 EKS Auto Mode 中,通过 kubectl get runtimeclass 可以看到两种运行时类别。Pod 设置 runtimeClassName: isolated-sandbox,就选择了其中的隔离模式。RuntimeClass 自带节点选择器和容忍配置,调度器据此把任务放到支持沙箱的节点。
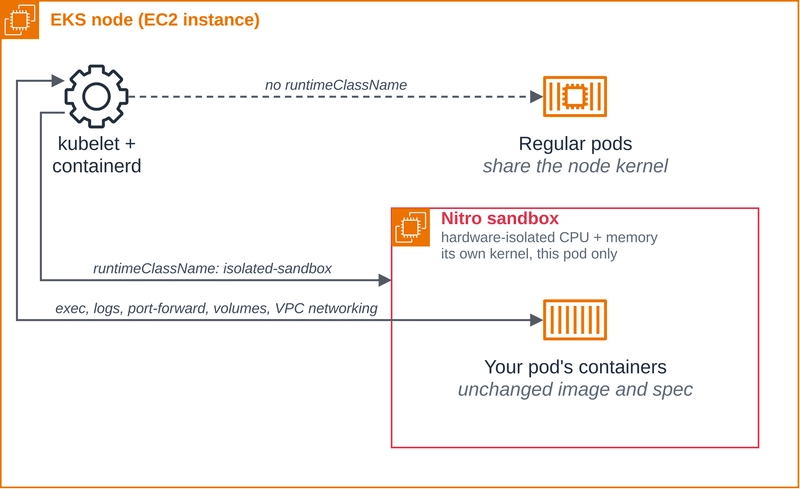
启动过程可以沿着一条链理解:调度器放置 Pod,EKS 请求 EC2 创建 Nitro Partition 并启动虚拟机,虚拟机内的组件接收 Pod spec 和 Cedar 策略,检查即将执行的内容是否被允许,然后拉取镜像,通过标准容器运行时启动容器。Cedar 在这里承担的是策略检查工作。
日志、exec、port-forward、探针和指标通过内部控制通道回到 kubelet。Pod Identity、EBS、EFS、CSI 卷、CloudWatch 指标和 VPC CNI 网络仍沿用现有集成,镜像、Helm chart 和部署流水线也可以继续使用。
AWS 声称它通过了全部 Kubernetes 一致性测试。不过,这项结论主要回答兼容性问题,不能直接回答启动开销、应用性能或隔离强度。标准 EKS 还有额外门槛:需要准备支持沙箱的 AMI,并非所有集群都能直接加字段启用。
两种模式,分别防谁
isolated-sandbox 主要保护宿主机和其他 Pod,防止容器内部运行的代码越过边界。AI 代理执行生成的代码、多租户 SaaS 执行客户任务、构建系统运行特权作业,都属于原文列出的适用场景。
confidential-sandbox 又增加了一层假设:集群的运营者也不可信。
在这个模式下,密码学证明(attestation)描述沙箱的系统镜像及配置的 Cedar 策略。AWS KMS 只有在证明文档符合预期时才释放秘密。AWS 还声称,该设计能够防止集群管理员读取 Pod 内存。
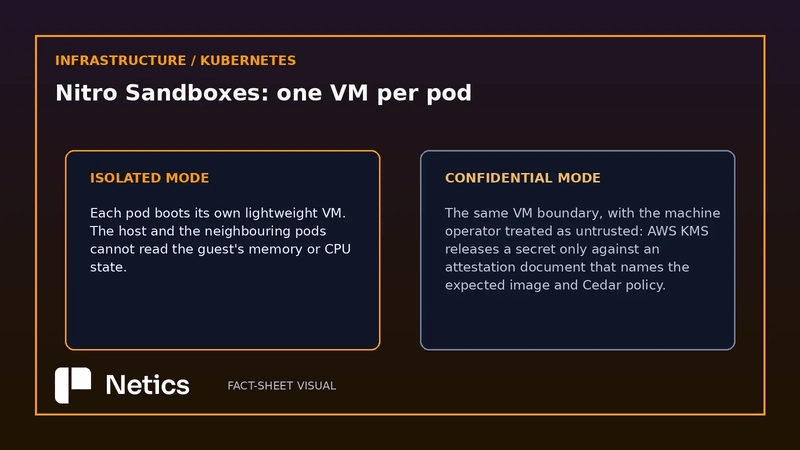
选择运行模式之前,要先说清楚自己不信任的是工作负载,还是连集群管理员也不信任。
两种模式并不是简单的安全等级高低。前者处理不可信代码向外突破的问题,后者还涉及敏感数据向谁开放的问题,团队需要维护预期镜像、策略和秘密释放条件。
原文提到 HIPAA、PCI DSS、FedRAMP 等场景,因为证明文档可以提供工作负载状态的密码学证据。但这不等于开启机密模式就完成了合规要求,文章也没有给出完整的合规控制映射。
AI 编程代理的权限,仍然要一项项收紧
原文最有参考价值的部分,是一个读取 GitHub issue、修改代码、运行测试并提交 pull request 的代理示例。它把模型权限、仓库权限和网络出口分别声明。
模型访问通过 Pod Identity 获取 IAM 权限,范围限定为 bedrock:InvokeModel*,不使用长期 API key。仓库访问使用短期、细粒度 token,以 Secret 挂载,只覆盖一个仓库:Contents 和 Pull requests 可读写,Issues 只读。如果希望 pull request 显示机器人作者,原文指出示例需要使用 GitHub App token。
网络出口由 EKS Auto Mode 的 ApplicationNetworkPolicy 控制,只允许访问 CoreDNS,以及 Bedrock、GitHub 指定主机名的 HTTPS 服务。这里没有直接使用标准 Kubernetes NetworkPolicy,因为后者不能按主机名匹配。
策略生效还有一个配置条件:kube-system 中的 amazon-vpc-cni ConfigMap 要设置 enable-network-policy-controller: "true"。仅仅写出策略对象,并不能跳过这一步。
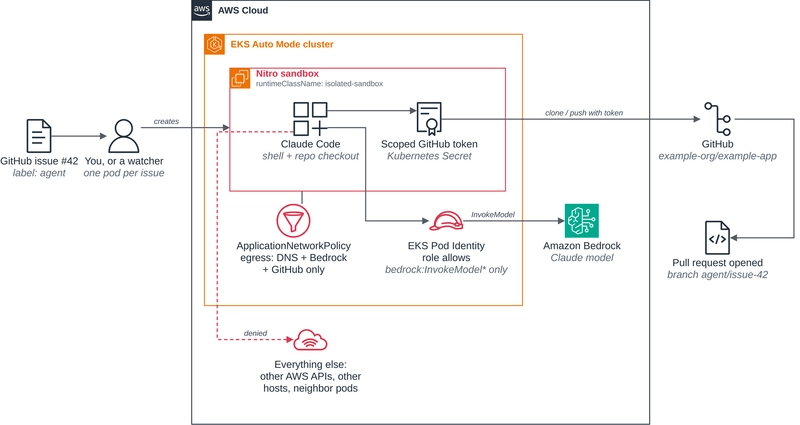
出口规则也有明确局限。原文指出,如果另一个域名解析到与允许域名相同的地址,它仍可能可达。允许的服务前面若有 CDN 或共享云端点,实际开放的访问范围就可能比域名列表看起来更大。
节点资源同样没有全部独占。CPU 和内存按沙箱隔离,但网络带宽、磁盘 I/O、DNS 查询、日志输出和连接跟踪表项仍经过共享路径。AWS 默认对这些资源启用可配置节流,目的是让失控代理先撞到自己的上限,减少对邻居的影响。
硬件隔离限制代码能突破到哪里,权限与出口规则决定代码获准做什么。
我的判断
方向是合理的。对已经使用 EKS、又必须执行不可信任务的团队,保留现有 Kubernetes 管理方式,同时把 Pod 的内核风险隔开,比为每个任务维护完整独立实例更有吸引力。
但原文没有给出与普通容器、独立 EC2 实例的性能及成本对照,也没有展示多租户高负载下的实测结果。它关于资源利用率和采用价值的判断,主要来自架构推演及 AWS 的产品说明,不能当作已经验证的收益。
原文提到 SIG 项目 agent-sandbox 可以维护预启动虚拟机的热池,约两秒即可领取;还列出 Temporal 将沙箱作为计算提供方,以及为远程 IDE 分配独立虚拟机的用法。这里的「约两秒」指领取已预启动的虚拟机,不能拿来代表任意 Pod 的冷启动时间。
验证方式也需要分层看待。检查 /sys/class/dmi/id/product_name 得到 8i.enclave,以及看到 vda、vdb、vdc,可以支持容器位于虚拟机内的判断;普通 Pod 的对照输出是 nvme0n1、nvme1n1 和 zram0。但这些设备信息不足以独立证明隔离边界不存在漏洞。
同样,设置 sandbox.amazonaws.com/network-isolated: "true" 后检查只剩 loopback 接口,可以验证断网配置。它与出口访问测试都适合重复执行,却不能替代权限审查和完整安全评估。
能拿来做什么
- 如果团队在 EKS 上运行 AI 编程代理,可以先选一个只操作单仓库的任务,使用
runtimeClassName: isolated-sandbox,再分别限定模型调用权限、GitHub token 和网络出口,验证任务所需的最小访问范围。 - 如果现有方案是每个客户独占 EC2 实例,可以用真实工作负载比较节点利用率、启动时间和共享 I/O 表现,再判断是否值得改成一个节点承载多个沙箱。
- 如果任务涉及不能向集群管理员开放的秘密,应评估
confidential-sandbox的证明与 KMS 释放流程,并明确由谁维护预期镜像和 Cedar 策略。 - 把虚拟机标识、块设备、断网注解和出口访问检查加入节点镜像更新后的验收流程,同时验证网络策略控制器确实开启,避免配置存在而约束未生效。