模型剪枝能否提速,关键看硬件支持
文章比较固定零值分布的 2:4 结构化稀疏与非结构化剪枝,解释参数减少为何不一定带来推理加速。前者便于受支持硬件跳过计算,后者虽可获得更高稀疏度,却受不规则访问和内核支持限制。
AI 深度解读
把模型里 90% 的权重变成零,推理就会快很多吗?原文的回答是:未必。决定收益的,是 GPU 能不能跳过这些零,以及跳过它们要付出多少额外成本。作者因此更看好有硬件支持的 2:4 结构化稀疏,用它换取实际吞吐提升。
这篇适合正在评估模型部署成本的程序员读。它把「压缩了多少」和「服务快了多少」拆开了,但没有提供具体模型、硬件和测试配置,结论应当作为选型思路,而非性能承诺。
为什么零更多,推理却没有更快
剪枝(pruning)就是删除一部分模型权重。原文比较的是两条路线,它们都减少模型名义上需要的乘加运算,也都需要通过重新训练或微调恢复质量。
2:4 结构化稀疏要求每组四个权重中,恰好两个非零。它限制了零的位置,支持这种模式的加速器便能按固定规则跳过一半计算,不需要在运行时进行额外的索引运算。
非结构化幅值剪枝则按权重大小删除,不限制零出现在哪里。它更自由,可以做到 80% 至 90% 的权重为零,但普通稠密计算内核仍会执行与零相乘的运算。
权重变成零,只完成了剪枝;计算内核真正跳过零,才可能获得推理收益。
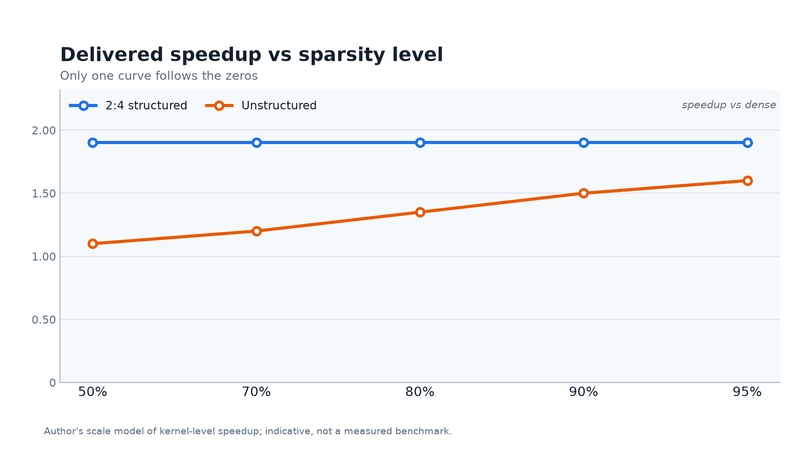
非结构化剪枝要兑现计算节省,通常需要专用内核,把保留下来的权重收集起来再计算。这个过程涉及不规则访存,会消耗内存带宽,可能吃掉省下来的时间。
可以把它理解成处理一个数组:元素变少了,但如果每次读取都要绕路找位置,整体未必更快。
2:4 的两倍吞吐,为什么不是服务快两倍
原文认为,在支持的 Tensor Core 上,2:4 能跳过一半数学运算,让计算受限层的吞吐大约翻倍。这里有两个条件:硬件支持这种稀疏模式,而且被优化的层主要受计算能力限制。
这不是整个聊天服务的延迟保证。
如果瓶颈在内存访问,减少乘加计算未必能解决问题;即使某个层提速,服务里其他部分的耗时也不会自动消失。原文没有给出端到端延迟数据,也没有说明具体硬件、模型和批次配置,因此不能把「层吞吐约两倍」直接写成「请求耗时减半」。
精度上,固定模式也有代价。作者认为,在相同的 50% 稀疏率下,非结构化剪枝更容易恢复精度,因为它能保留重要权重;2:4 必须满足位置约束,有时会删掉某层需要的权重。
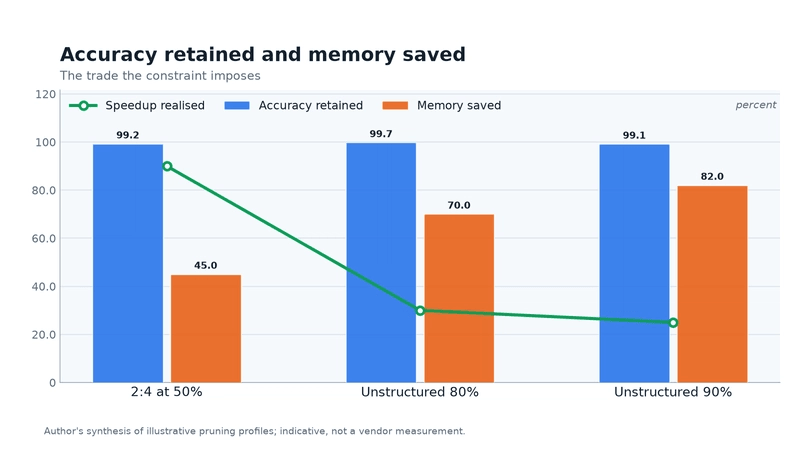
作者还声称,大模型在非结构化剪枝达到 90% 时,精度仍可能保持得不错。但原文没有交代模型规模、任务指标和恢复训练成本。这个判断可以作为进一步验证的方向,不能当作所有模型都适用的规律。
两种路线的取舍因此很明确:2:4 用剪枝自由度换取硬件可执行性;非结构化剪枝更容易追求极高稀疏率,却要另行解决执行效率。
真正决定落地成本的是工具链
原文偏向 2:4,还有一个工程原因:近期部分加速器的厂商库已经提供支持,团队可以通过导出掩码(mask)并调用对应内核来使用它。掩码就是记录哪些权重保留、哪些归零的标记。
不过,原文没有列出具体加速器型号、库版本或调用 API。「调用对应内核」是路线说明,还不是可以照着执行的部署教程。
非结构化剪枝的后续工作更重,可能涉及专用内核、自定义数据布局,以及针对不同张量形状逐一调优。作者还指出,每层收集权重的模式不同,会增加批处理适配的复杂度。
因此,公平比较不能只报稀疏率。应在实际部署硬件上,固定精度目标和批次形状,同时计算内核开发、内存流量、精度恢复训练的成本。
作者进一步推测:如果到 2029 年,稀疏推理成为成本敏感型服务的常规选择,剪枝、掩码管理和稀疏内核工具可能形成每年 $1B 至 $4B 的市场,且主要打包在加速器软件栈中。原文也要求把这个数字当作量级估计,并未给出测算依据。
我的判断
我认同作者最有用的判断:先确认部署硬件和计算内核能执行什么,再决定剪成什么形状。对于承担在线推理的团队,能否增加请求吞吐、降低延迟,比一个漂亮的稀疏率更有意义。
但「2:4 今天更适合交付吞吐」仍有明确边界。原文没有给出同模型、同精度、同批次配置下的对照测试,图表也没有配套测试信息。它是一篇工程判断文章,不是一份足以支撑采购或容量规划的基准报告。
相较继续使用成熟稠密内核,非结构化剪枝是否划算,要看压缩收益能否覆盖额外工程成本;相较非结构化剪枝,2:4 是否占优,则取决于硬件支持和实际瓶颈。对没有原生支持的部署环境,不能照搬作者的偏好。
能拿来做什么
- 如果你负责聊天应用或 Node 推理网关,评估服务方案时要询问实际硬件、是否启用稀疏内核,以及对应的请求吞吐和延迟数据,别只比较模型文件大小。
- 如果团队准备自行部署剪枝模型,先确认加速器和厂商库支持的稀疏模式,再投入微调与掩码生成,避免训练完成后才发现执行路径不支持。
- 做性能验证时,固定模型质量目标和批次形状,把层级加速与端到端耗时分开记录,同时计入精度恢复和内核维护成本。