用Bedrock结构化输出提取票据数据
教程使用 Python 调用 Amazon Bedrock Converse API,让 Claude 从收据图片提取数据,并通过 outputConfig 指定 JSON Schema。重点是用接口层面的格式约束减少 Markdown 包装、字段缺失和类型不符等解析问题。
AI 深度解读
把小票图片交给模型识别不难,难的是让后端每次都收到能直接处理的数据。作者用 Amazon Bedrock Converse API 和 Python 演示了一条路径:把 JSON Schema 放进 outputConfig,让输出格式由接口约束,而不是靠提示词反复叮嘱。
这篇值得看的地方,是它把「能解析」「字段齐全」「金额正确」拆开了。示例只有一张小票,但已经暴露出接入业务时很容易忽略的问题:JSON 合法,不代表模型理解了你的字段含义。
为什么「只返回 JSON」还不够
作者最初也在提示词里要求模型只返回 JSON。多数调用能成功,偶尔却会带上 Markdown 代码围栏、解释文字,或者漏掉不确定的字段。
这里需要纠正原文的一处混淆:代码围栏和额外文字可能让 json.loads() 抛出 JSONDecodeError,但缺少字段、把数字写成字符串,仍可能是合法 JSON。它们更可能在后续取值、计算或校验时出问题。
因此,后端需要的其实有两层保证:首先能解析,其次符合约定的数据结构。
结构化输出(Structured Output)的做法,是把字段、类型和必填要求写入 JSON Schema,再通过请求参数提交。提示词负责告诉模型做什么,Schema 负责规定结果长什么样。
作者为小票定义了四个顶层字段:商店名 store、日期 date、商品数组 items 和总额 total。每件商品包含名称 name、整数数量 quantity 和数值价格 price。
其中两项约束最关键:
required规定字段必须出现,顶层对象和商品对象都要分别声明。additionalProperties: False禁止对象出现 Schema 之外的字段,同样需要在对应对象层级设置。
接口约束能解决输出结构问题,不能替你保证图片里的信息被读对。
图片和 Schema 怎样一起交给 Converse API
作者的运行前提是:有 AWS 账号,aws login 可用,在 us-east-1 区域调用,并且账号已启用 Claude。首次使用 Anthropic 模型时,Bedrock 可能要求填写简短的用途表单。
Converse API 的消息内容是一个区块列表。作者把图片区块放在前面,文本指令放在后面,两者属于同一条用户消息。图片以二进制读取,在这段 boto3 调用中,不需要手动做 Base64 编码,也不需要先上传 S3。
下面这段完整代码解决了图片提交、结构约束和结果解析三个环节:
import sys, json
sys.path.insert(0, __file__.rsplit("/", 2)[0])
import boto3
from config import REGION, CLAUDE, DATA

bedrock = boto3.client("bedrock-runtime", region_name=REGION)
image = open(f"{DATA}/receipt.png", "rb").read()

schema = {
    "type": "object",
    "properties": {
        "store": {"type": "string"},
        "date": {"type": "string", "description": "YYYY-MM-DD"},
        "items": {"type": "array", "items": {"type": "object", "properties": {
            "name": {"type": "string"}, "quantity": {"type": "integer"}, "price": {"type": "number"}},
            "required": ["name", "quantity", "price"], "additionalProperties": False}},
        "total": {"type": "number"},
    },
    "required": ["store", "date", "items", "total"],
    "additionalProperties": False,
}

response = bedrock.converse(
    modelId=CLAUDE,
    messages=[{"role": "user", "content": [
        {"image": {"format": "png", "source": {"bytes": image}}},
        {"text": "Read this receipt and extract the data."},
    ]}],
    outputConfig={"textFormat": {"type": "json_schema", "structure": {"jsonSchema": {
        "name": "receipt", "schema": json.dumps(schema)}}}},
)

data = json.loads(response["output"]["message"]["content"][0]["text"])
print(json.dumps(data, indent=2))
print("Items:", len(data["items"]), "· total:", data["total"])
重点看 json.dumps(schema):这里按原文给出的接口格式,把 Schema 序列化成字符串传入;返回的 JSON 文本则从 response["output"]["message"]["content"][0]["text"] 取出,再交给 json.loads()。
原文执行命令是 python genai/a04_receipt.py。这段代码依赖仓库内的 config 模块,REGION、CLAUDE、DATA 都从那里读取,不能只复制单个文件就假定能运行。原文没有给出 Claude 的具体模型 ID,也没有交代 boto3 版本。
日期描述中的 YYYY-MM-DD 也要分清作用:它是在指导模型如何填写日期。这份 Schema 只把日期声明成字符串,没有用额外约束验证日期格式或日期是否真实存在。
一张小票,怎样暴露价格字段的歧义
作者实际测试的是仓库里的 BrightCart 小票,包含三项商品、税费,总额为 207.83 美元。
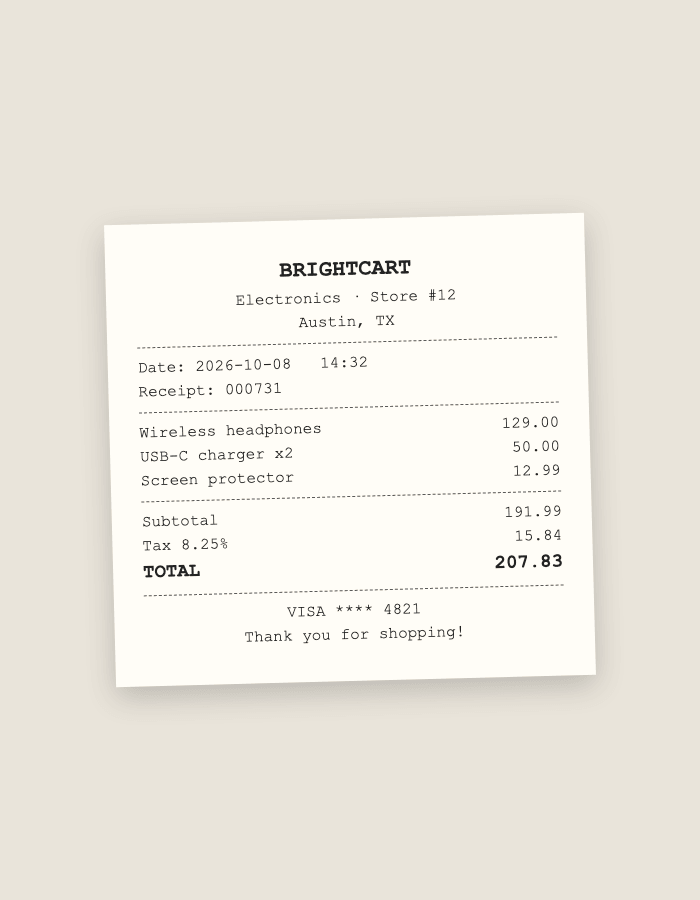
模型返回了商店名 BRIGHTCART、日期 2026-10-08,以及三项商品:
Wireless headphones:数量 1,价格 129.0。USB-C charger x2:数量 2,价格 50.0。Screen protector:数量 1,价格 12.99。
三项价格相加,129 + 50 + 12.99 = 191.99,与总额的差值为 15.84,作者指出这对应小票上的税费。因此,这次样例的数字能够对上。
但充电器这一行很有代表性:数量是 2,价格却是 50.0,因为这里返回的是整行金额,每个充电器实际为 25。Schema 只写了 price,没有说明要单价还是行金额,模型选择了小票上印出的行金额。
如果需要单价,作者建议明确描述:
"price": {"type": "number", "description": "price of ONE unit"}
要注意的是 description 这一行,它补的是字段含义。相应的计算代码也必须一起调整:按行金额求和时直接累加 price,按单价计算时则要结合 quantity。只改描述、不改下游计算,同样会算错。
作者还提出一个最小检查:如果商品金额小计大于总额,就转交人工处理。这适合作为该样例的异常信号,但不是完整的金额校验规则。存在折扣或优惠的票据,可能合法地出现商品原价合计高于实付总额;原文的 Schema 没有表达这些情况。
我的判断
我认可把格式要求移到接口参数里的方向。相比先生成自由文本,再用正则去掉代码围栏、截取花括号,这种方式更容易建立清晰的数据契约,也能减少后处理分支。
但文章标题里的「告别 JSONDecodeError」要结合边界理解。原文展示的是一次成功调用,没有提供批量成功率、与纯提示词方案的对照,也没有说明拒答、输出截断等情况如何处理。不能据此推导出整个调用链永远不会失败。
字段必须存在,也不代表字段一定有可靠依据。
小票模糊到看不清日期时,当前 Schema 仍要求 date 是字符串,却没有设计明确的未知值表达。这是一般团队接入前需要补齐的业务约定。
模型切换也有类似边界。作者说 Nova 接受相同的图片消息结构,可以通过修改 modelId 切换;但图片输入结构相同,不足以证明目标模型支持同样的 outputConfig 和 Schema 约束。原文没有展示 Nova 的对应测试。
费用方面,作者称整个课程的请求花费不到 1 美元,并推测这一课只需很少费用。这不是单次识别的成本测量,缺少调用次数、具体模型和用量,不能直接用于预算。作者也明确表示,没有测试皱纸或其他语言的小票。
这是一份有用的入门示例,可靠性结论目前仍受单张样本限制。
能拿来做什么
- 给现有 AI 提取接口补一份字段契约,明确必填项、数据类型、额外字段和无法识别时的处理方式,再决定哪些要求放进 Schema,哪些留给业务校验。
- 在小票场景中先统一
price的含义,明确使用单价还是行金额,并让金额计算遵循同一个定义,避免前端展示和后端核算各自理解。 - 如果由 Node 服务接收识别结果、前端展示待确认表单,可以分别处理请求失败、结构异常和业务数值异常;结构化输出通过后,再检查日期、金额与税费关系。
- 把这张清晰小票当作起点,补测真实业务中的中文票据、模糊照片和折扣票据,记录失败类型,再判断是否适合自动入库,以及哪些结果需要人工确认。