用故障注入检验免费模型的排障能力
Rootline 在 OpenTelemetry 微服务商城中注入多类故障,冻结指标、链路和日志后交给三个免费模型分析。评测覆盖 504 次运行,检查故障服务、类型、所属层及引用证据是否存在。
AI 深度解读
网站结账超时,问题可能出在支付服务,也可能是两者之间的网络。AI 能不能沿着监控数据找到真正的故障点?作者搭建了 Rootline,用 42 次事故、3 个免费模型和 504 次评分运行做了一轮测试。结果并不乐观:模型很自信,却经常找错原因,连正常运行也要报故障。
这次实验值得看的地方,是它把证据、评分规则和实验局限一起摊开了。对于想让 AI 帮忙排查线上问题的程序员,这些细节比一个准确率更有用。
怎么判断模型找到了根因
作者使用 OpenTelemetry Demo,在持续负载下运行一个微服务网店,再注入 14 类故障,包括支付错误、内存泄漏、锁竞争、配送缓慢、网络延迟、丢包和连接重置。同时保留没有故障的正常运行,作为对照。
每次事故都保存故障附近十分钟的指标、链路追踪和日志,形成固定快照。三个模型拿到相同材料,避免后运行的模型碰上不同现场:
- gpt-oss-120b 使用 Groq 的免费额度。
- Qwen3 8B 和 Gemma 3 4B 在免费 Kaggle GPU 上运行。
每条证据都有 ID,模型回答必须引用这些 ID。评分分别检查服务是否正确、故障类型是否正确、网络层或应用层是否正确,以及引用的证据是否真实存在。引用存在,只能证明材料没被凭空捏造,还不能保证推理成立。
最终规模是 42 次事故 × 4 种证据配置 × 3 个模型,共 504 次评分运行。作者将运行成本标为 $0,但这不代表搭建、硬件和人的投入也为零。
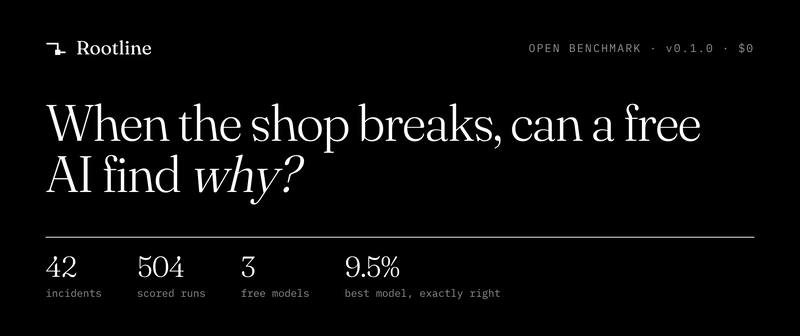
自信、证据多,都不保证诊断正确
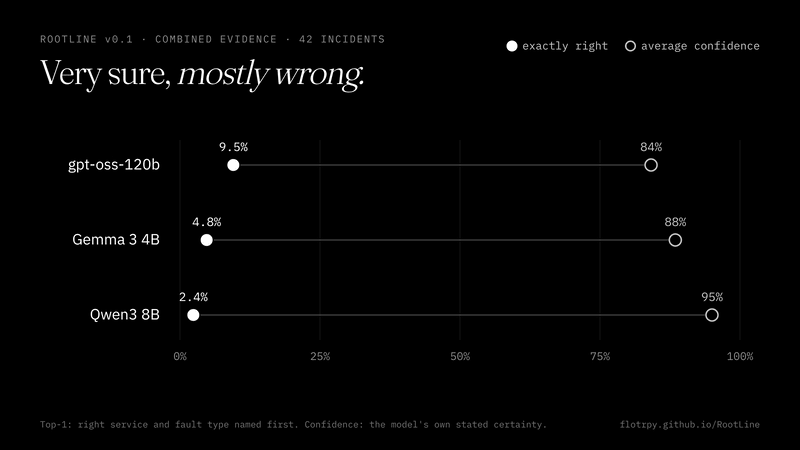
三个模型给出的平均置信度达到 84–95%,但诊断表现并不匹配。更明显的问题出现在正常运行中:所有模型的每一次正常样本回答,都声称系统存在故障。
这会直接影响使用方式。一个总能写出故障解释的助手,可能只是默认接受了「这里肯定坏了」这个前提。
Gemma 3 4B 则在全部 42 次事故中都判断为应用层问题。因此,它在应用故障上的好成绩,不能直接当成识别能力;始终选择同一个类别,也能碰中一部分答案。
把指标、链路追踪、日志一起提供,也没有胜过单独提供日志或指标。作者给出的解释是:提示词大小固定,覆盖的材料越广,每种材料能保留的细节就越少。这轮结果支持对证据组织方式保持警惕,但不能推导出「多种观测数据没有价值」。
有些失败来自评分,有些来自现场没留下证据
网络链路出问题时,表现最好的模型也常把调用方 checkout 判为故障服务,而作者预先规定的正确答案是另一端 payment。若允许任意一端算正确,得分就从 9.5% 上升到 16.7%。
这不是可以随手忽略的差异。定位到哪个服务、识别出哪条链路、解释最初原因,是不同任务。原文没有充分说明,为何网络故障必须归到 payment;因此,这部分成绩需要连着评分口径一起看。
作者还检查了故障是否真的出现在观测数据里。为比较模拟网络故障与真实故障,他们接入两块 Arduino UNO Q:一块通过 Wi-Fi 承载真实支付流量,另一块可以制造无线信道拥塞。控制器在夜间无人值守运行,执行断无线电 30 秒、拥挤信道、降低发射功率,并采集快照。
真实 Wi-Fi 中断留下了清晰信号。部分模拟故障却几乎没有痕迹,例如在持续复用一个连接的链路上注入连接重置。证据里没有呈现的故障,不能指望模型稳定诊断出来。
我的判断
这轮实验最有价值的是正常对照和证据核验。前者检查模型会不会无中生有,后者检查问题是否具备可诊断条件,比只统计「猜中了多少次」更接近工程需要。
但它仍是试点。42 次事故带来较宽的误差范围,作者预先提出的两个假设都没有达到统计显著性,原文也没有交代这两个假设的具体内容。不能据此给 AI 运维整体下结论,更不能把结果推广到所有模型和部署方式。
与直接让模型阅读全部材料相比,先筛选异常时间段、关联调用链,再让模型分析,是值得比较的替代方案;原文没有给出这类对照,所以不能断言效果更好。免费额度的可持续性,原文也没说清。
作者为 v0.2 计划增强那些没有留下痕迹的故障、增加正常运行、要求模型同时回答症状和原因,并测试隐藏服务名是否会改变答案。这些改动正好针对当前结果里最容易混淆的部分。
能拿来做什么
- 给日常 AI 排障增加正常样本对照。例如分析 Node 服务日志时,也放入已确认健康的时间窗口,检查模型是否总能编出异常。
- 要求回答分别列出症状、疑似原因和证据 ID,再人工核验引用是否支持结论,不要用模型自报的置信度决定是否修复。
- 分析 checkout 到 payment 这类调用失败时,要求同时说明调用方、被调用方和中间链路,避免把报错位置直接当成根因位置。
- 有条件复现实验时,可按原文运行
make data && make reproduce,从公开运行结果重建表格和图表。报告为 v0.1,数据集包含快照、标签和全部 504 个回答;先查看具体失败案例,再决定是否接入自己的排障流程。