让编码 Agent 在预览环境中自动验证修复
教程用 Argo CD ApplicationSet 与 Signadot,为编码 Agent 的 PR 创建服务沙箱,运行 Playwright 测试并回传检查结果。Agent 通过只读 MCP 获取失败原因、提交修复,PR 关闭后自动清理沙箱。
AI 深度解读
Coding agent 能很快提交 PR,团队却未必有时间逐个启动环境、跑测试、查失败原因。这篇教程给出的办法,是用 Argo CD 和 Signadot 为 PR 自动准备预览环境,再让 agent 读取测试结果,修复代码,直到检查通过。
它最有价值的地方,是把部署、端到端测试和失败反馈接成了闭环,同时限制 agent 的集群权限。作者用 HotROD 演示了成功路径,也故意制造了一次跨服务超时,展示这套方案能发现什么、又受哪些部署边界限制。
每个 PR 为什么只需要复制一个服务
HotROD 是一个演示打车应用。这次任务只修改 route 服务:让「Resolving routes」通知带上计算出的 ETA,例如「Resolving routes (ETA 12m30s)」。
如果为每个 PR 复制整套应用,连同 Kafka、MySQL、Redis 一起启动,资源消耗和环境维护都会增加。Signadot sandbox 的做法是只派生发生变化的服务,其余部分继续使用基线环境。
请求通过路由键(routing key)进入对应 sandbox。在教程里,前端入口仍是 http://frontend.hotrod.svc:8080,带键请求会走 PR 版本的 route,不带键则使用基线。
这里验证的是改动服务放进现有系统后的表现。
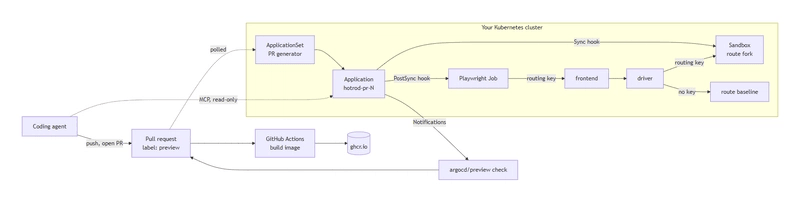
作者称,每个预览只增加一个 Pod。这个数字对应教程中只派生 route 的配置;如果改动涉及多个服务,就需要扩展 chart 的 services 值,并为各服务指定镜像。
这也带来一个重要边界:共享基线减少了重复部署,却不能据此推断数据完全隔离。原文没有展开数据库写入、消息消费等场景的隔离设计,接入业务系统前需要单独核实。
从提交代码到测试结果,谁负责哪一步
教程预计耗时约 40 分钟,固定使用 Argo CD v3.5.6 和 argocd-mcp 0.9.0。环境需要安装 Signadot Operator,也支持 Docker Desktop、kind 或 minikube。
整条链路分工很清楚:
- GitHub Actions 构建 PR 镜像,工作流监听
labeled、synchronize、reopened,用preview标签筛选。 - ApplicationSet 每隔
requeueAfterSeconds: 60查询 GitHub,为 PR 创建hotrod-pr-<number>Application。 - Argo CD 执行 hooks,准备 sandbox、运行测试,并在 PR 关闭后清理。
- Argo CD Notifications 将结果写成
argocd/preview检查,供人和 agent 查看。
镜像使用 ghcr.io/<owner>/hotrod:{{ .head_sha }},预览配置也包含 PR 的 head commit。这样可以将一次运行与具体提交关联起来。
部署阶段有三个 hook。Sync 先用 crane 等待镜像,再执行 signadot sandbox apply;PostSync 获取路由键,设置 SIGNADOT_ROUTING_KEY,运行 npm run e2e:playwright;PostDelete 执行 signadot sandbox delete。sandbox 另有从 updatedAt 起算的 3d TTL,作为清理失败时的兜底。
其中两个配置容易被忽略。
首先是 retry.limit: 0。原文指出,Argo CD 3.5 默认会对失败的自动同步重试五次,可能拖延数分钟。这里选择立即报告失败,把 agent 的下一次提交当作下一轮尝试。
其次,sandbox 规格保存在 ConfigMap 中。Argo CD 比较 Git 与实际状态时不把 hooks 算进去,因此需要每次提交都改变 ConfigMap,让 Application 进入 OutOfSync,触发 hooks 重跑。
还有一处防误测设计:获取路由键的 init container 如果拿不到键,就直接让 Job 失败,避免测试悄悄跑到基线环境上。
作者的首次运行中,镜像构建不到两分钟,两条 Playwright 测试耗时 6.7s,提交后约两分半钟检查通过。这是一次演示的耗时,不能当成一般团队的性能承诺。
Agent 如何查错,又为什么不能直接改集群
agent 负责提交代码、创建 PR,以及读取 Argo CD 的状态和日志。它没有 kubeconfig,也不持有 Signadot API key;仓库里的 Claude Code 设置还禁止调用 kubectl、argocd、signadot。
下面这段配置把 Argo CD 接入 MCP,并开启只读模式:
{
  "mcpServers": {
    "argocd": {
      "command": "npx",
      "args": ["-y", "argocd-mcp@0.9.0", "stdio"],
      "env": {
        "ARGOCD_BASE_URL": "${ARGOCD_BASE_URL:-https://argocd-server.argocd.svc}",
        "ARGOCD_API_TOKEN": "${ARGOCD_API_TOKEN}",
        "MCP_READ_ONLY": "true",
        "NODE_TLS_REJECT_UNAUTHORIZED": "0"
      }
    }
  }
}
关键是 MCP_READ_ONLY,它移除创建、修改、删除、同步和资源操作工具。配套 RBAC 只允许账号读取 previews/* 的 Applications 和日志。NODE_TLS_REJECT_UNAUTHORIZED=0 则是教程使用自签证书的临时设置,换成可信证书后应移除,登录时的 --insecure 也一样。
Signadot 密钥保存在 Kubernetes Secret,只交给需要它的 hook 容器,运行 PR 代码的测试容器拿不到它。agent token 使用 --expires-in 24h,到期需要重新生成并重启 agent。
作者还刻意制造了一次失败:将 route 的模拟耗时从 50 * time.Millisecond 改成 1500 * time.Millisecond。构建和单元测试通过了,但 driver 调用 route 的 deadline 只有 1s,导致派单无法完成,两条 Playwright 测试都失败,断言等待 5000ms 后超时。
agent 随后调用 get_application 和 get_application_workload_logs,结合提交内容与客户端代码定位问题,撤销延迟修改,推送后不到两分钟恢复通过。
它给出的解释比「测试绿了」更有用:超时配置在 driver 中,而预览只派生 route。即使在 PR 里修改 driver 的 timeout,只要预览没有部署 driver,这个修改就不会参与验证。
我的判断
这套方案最值得借鉴的是反馈链路:提交、镜像、预览、测试和日志都能互相对应,agent 有材料判断失败原因,人也能复核它测的是哪个 commit。首次成功后,作者还读取 e2e Job 日志确认提交,补上了单看绿色状态不足以提供的证据。
但它有两个信任前提。
第一,PR 的创建者也能修改自己的 Playwright 测试。本例中 agent 同时修改通知文本和断言,这是合理操作,却也说明「预览通过」只能证明当前测试通过。关键回归用例仍需要评审,或者由独立来源维护。
第二,只读 Argo CD 并不等于 agent 整体只读。作者明确提醒,agent 使用用户的 GitHub 凭据,可能具备向应用仓库 main 分支推送的能力。生产使用时,应把 preview chart 放到平台团队控制的仓库,并将 targetRevision 固定到 commit 或 tag。教程直接跟随 main,属于演示配置。
preview 标签也不是普通分类标签。能添加它,就能让 PR 的代码和测试在集群中执行,需要明确谁有这个权限。
至于测试放在 Argo CD 还是 CI,原文没有给出对照数据。这套 PostSync 方案的优势是测试靠近集群运行,CI 无需访问集群;如果团队已有成熟的 CI 测试与报告系统,也可以让 Argo CD 只管理 sandbox。迁移测试执行位置是否划算,仍要看现有流程。
能拿来做什么
- 如果已有 Argo CD 和微服务基线,可以先选一个依赖关系清楚的服务试接 PR 预览,明确哪些服务会部署、哪些继续复用基线,再决定测试范围。
- 用 Playwright 验证前端触发的跨服务流程时,让日志记录 head commit 和 sandbox,并在缺少
SIGNADOT_ROUTING_KEY时直接失败,避免测错版本。 - 给 AI 编程任务增加可核验的交付要求:返回 PR 地址、预览地址和实际检查内容,失败时读取状态与日志后再修改代码。
- 排查镜像等待时区分
MANIFEST_UNKNOWN与DENIED:前者先查镜像是否构建完成,后者查仓库权限。业务镜像应保持私有,同时给 fork 配置imagePullSecrets,并通过DOCKER_CONFIG为等待镜像的容器提供凭据。