
8.0
热点
AI SCORE
编程提效2026-09-23 12:58
用 AI 辅助求职的工程实践:诚实原则与确定性设计
dev.to · AI#AI工程实践#Prompt设计#求职
Editor brief · 编辑速览
作者周末完成 AI 求职助手核心原则:让模型做最小封闭决策,其余全由确定性代码完成,避免模型虚构个人信息。
我来翻译这篇文章,然后生成思维导图。
先从"诚实"这部分说起。现在每个人都在用 AI 找工作。招聘方用 AI 筛选堆积如山的简历,求职者用 AI 写简历和求职信。这算不上什么丑闻,招聘本来就是这样运作的。所以唯一有意思的问题变成了:怎样才能用好 AI。
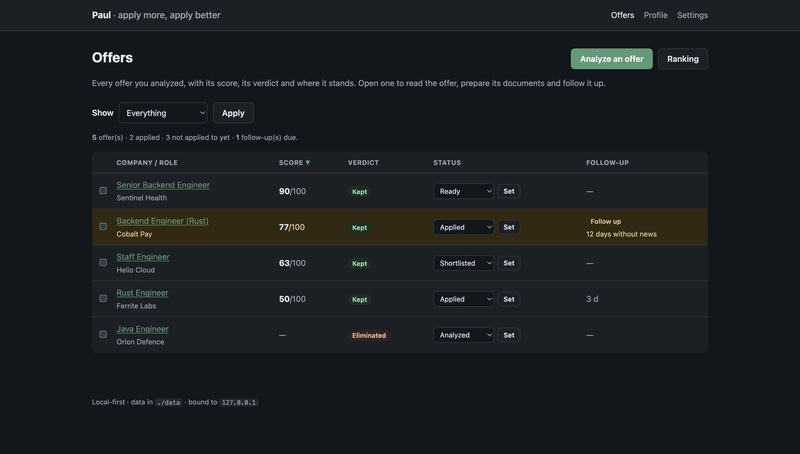
这正是这篇文章要回答的问题。我花了一个周末,全程指挥 DeepSeek,搭了一个小小的求职助手。你粘贴一个职位JD,它会拿着它和你的简历、你的诉求做个匹配评分,然后按你自己的模板写简历和求职信,并帮你起草申请表里的答案。投更多,投更好。
有两条规则贯穿了整个项目。
它不能替你编造事实。
它的评分必须是一个你可以去验证的东西。
两条看起来都很简单。但一旦有语言模型参与进来,两条都会变得很难。而解决这两个问题的办法竟是同一个。我在三个地方都用它。
给模型最小的决策空间,放在一个封闭集合里。其他一切交给确定性代码来完成。
这就是全文的核心一句话。剩下的内容讲的是它在实践中具体是怎么做的,分布在三个地方。
下面三个地方都依赖同一个基础——你的简历信息。所以这个工具首先要把这个基础建好。
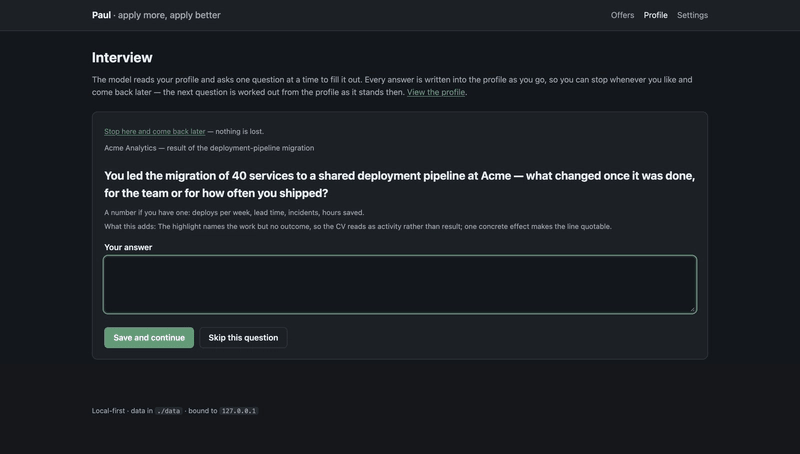
你导入自己的简历,可以是 PDF、DOCX 或者纯文本粘贴。模型把它转成一份结构化的简历信息,只遵循一条严格规则:只用简历里写到的内容,没有的一律留空。然后它会逐个问题地采访你,问的恰恰是简历里通常会缺失的那些东西:一条模糊经历背后的实际成果、项目的规模、你真正做过的决定。每个回答都直接写入简历信息库,验证方式和文档一样——你没有亲口说过的数字不入库,没有来自你原文的行文不留。
花十分钟建好这部分,后面的所有文档质量就有了保障。我觉得这是整个工具里最大的时间节省。
给一个职位评分,最直观的做法是让模型给出一个 0 到 100 的数字。问题在于这个数字会漂移。同一个职位,周一得了 82,周二得了 91,没人知道是为什么。而且你没法跟 87 争辩——你根本抓不到任何东西。
所以模型不给数字。它来填一个固定的表格。四个维度,每个维度的得分是 0 到 5 的小整数,每个维度附上一句话作为理由说明。权重和总分都在代码里。
AXIS_WEIGHTS: dict[str, float] = {
    "technical_match": 0.40,
    "seniority_scope": 0.20,
    "wishes": 0.25,
    "red_flags": 0.15,
}

def build_score(grid: ScoringGrid) -> Score:
    axes = [...]
    total_weight = sum(axis.weight for axis in axes) or 1.0
    weighted = sum(axis.score * axis.weight for axis in axes) / total_weight
    return Score(axes=axes, total=round(weighted / MAX_AXIS_SCORE * 100))
这四个权重是写死的,这样做是故意的。你调整自己的诉求和权重,但不去动评分表格本身。如果让模型来选权重,它可以悄悄地把总分从一个版本挪到另一个版本,而你永远不知道为什么。
现在模型的自由度变成了几个小整数,而不是一个它凭空编造出来的数字。而总分是一个纯函数——同样的表格,永远得到同样的总分。当你不同意某一行时,你是在和一个维度争辩,而且你能看到支撑它的那一句话。
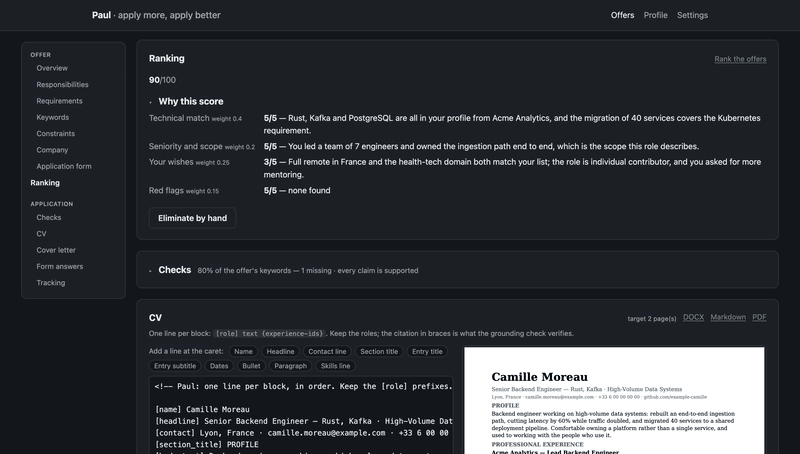
维度得分仍然来自模型。确定性的是聚合方式,而不是判断本身。这一点我不假装。但漂移现在被限制在了表格的最小步长内,而且每个保存的评分都携带着其输入的指纹——包括模型本身。换了模型或改了某条规则,旧评分就会被标记为过期,而不是悄无声息地和新评分混在一起。
一封求职信里编造了一个数字,比没有求职信更糟糕。所以 prompt 里把规则说得很清楚:只用简历信息里的内容。每提出一个主张,必须引用一个真实经历。
但 prompt 是请求,不是保证。模型可以忽略它,而且它经常以一种微妙的方式忽略。
所以同样的规则在代码里再检查一遍,收到草稿后逐行校验。
invented = [n for n in numbers(line.text) if n not in profile_material]
if invented:
    flag(line, f"states {', '.join(invented)}, not in your profile")
一行里的每个数字必须已经存在于简历信息库里。每句事实陈述必须引用一个真实存在的经历。技能栏不能列出候选人从未写过的内容。文档上的名字必须和简历信息库里的名字一致。
背后的设计原则是:对事实严格,对措辞宽松。这个工具对你的风格没有意见。它只拒绝让你说出不真实的话。校验报告会在审核界面里和文档并排显示,由你来决定每一行怎么处理。
数字校验本质上是字符串搜索。所以如果一个数字已经出现在简历信息库的其他地方,它就可能出现在错误的位置而通过校验。没有数字的主张只能靠引用来评判。它能抓住最严重的失败——编造数字——但并不能捕捉一切。
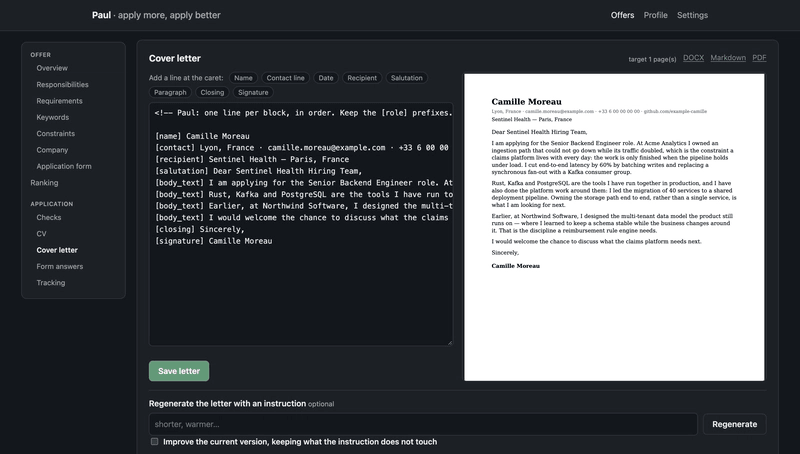
模型写出简历,但简历必须以你自己的模板输出,包含你的字体、页边距和间距。
naive 的做法是读取模板、记录样式,然后重建一个穿着这些样式的新文档。但从来都对不上。Word 文档是一团本地格式的乱麻,模型对你模板的理解只是对它的近似。
所以我根本不重建任何东西。用户提供的文件始终作为底稿,每个段落用了哪段 XML 我就原样复用。首先我把每个块及其 XML 一起保留下来。
blocks.append(
    ExtractedBlock(text=text[:MAX_TEXT], xml=paragraph._p.xml,
                   hint=_hint(paragraph))
)
模型看到的是这些块的列表,对每一个块从一个封闭列表里挑选一个角色: bullet、section 标题、条目标题、正文行。它看不到格式,只能看到文本和一条短提示。渲染时,代码深拷贝该角色对应的那个块的 XML,替换其中的文本,再把它放回文档。
element = parse_xml(xml)
_fill(element, line.text, line.role, link_ids)
字体、颜色、编号、边框、页眉和可点击的链接都来自模板,因为它们就是这个模板自己的 XML。
它处理正常简历效果不错,遇到奇怪的简历可能会出错。
当一个工具要替你写关于你的内容时,失败的后果不同于一个聊天窗口的失败。聊天机器人有点跑偏,只是有点烦人。但一份声称了你从未拿到的数字的文档,是一个真正的问题——它会进入一个真正的收件箱,另一头坐着一个真正的招聘官。
所以模型负责需要判断力的那部分,也就是阅读一份杂乱的职位描述并把一行文字放进正确的桶里。代码负责必须精确的那部分,也就是算术、事实和排版。各尽其能,每个输出都可以解释得清楚。
对每一步都问两个问题。
第一,这里最小的有用决策是什么?第二,我能把它放进一个封闭集合吗?来自列表的角色、来自固定表格的小整数。不是一段自由文本然后你再把它解析回来,因为解析回来就是信任崩溃的时刻。
模型不决策的一切,都留在代码里——在那里你可以读取它、测试它、在会议上为它辩护。这不是对模型的限制。这正是让模型可以被安全使用的做法。
代码是开源的,MIT 协议,在你自己的机器上运行。简历信息、职位和文档永远不会离开你的机器,发给模型提供商的只有你配置的那个 provider 的文本。