Agent 评测还要看重复执行的一致性
文中实验显示,GPT-4.1 ReAct Agent 在 AppWorld 的平均成功率为 77.4%,但五次均成功的任务占比仅为 53.0%。作者介绍 ALTK-Evolve 的一致性分析器及指导规则,用历史执行轨迹诊断并改善重复运行表现。
完整中文译文
Agent 在彩排时完成任务,演示时却换了一条路径,把同一道题做错。作者关注的就是这种「会做,但不能稳定做对」的问题:在 AppWorld 测试中,GPT-4.1 的平均成功率达到 77.4%,可连续 5 次全部成功的任务只占 53.0%。
他们给出的办法是,从已有执行记录中找出容易摇摆的决策,再把这些决策整理成可复用规则。实验结果有提升,但读这篇更有价值的收获,是学会区分平均能力、重复可靠性,以及规则究竟能修复什么。
平均成功率,为什么回答不了「再跑一次呢」
常见评测用 Mean@k:把任务执行 k 次,计算平均成功率。原文说,k 经常取 3,有时甚至只跑 1 次。这个指标能描述总体表现,却会把反复成功的任务和时好时坏的任务混在一起。
作者引入的 Pass^k,统计的是「k 次全部成功的任务占比」。它也不同于代码生成评测里常见的 Pass@k:
- Mean@k 看平均有多少次成功。
- Pass^k 要求每一次都成功。
- Pass@k 只要求至少成功一次。
三个指标始终满足 Pass^k ≤ Mean@k ≤ Pass@k。能验证结果、允许重试时,Pass@k 很有用;用户希望同一个请求重复提交都能完成时,Pass^k 更贴近需求。
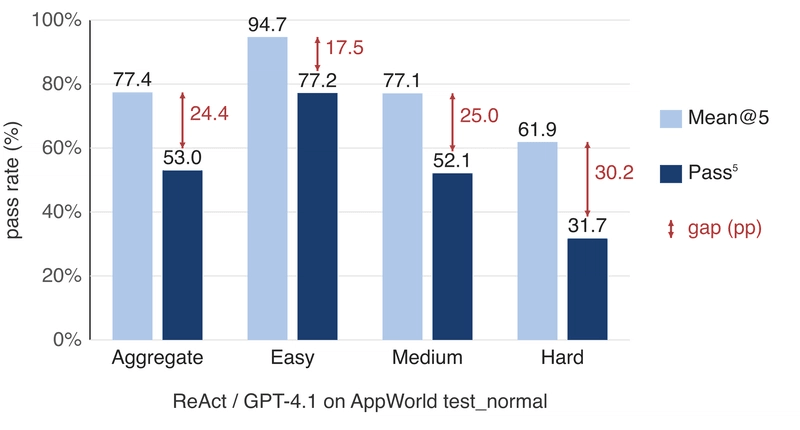
在 AppWorld 的 test_normal 上,ReAct Agent 使用 GPT-4.1,Mean@5 为 77.4%,Pass^5 为 53.0%。作者把两者之差称为一致性差距(consistency gap),这里是 24.4 个百分点,困难任务上达到 30 个百分点。
注意,24.4 个百分点是两个指标的差值,不能直接当成「不稳定任务占比」。它反映的是平均成绩与连续成功要求之间的距离。
平均成功率高,仍然可能掩盖大量无法重复交付的任务。
temperature 设成 0,为什么还会换条路走
Agent 的一次执行,会串起多个决策:选哪个 API、传什么参数、搜索结果是否可信、失败后是否重试。
作者用概率分布解释这些决策的稳定程度。如果一个候选明显领先,细微扰动通常不会改变选择;如果几个候选接近,微小变化就可能让另一个候选胜出。几十步决策串起来,局部的不确定性就可能扩散到最终结果。
原文列举的扰动来源包括 GPU 浮点运算的非结合性、请求批处理,以及其他平台侧因素。所谓非结合性,就是浮点数改变计算顺序后,结果可能出现细微差异。
Greedy decoding 和 fixed seed 控制的是怎样从分布中选出 token,不能保证托管服务每次计算出的分布完全相同。作者的 ReAct Agent 使用 temperature 0.0,因此他们认为,实验中的波动并非普通的随机采样造成。
这套解释提供了排查方向,但文章没有逐项隔离这些因素,也没有证明某次失败具体由哪种平台扰动触发。它解释了「为什么可能发生」,还不能替代针对系统的因果诊断。
从一条执行记录里,找出下次可能选错的步骤
ALTK-Evolve 原先就能把 Agent 的历史执行轨迹提炼成规则,在推理时注入。本文新增的一致性规则(consistency guidelines),改变的是规则的来源:先找容易摇摆的步骤,再针对它们生成指引。
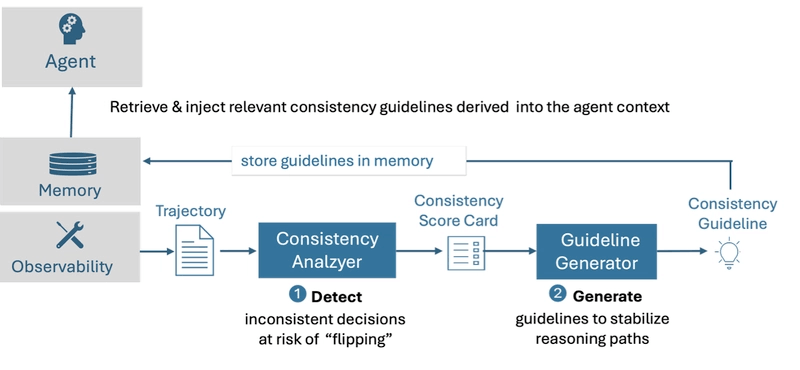
第一阶段由 Consistency Analyzer 完成。它读取一条已经记录的执行轨迹,在每个决策点重放当时的上下文,通过一次额外模型调用请求 k 个补全,默认 k=5,观察输出如何变化,并把每步的一致性分数写入评分卡。
这里重放的是模型输入上下文,不会重新调用工具、操作环境,也不会把完整任务再执行一次。分析过程是黑盒的,不需要 logits、模型内部信息或标准答案。不过,每个决策点都要增加一次离线模型调用,成本会随轨迹长度增长。
第二阶段把标记出的步骤转成 ALTK-Evolve 标准格式的规则,进入已有存储与检索流程。
原文给出的任务,是根据 SimpleNote 笔记统计愿望清单中已完成的活动。生成的规则包括:统计复选标记时使用按行起始位置匹配的正则表达式,避免标题里的图例被普通子串计数误算;搜索笔记后检查是否存在多个结果,并确认选中了正确笔记。
演示中,5 次并行执行因为计数策略不同,出现了 3 比 2 的分歧;加入规则后,5 次结果一致。这段演示时长为 2 分钟。
它想说明的是:一次执行碰巧做对,也可能暴露出下次会选错的步骤。但「五次一致」本身仍不等于「五次正确」,后者需要结果验证。
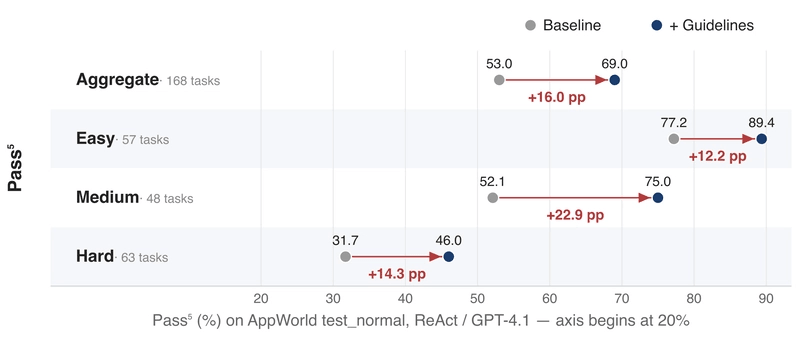
正式实验使用 AppWorld test_normal 的 168 个任务,每个任务从一条基线轨迹生成规则,再进行 5 次新执行。GPT-4.1 的结果是:
- Pass^5 从 53.0% 升至 69.0%,增加 16.0 个百分点。
- Mean@5 从 77.4% 升至 81.0%,增加 3.6 个百分点。
- 一致性差距从 24.4 缩小到 12.0 个百分点,接近减半。
按难度拆分,中等任务的 Pass^5 增加 22.9 个百分点,相对提升约 44%;困难任务增加 14.3 个百分点,相对提升约 45%;简单任务增加 12.2 个百分点。作者报告,各难度的平均成功率均未下降。
规则也被用于同一场景下不同但相关的任务,Pass^5 提升 13.0 个百分点,比原任务低 3 个百分点。另一模型 gpt-oss-120b 的原任务 Pass^5 从 10.1% 升至 16.1%,增加 6.0 个百分点;相关任务提升反而达到 8.7 个百分点。这支持了规则具有一定复用性,但复用范围仍是实验所覆盖的相关场景。
我的判断
我认同作者把「重复可靠性」单独拿出来衡量。对于需要调用工具、连续做决策的 Agent,只报平均成绩,很容易让团队高估它的交付能力。原文还同时观察 Mean@5,避免用平均能力下降换取表面稳定,这个要求是合理的。
但结果的适用范围要收紧。这里是 AppWorld、ReAct、特定模型和有限次数重复实验。相关任务上的提升,不能直接推广成跨业务、跨工具的通用收益。gpt-oss-120b 即使提升到 16.1%,连续五次成功率仍然很低,规则没有消除能力不足。
此外,无标准答案适用于「检测决策是否摇摆」,不适用于「证明任务完成正确」。一个 Agent 也可能稳定地重复同一种错误。原文没有充分交代重采样的具体温度、输出差异怎样计分,以及标记步骤的阈值,这些都会影响诊断质量。
相比换大模型、普通提示词优化或增加重试,本文提供了另一条有实验支持的路线,但没有给出这些方案的直接对照,也没有完整成本数据。「别先换大模型」可以当作排查建议,还不能当作普遍最优策略。
能确定写进程序的规则,应优先由程序保证。
例如复选标记计数和搜索结果消歧,如果工具层能返回明确的结构化结果,就能减少 Agent 反复选择策略的机会。原文没有比较这种工程改造与规则注入的收益;对团队而言,两者都应进入候选方案。
能拿来做什么
- 给现有 AI 编程或工具调用评测增加重复执行。同一批任务先跑 3 次,同时报告 Mean@3、Pass^3 和两者差值,并按难度拆分,找出平均成绩掩盖的波动。
- 保存包含模型上下文、工具调用和返回结果的完整轨迹。对于偶发失败的任务,先定位产生分歧的决策点,再判断该修改工具接口、确定性代码,还是补充 Agent 规则。
- 在 Node 工具层落实明确约束。例如为笔记统计提供经过验证的解析函数,让搜索接口返回多个候选及可核对字段,减少模型临场选择计数和消歧策略的机会。
- 试用一致性规则时,同时检查成功率、连续成功率和调用成本,并把规则放到不同但相关的任务上验证。只有重复表现改善且正确性没有退步,才有理由扩大使用范围。