

递归初相见——二叉树递归遍历的三种姿势|算法篇
我们之前学过数组的遍历、链表的遍历,这些线性结构的遍历考起来没有什么难度,可以理解为基本技能,一般也不会单独出题。
但是二叉树可不一样了,这一“开叉”,它的遍历难度陡然上了一个台阶。在面试中,二叉树的各种姿势的遍历,是非常容易作为独立命题点来考察的,而且这个考察的频率极高极高。 因此对于有志于在算法面试上求稳的同学,本节涉及的编码内容,你千万不要沉溺在“我看懂了”、“我理解了”、“我知道你说的是啥意思了”这种虚无的成就感中——假的,都是假的,只有自己写出来的代码才是真的!
理解只是记忆的前提,只吹理解不记忆,不如回家去种地:)。
这里我对大家的要求就是“在理解的基础上记忆”。如果你真的暂时理解不了,背也要先给你自己背下来,然后带着对正确思路的记忆,重新去看解析部分里的图文(尤其是图)、反复去理解,这么整下来你不可能学不会。 面试时见到二叉树的遍历,你不能再去想太多——没有那么多时间给你现场推理,这么熟悉的题目你没必要现场推理,你要做的是默写!默写啊!老哥们!!(捶胸顿足)
# 二叉树的遍历——命题思路解读
30 秒速记
- 遍历要按确定顺序访问每个结点一次;二叉树常见先序、中序、后序和层序
- 先、中、后描述根结点相对左右子树的访问时机,三者默认都保持左子树先于右子树
- 深度优先可用递归或显式栈,层序使用队列;选顺序取决于结果对父子结点的依赖
- 复制常用先序,搜索树有序输出用中序,删除或汇总子树用后序,最浅层问题常用层序
- 四者时间都是
O(n);深搜辅助空间O(h),层序队列最坏保存树的最大宽度O(w)
二叉树遍历就是按确定顺序访问每个结点一次,常见方式是先序、中序、后序和层序。 前三种本质上区别在于根结点相对左右子树何时处理,可用递归或显式栈;层序则用队列逐层访问。选择顺序要看数据依赖,例如搜索树有序输出适合中序,父结点依赖子树结果时适合后序。它们时间都是 O(n),深度优先空间为 O(h),层序最坏为树的最大宽度 O(w)。
遍历方式应从数据依赖反推。若父结点结果依赖左右子树,就要先得到孩子再处理父亲,对应后序;若利用二叉搜索树“左小、根中、右大”的约束输出有序值,则用中序。层序让距离根相同的结点连续出现,适合最短层数、逐层聚合和宽度问题。
四种遍历都至少访问每个结点一次,时间为 O(n)。深度优先保存当前根到叶的路径,辅助空间 O(h);广度优先保存当前层的候选结点,最坏 O(w)。完全二叉树最后一层宽度接近 n/2,所以层序空间不能简单说成 O(log n)。
以一定的顺序规则,逐个访问二叉树的所有结点,这个过程就是二叉树的遍历。按照顺序规则的不同,遍历方式有以下四种:
- 先序遍历
- 中序遍历
- 后序遍历
- 层次遍历
按照实现方式的不同,遍历方式又可以分为以下两种:
- 递归遍历(先、中、后序遍历)
- 迭代遍历(层次遍历)
层次遍历的考察相对比较孤立,我们会把它放在后续的真题归纳解读环节来讲。这里我们重点要看的是先、中、后序遍历三兄弟——由于同时纠结了二叉树和“递归”两个大热命题点,又不属于“偏难怪”之流,遍历三兄弟一直是前端算法面试官们的心头好,考察热度经久不衰。
面试官追问
追问 1权限树页面要求父节点状态由左右子树的计算结果决定,候选人却先处理父节点再递归孩子,你为什么会要求改成后序遍历?
父节点依赖两个子树的结果时,应先计算左、右子树,再处理根节点,这正是后序顺序。先序处理根时依赖数据尚未产生,只能额外回填或重复计算;若父节点信息反过来决定孩子处理方式,先序才可能更自然。
追问 2搜索结果存成二叉搜索树,接口要按从小到大输出全部键值,为什么中序遍历比先序更贴合约束?
二叉搜索树满足左侧值较小、根居中、右侧值较大的结构约束,按“左—根—右”的中序遍历可直接得到有序序列。先序或后序仍会访问全部结点,但输出天然不保证有序;若树不满足搜索树约束,中序也不能凭空产生排序结果。
追问 3组织架构页要找距离 CEO 最近的异常节点,并在首次命中后停止,团队在 DFS 与层序遍历之间如何选?
层序遍历会让距离根相同的结点连续处理,因此首次命中的异常节点具有最小层数,更符合需求。DFS 可能先深入一条很长的分支后才发现更浅答案;代价是队列需要保存当前候选层,宽树上的峰值空间可能明显更大。
追问 4一棵接近完全二叉树有一百万个结点,线上层序任务出现内存峰值,而开发者认为树高只有 O(log n),你会怎样定位误判?
树高为 O(log n) 只约束深度优先遍历保存的路径长度,不约束层序队列的宽度。完全二叉树最后一层宽度可接近 n/2,层序辅助空间最坏是 O(w);应检查队列峰值,并评估能否改用 O(h) 的深度优先方案。
追问 5统计树的最大宽度与计算树高分别要上线,负责人要求统一一种遍历模板,你会接受吗?
不会仅为模板统一牺牲数据依赖:最大宽度需要识别每一层的结点数量,层序遍历更直接;树高可用深度优先沿路径计算,辅助空间为 O(h)。两者时间都至少访问每个结点一次,即 O(n),差异主要在中间状态和空间峰值。
# 递归遍历初相见
30 秒速记
- 递归函数必须有可达终止条件;树题常以空结点为边界
- 每次调用都有独立栈帧,保存参数、局部变量和返回位置,递归栈必须计入空间
- 先定义函数对一棵子树返回什么,再假设左右子树正确返回,当前层只负责组合
- 递归深度等于树高
h:平衡树约O(log n),退化链为O(n),JavaScript 可能栈溢出 - 有环或共享结点的数据不是普通树;不可信输入要检测对象身份
二叉树递归遍历的关键,是先约定函数如何处理一棵子树,并用空结点作为可达的终止条件。 每次递归都有独立栈帧,当前层只需要相信左右子树能正确返回,再组合结果。每个结点处理一次,时间是 O(n),调用栈空间是 O(h),不能算成 O(1)。平衡树深度约为 O(log n),退化成链时会到 O(n);面对超深树或可能含环的输入,我会改用显式栈并检测对象身份。
以求高度为例,函数契约是“返回以 node 为根的子树高度,空树高度为 -1”。当前层无需知道子树内部细节,只取左右返回值的较大者加一:
function height(root) {
  if (root === null) return -1
  return 1 + Math.max(height(root.left), height(root.right))
}
每个结点计算一次,时间 O(n);调用栈空间 O(h)。不能因为局部变量少就说空间 O(1),未返回的栈帧会随深度增长。用户可构造的超深树应改用显式栈并限制最大结点数和深度。
编程语言中,函数Func(Type a,……)直接或间接调用函数本身,则该函数称为递归函数。
简单来说,当我们看到一个函数反复调用它自己的时候,递归就发生了。“递归”就意味着“反复”,像咱们之前对二叉树的定义,就可以理解为是一个递归式的定义:
- 它可以没有根结点,作为一棵空树存在
- 如果它不是空树,那么必须由根结点、左子树和右子树组成,且左右子树都是二叉树。
这个定义有着这样的内涵:如果我们想要创建一个二叉树结点作为根结点,那么它左侧的子结点和右侧的子结点也都必须符合二叉树结点的定义,这意味着我们要反复地执行“创建一个由数据域、左右子树组成的结点”这个动作,直到数据被分配完为止。
结合这个定义来看,每一棵二叉树都应该由这三部分组成:
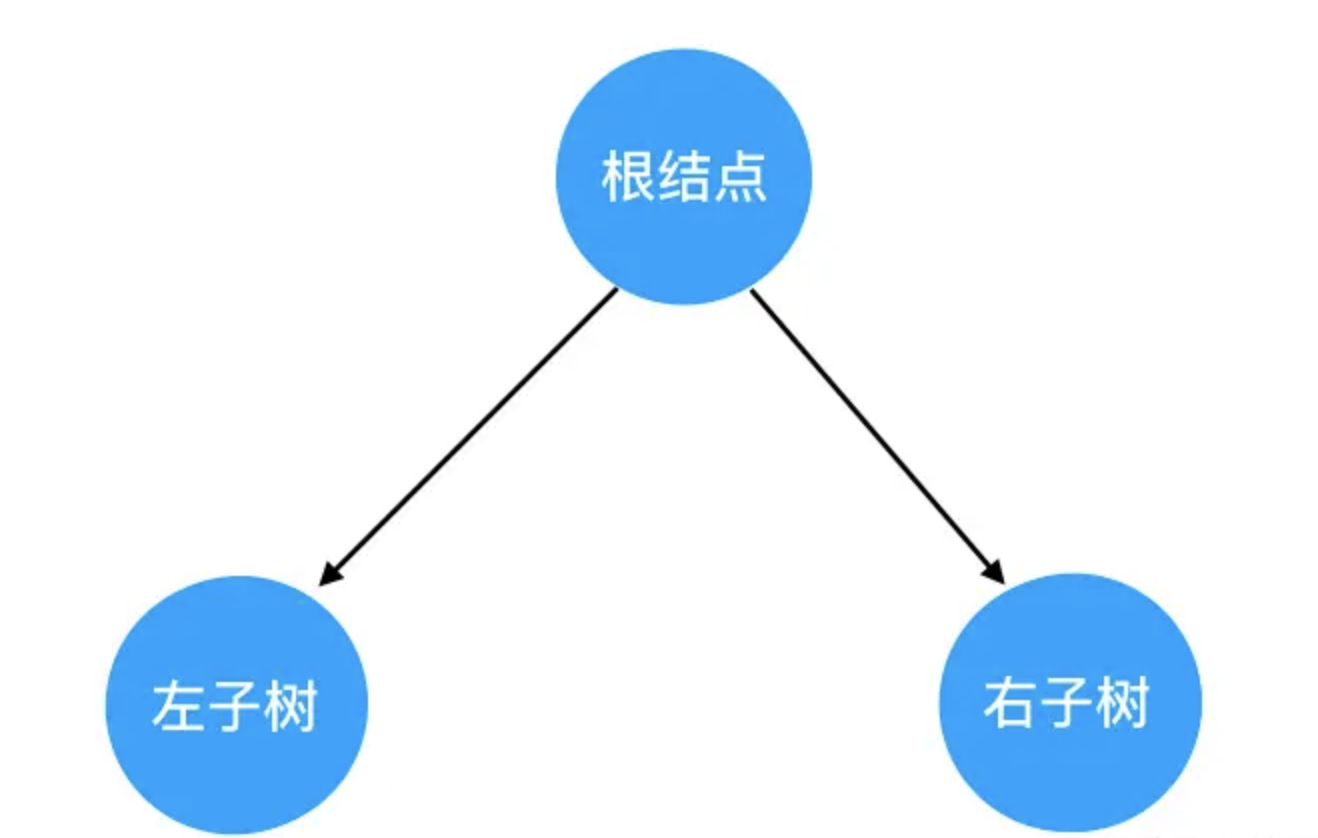
对树的遍历,就可以看做是对这三个部分的遍历。这里就引出一个问题:三个部分中,到底先遍历哪个、后遍历哪个呢?我们此处其实可以穷举一下,假如在保证“左子树一定先于右子树遍历”这个前提,那么遍历的可能顺序也不过三种:
- 根结点 -> 左子树 -> 右子树
- 左子树 -> 根结点 -> 右子树
- 左子树 -> 右子树 -> 根结点
上述三个遍历顺序,就分别对应了二叉树的先序遍历、中序遍历和后序遍历规则。
在这三种顺序中,根结点的遍历分别被安排在了首要位置、中间位置和最后位置。
所谓的“先序”、“中序”和“后序”,“先”、“中”、“后”其实就是指根结点的遍历时机。
面试官追问
追问 1候选人在白板上写出 height(root),空节点返回 0、叶子返回 1,而接口文档规定空树高度为 -1,你会让他怎样修正?
必须先统一高度按边数还是结点数计数;既然契约规定空树为 -1,叶子就应返回 0。实现可写成空节点直接返回 -1,非空节点返回左右高度最大值加一;混用两套约定会造成稳定的偏一错误。
追问 2树形评论页只有几十行递归代码,却在十万层链式脏数据上栈溢出,为什么局部变量少也救不了它?
每次递归调用都保留未返回的栈帧,链式结构使深度 h 接近结点数 n,辅助空间因此是 O(n)。应改用显式栈迭代,并对不可信输入限制结点数和最大深度;显式栈仍占空间,但不会依赖有限的语言调用栈。
追问 3计算高度时产品把空树高度从 -1 改成 0,现有 1 + Math.max(...) 递归还能原样保留吗?
递推结构可以保留,但所有高度会改为按结点数计数,叶子高度由 0 变成 1。调用方若把高度用于边数、缩进或阈值判断,也必须同步调整;只修改基础返回值而不核对契约消费者,会引入偏一故障。
追问 4线上高度接口返回异常缓慢,你看到递归函数对每个节点只取一次左右子树结果,应该怎样判断是算法问题还是输入形状问题?
正常树上每个结点只计算一次,时间复杂度是 O(n),不存在因树退化而重复访问结点的问题。退化形状主要把调用栈空间推到 O(n),可能导致栈溢出;应核对实际结点数、最大深度和是否存在异常引用,再决定改迭代还是限制输入。
追问 5团队争论递归版与显式栈版的树高计算,数据既可能平衡也可能由用户构造,你会如何定方案?
可信且深度受控的数据可优先使用递归版,它直接表达“子树高度取最大值再加一”的契约。用户可构造超深树时,显式栈更稳妥,并应同时限制最大深度和结点数;两者时间通常都是 O(n),选择差异集中在栈安全与实现复杂度。
# 遍历方法图解与编码实现
30 秒速记
- 先序根左右、中序左根右、后序左右根;只移动“处理 root”的位置,不改变左右关系
- 返回数组比函数内
console.log更易测试;大结果可用生成器按需产出 - 中序只对二叉搜索树产生有序结果,普通二叉树没有该保证
- 递归和显式栈版本的辅助空间都是
O(h),迭代不会凭空消掉空间 - 测试覆盖空树、单结点、单侧链和普通分叉树,并确认输入未被修改
三种遍历只是在调整访问根结点的时机:先序是根左右,中序是左根右,后序是左右根。 左子树始终先于右子树,因此实现时只要移动处理 root 的那一行,不必改递归结构。我一般返回数组而不是直接 console.log,这样更方便测试;如果只找首个结果,可以短路返回或使用生成器。三种方式的时间都是 O(n),递归栈为 O(h),还要单独计算结果数组的 O(n) 空间。
function traverse(root, order = 'pre') {
  if (!['pre', 'in', 'post'].includes(order)) throw new TypeError('unknown order')
  const result = []
  const visit = (node) => {
    if (node === null) return
    if (order === 'pre') result.push(node.val)
    visit(node.left)
    if (order === 'in') result.push(node.val)
    visit(node.right)
    if (order === 'post') result.push(node.val)
  }
  visit(root)
  return result
}
每个结点只在选定时机写入一次,时间 O(n),递归栈 O(h),结果数组 O(n)。若调用方只找第一个匹配项,应返回命中结果逐层短路或用生成器,避免继续遍历和收集完整数组。


