我们之前学过数组的遍历、链表的遍历,这些线性结构的遍历考起来没有什么难度,可以理解为基本技能,一般也不会单独出题。
但是二叉树可不一样了,这一“开叉”,它的遍历难度陡然上了一个台阶。在面试中,二叉树的各种姿势的遍历,是非常容易作为独立命题点来考察的,而且这个考察的频率极高极高。 因此对于有志于在算法面试上求稳的同学,本节涉及的编码内容,你千万不要沉溺在“我看懂了”、“我理解了”、“我知道你说的是啥意思了”这种虚无的成就感中——假的,都是假的,只有自己写出来的代码才是真的!
理解只是记忆的前提,只吹理解不记忆,不如回家去种地:)。
这里我对大家的要求就是“在理解的基础上记忆”。如果你真的暂时理解不了,背也要先给你自己背下来,然后带着对正确思路的记忆,重新去看解析部分里的图文(尤其是图)、反复去理解,这么整下来你不可能学不会。 面试时见到二叉树的遍历,你不能再去想太多——没有那么多时间给你现场推理,这么熟悉的题目你没必要现场推理,你要做的是默写!默写啊!老哥们!!(捶胸顿足)
# 二叉树的遍历——命题思路解读
30 秒速记
- 四种遍历:先序(根左右)、中序(左根右)、后序(左右根)、层序(一层一层)
- 先/中/后说的是「根什么时候处理」,左子树永远先于右子树
- 怎么选看数据依赖:父要用孩子的结果 → 后序;
BST要有序输出 → 中序;要最浅一层 → 层序 - 前三种是深度优先,递归或手写栈;层序用队列
- 时间都是
O(n);深搜空间O(h),层序空间O(w),完全二叉树最后一层能到n/2
二叉树遍历就是按固定规则把每个结点走一遍,先、中、后序的区别只在根结点什么时候处理。 比如 A 下面挂 B、C,先序是 A B C,中序 B A C,后序 B C A,左边永远先于右边。实际选哪种我看数据往哪个方向流:父结点要等孩子算完(求树高、汇总子树大小)就用后序,二叉搜索树要从小到大吐出来就用中序,要找离根最近的结点就用层序。复杂度上四种都是 O(n),但层序的队列会装下一整层,宽树上比深搜吃内存。
遍历方式应从数据依赖反推。若父结点结果依赖左右子树,就要先得到孩子再处理父亲,对应后序;若利用二叉搜索树“左小、根中、右大”的约束输出有序值,则用中序。层序让距离根相同的结点连续出现,适合最短层数、逐层聚合和宽度问题。
四种遍历都至少访问每个结点一次,时间为 O(n)。深度优先保存当前根到叶的路径,辅助空间 O(h);广度优先保存当前层的候选结点,最坏 O(w)。完全二叉树最后一层宽度接近 n/2,所以层序空间不能简单说成 O(log n)。
以一定的顺序规则,逐个访问二叉树的所有结点,这个过程就是二叉树的遍历。按照顺序规则的不同,遍历方式有以下四种:
- 先序遍历
- 中序遍历
- 后序遍历
- 层次遍历
按照实现方式的不同,遍历方式又可以分为以下两种:
- 递归遍历(先、中、后序遍历)
- 迭代遍历(层次遍历)
层次遍历的考察相对比较孤立,我们会把它放在后续的真题归纳解读环节来讲。这里我们重点要看的是先、中、后序遍历三兄弟——由于同时纠结了二叉树和“递归”两个大热命题点,又不属于“偏难怪”之流,遍历三兄弟一直是前端算法面试官们的心头好,考察热度经久不衰。
面试官追问
追问 1权限树里父节点的勾选状态取决于左右子树,候选人先处理父节点,有问题吗?
有。父节点处理的时候孩子还没算,只能事后回填或者重复算。这种「结果从下往上汇总」的就是后序:先递归左右,拿到返回值再处理自己,return combine(dfs(root.left), dfs(root.right)) 这个形状。
追问 2普通二叉树做中序遍历,输出一定是升序吗?
不一定。中序只规定访问顺序,不管值大小。只有二叉搜索树满足「左小、根中、右大」,中序才是有序的,这也是验证 BST 最常用的办法。
追问 3组织架构树里要找离 CEO 最近的一个异常节点,用 DFS 还是层序?
层序。它按层推进,第一个命中的一定是层数最小的,直接停。DFS 可能一头扎进很深的分支,找到一个深的再回来,还得比完所有分支才敢确定最浅。
追问 4一棵一百万结点的完全二叉树,树高才 20 左右,层序遍历为什么内存还是很高?
树高只决定深搜的栈深度。层序的队列要装下一整层,完全二叉树最后一层大约 50 万个结点,所以空间是 O(w) 不是 O(log n)。只是统计类需求的话可以换深搜。
追问 5求树的最大宽度和求树高,能用同一个遍历模板吗?
能写,但没必要硬统一。最大宽度天然是按层数个数,层序最直接;树高用递归后序一行就完:1 + Math.max(h(l), h(r)),空间只要 O(h)。
# 递归遍历初相见
30 秒速记
- 写递归先想清两件事:函数对一棵子树返回什么(契约)、什么时候停(边界)
- 树的边界一般是
root === null直接返回 - 当前层只管「相信左右子树已经算对了」,再把结果拼起来
- 每层调用都占一个栈帧,空间
O(h):平衡树O(log n),退化成链就是O(n) JS调用栈深度有限(一般几千到一万多层),用户可构造的超深数据要改显式栈
递归说白了就是一个函数处理一棵子树,遇到子树就交给自己,遇到空结点就停。 拿求树高举例,契约是「返回以 node 为根的高度」,空树返回 -1,非空就是 1 + Math.max(height(left), height(right)),当前层根本不用管子树里面怎么走。容易被忽略的是空间:局部变量再少,没返回的栈帧也在那里排着,深度多少就占多少,树退化成一条链就是 O(n)。数据来自用户、深度不可控的时候,我会改成手写栈,再限制最大深度。
以求高度为例,函数契约是“返回以 node 为根的子树高度,空树高度为 -1”。当前层无需知道子树内部细节,只取左右返回值的较大者加一:
function height(root) {
  if (root === null) return -1
  return 1 + Math.max(height(root.left), height(root.right))
}
每个结点计算一次,时间 O(n);调用栈空间 O(h)。不能因为局部变量少就说空间 O(1),未返回的栈帧会随深度增长。用户可构造的超深树应改用显式栈并限制最大结点数和深度。
编程语言中,函数Func(Type a,……)直接或间接调用函数本身,则该函数称为递归函数。
简单来说,当我们看到一个函数反复调用它自己的时候,递归就发生了。“递归”就意味着“反复”,像咱们之前对二叉树的定义,就可以理解为是一个递归式的定义:
- 它可以没有根结点,作为一棵空树存在
- 如果它不是空树,那么必须由根结点、左子树和右子树组成,且左右子树都是二叉树。
这个定义有着这样的内涵:如果我们想要创建一个二叉树结点作为根结点,那么它左侧的子结点和右侧的子结点也都必须符合二叉树结点的定义,这意味着我们要反复地执行“创建一个由数据域、左右子树组成的结点”这个动作,直到数据被分配完为止。
结合这个定义来看,每一棵二叉树都应该由这三部分组成:
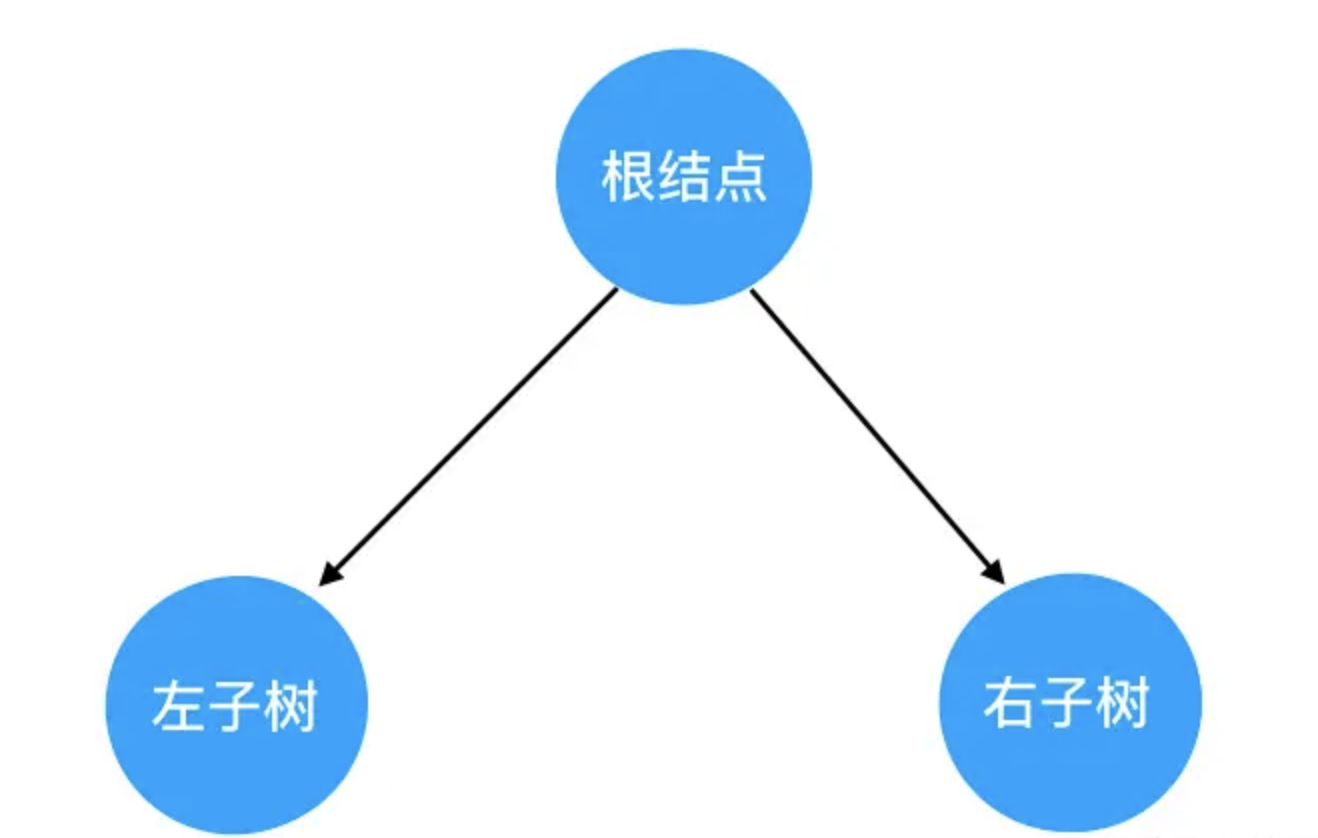
对树的遍历,就可以看做是对这三个部分的遍历。这里就引出一个问题:三个部分中,到底先遍历哪个、后遍历哪个呢?我们此处其实可以穷举一下,假如在保证“左子树一定先于右子树遍历”这个前提,那么遍历的可能顺序也不过三种:
- 根结点 -> 左子树 -> 右子树
- 左子树 -> 根结点 -> 右子树
- 左子树 -> 右子树 -> 根结点
上述三个遍历顺序,就分别对应了二叉树的先序遍历、中序遍历和后序遍历规则。
在这三种顺序中,根结点的遍历分别被安排在了首要位置、中间位置和最后位置。
所谓的“先序”、“中序”和“后序”,“先”、“中”、“后”其实就是指根结点的遍历时机。
面试官追问
追问 1白板上的 height 空节点返回 0、叶子返回 1,可接口文档说空树是 -1,怎么改?
先认清两种口径:按边数算空树 -1、叶子 0;按结点数算空树 0、叶子 1。递推公式不用动,只改边界 if (!root) return -1,然后把调用方用到高度的地方都核一遍,不然就是一个稳定的差一错误。
追问 2评论树递归只有十几行,碰到十万层的链式脏数据直接栈溢出,为什么?
每进一层就压一个栈帧,链式结构深度等于结点数,十万层远超 JS 引擎的调用栈上限,报 RangeError: Maximum call stack size exceeded。改成 while 加数组当栈,再在入口限制结点数和深度。
追问 3递归求树高,每个结点会被访问几次?退化成链会变慢吗?
每个结点只进一次,时间稳定 O(n),退化不会让它重复算。退化影响的是栈空间,从 O(log n) 变成 O(n),问题是会炸栈,不是变慢。
追问 4数据里如果出现子节点指回父节点,递归会怎样?
无限递归直到栈溢出,if (!root) return 挡不住环。不可信数据要用一个 Set 记录访问过的对象,if (seen.has(node)) throw ...,否则就别把它当树处理。
追问 5递归版和显式栈版的树高,你怎么选?
数据可信、深度可控就用递归,一行就能看懂。数据是用户上传或者第三方给的,就上显式栈,时间都是 O(n),差别只在会不会炸调用栈。
# 遍历方法图解与编码实现
30 秒速记
- 三种遍历一个骨架:判空 → 递归左 → 递归右,只挪「处理
root」那一行 - 那行放最前 = 先序,放中间 = 中序,放最后 = 后序
- 结果
push进数组返回,比函数里console.log好测