# 前置知识:完全二叉树
30 秒速记
- 完全二叉树:除最后一层都满,最后一层从左往右连续,中间不能空
- 所以能紧凑地塞进数组,不用存指针
- 下标从
0开始:父Math.floor((i - 1) / 2),左孩子2i + 1,右孩子2i + 2 - 最后一个非叶结点是
Math.floor(n / 2) - 1,建堆从这里往前下沉 - 它只约束形状,不管大小;加上父子大小关系才是堆
完全二叉树可以理解为「从上到下、从左到右一个挨一个排满」的树,最后一层可以不满,但不能跳着空。 正因为没有空洞,按层序把结点放进数组,下标就能直接算出父子关系,不用存指针。零基下标下,i 的左孩子是 2i + 1,右孩子是 2i + 2,父结点是 Math.floor((i - 1) / 2)。教材上常写的 (n-1)/2 在 JS 里要记得取整,不然会得到小数下标。这个结构只管形状,堆是在它上面再加大小约束。
完全二叉树是指同时满足下面两个条件的二叉树:
- 从第一层到倒数第二层,每一层都是满的,也就是说每一层的结点数都达到了当前层所能达到的最大值
- 最后一层的结点是从左到右连续排列的,不存在跳跃排列的情况(也就是说这一层的所有结点都集中排列在最左边)。
完全二叉树可以是这样的:
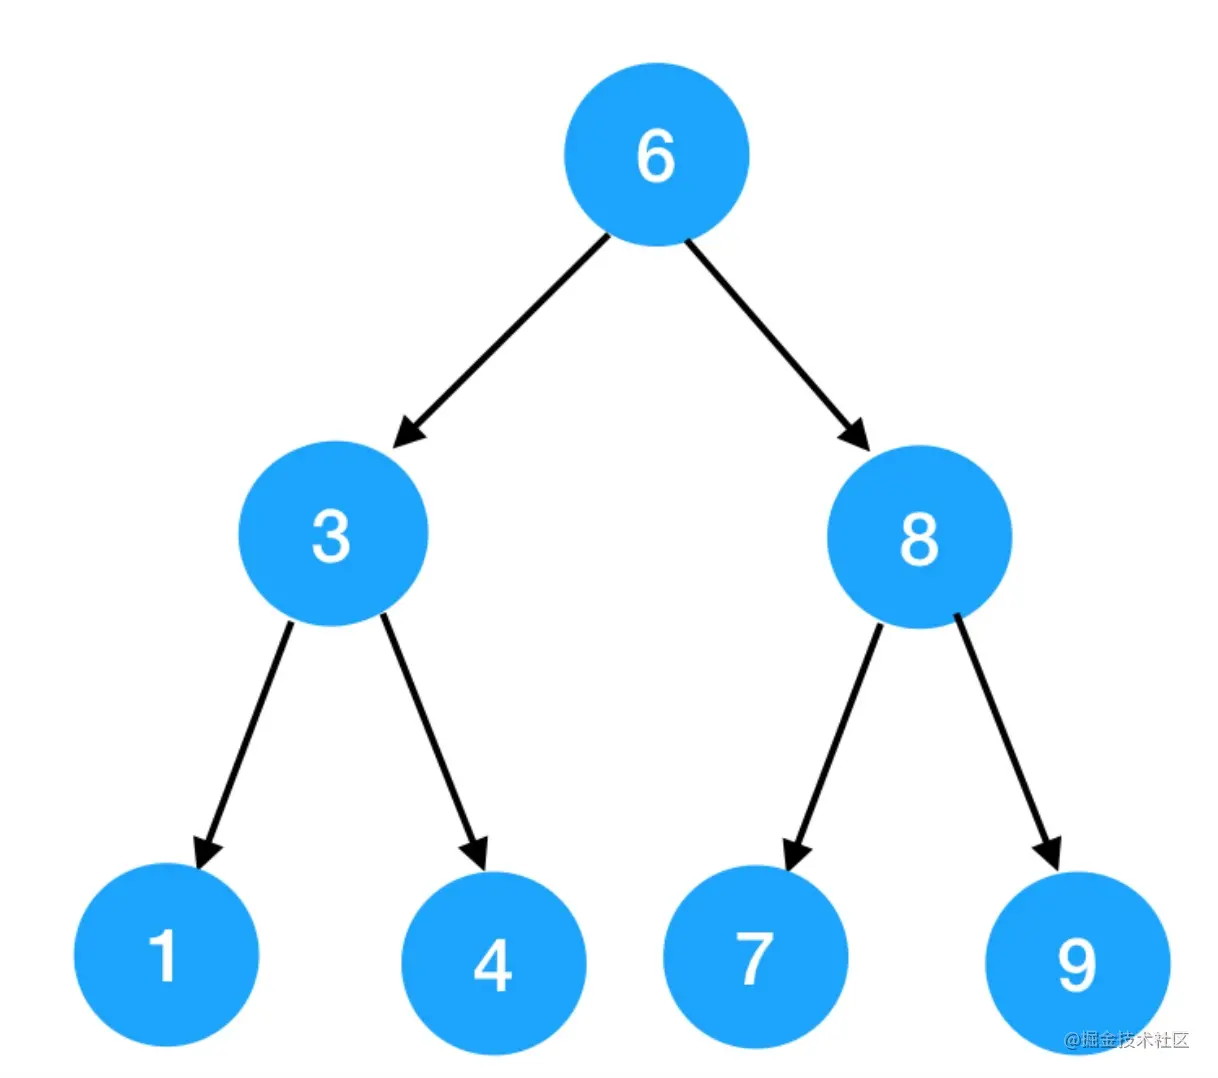
也可以是这样的:
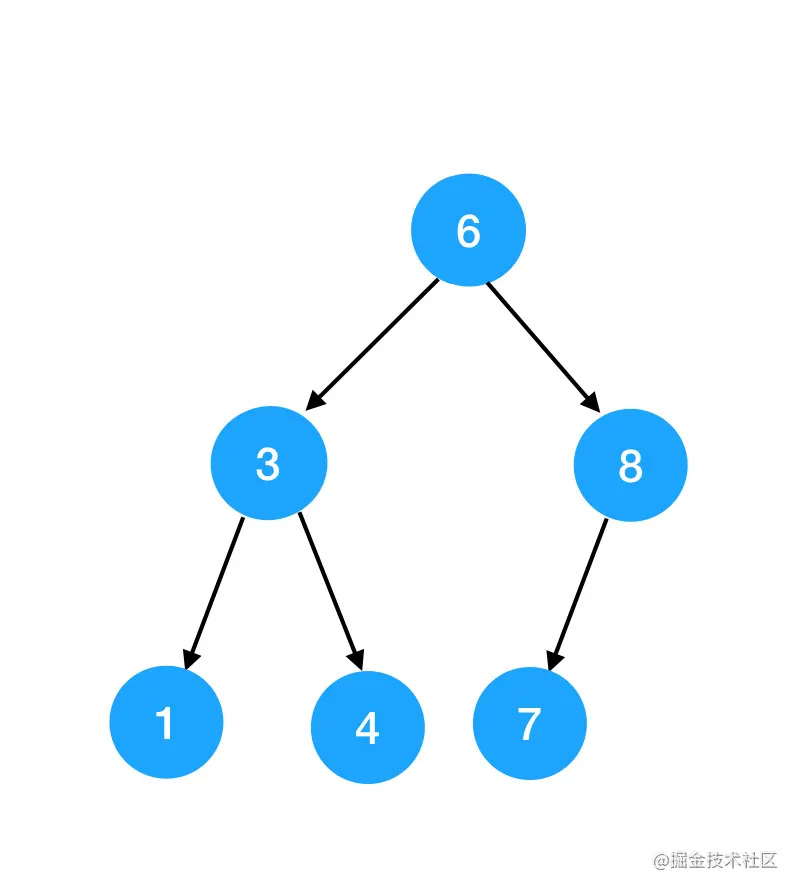
但不能是这样的:
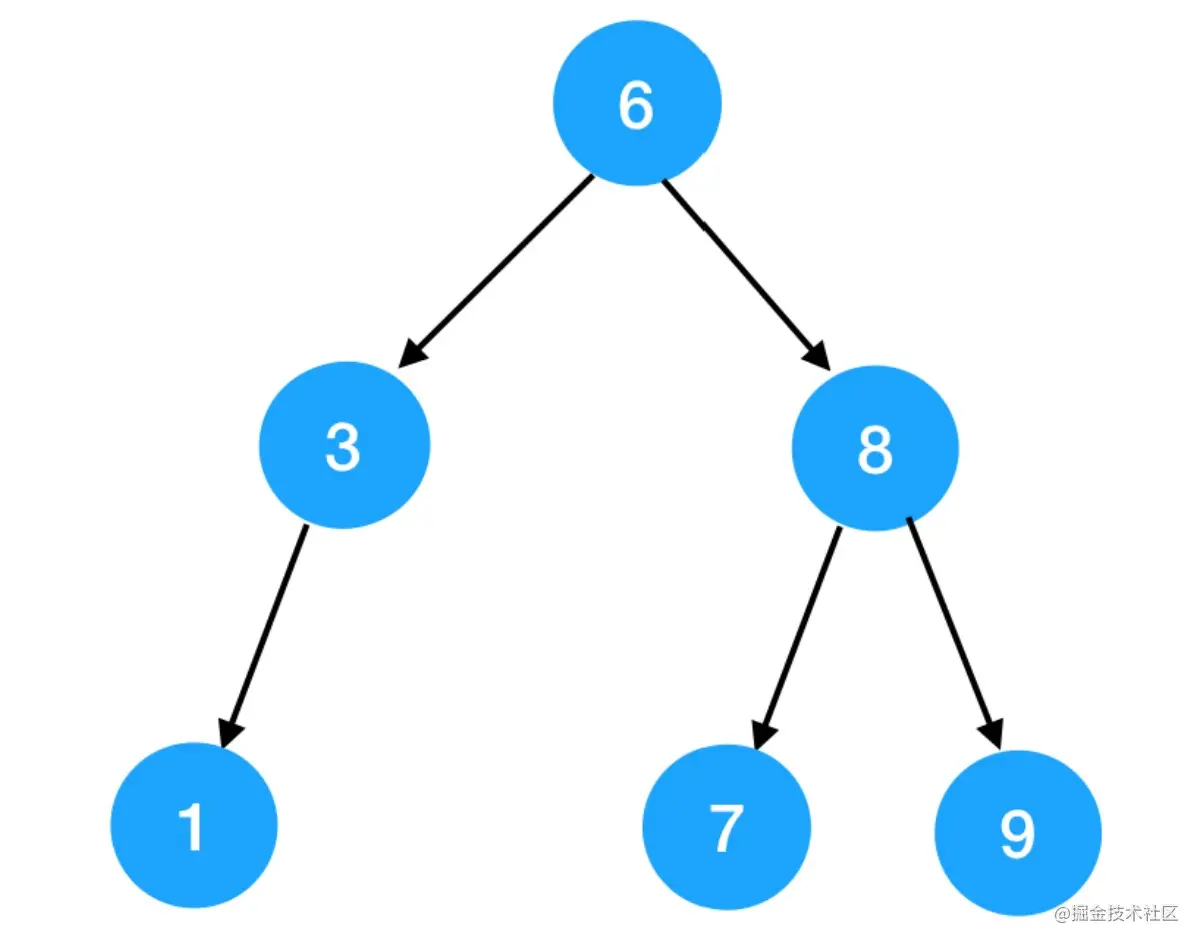
更不能是这样的:
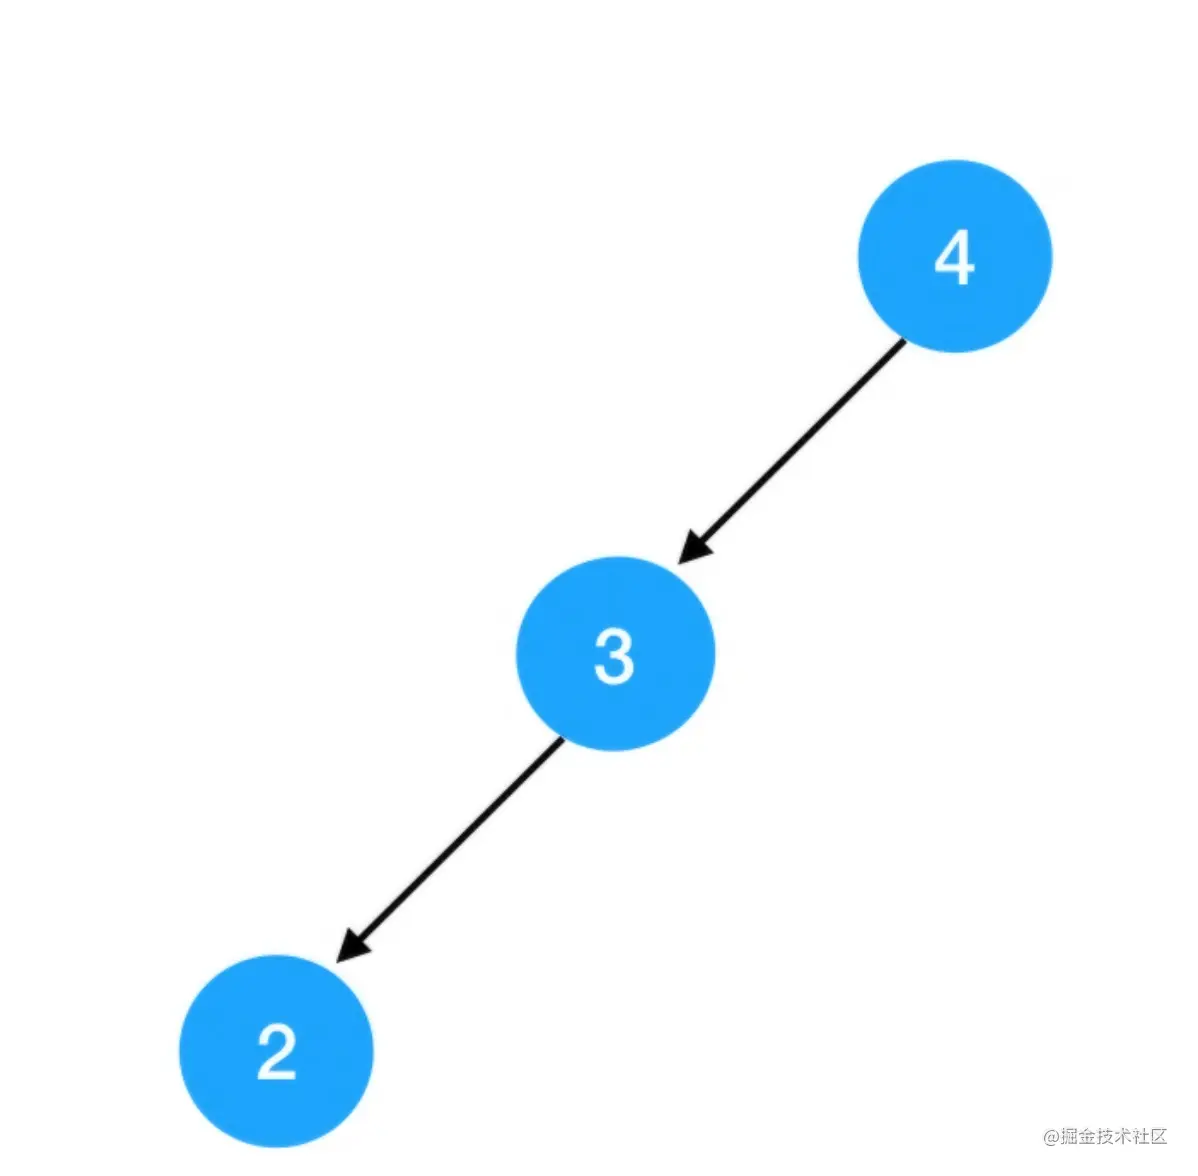
注意,完全二叉树中有着这样的索引规律:假如我们从左到右、从上到下依次对完全二叉树中的结点从0开始进行编码:
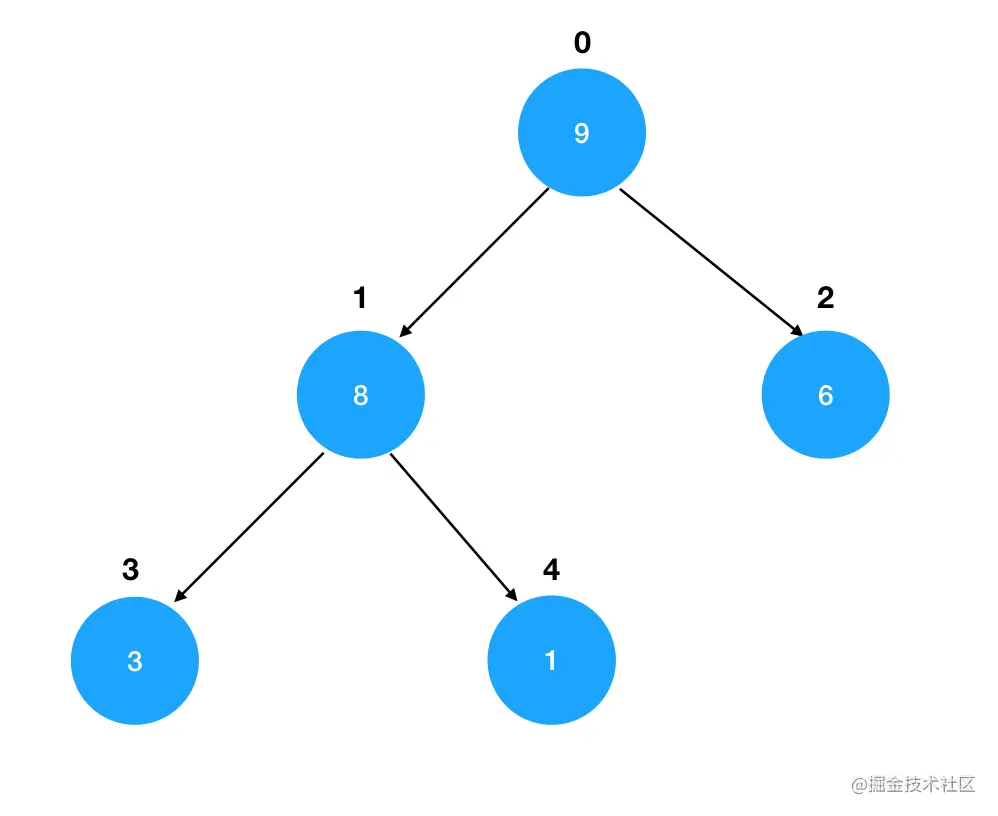
那么对于索引为 n 的结点来说:
- 索引为
(n-1)/2的结点是它的父结点 - 索引
2*n+1的结点是它的左孩子结点 - 索为引
2*n+2的结点是它的右孩子结点
面试官追问
追问 1JS 里直接写 heap[(i - 1) / 2] 会怎样?
i = 2 时下标是 0.5,取出来是 undefined。要写 Math.floor((i - 1) / 2) 或 (i - 1) >> 1。
追问 2如果下标从 1 开始,公式变成什么?
父 i >> 1,左孩子 2i,右孩子 2i + 1,更简洁。很多教材这么写,就是在下标 0 放个空位。
追问 3为什么不是完全二叉树就不适合用数组存?
中间有空位的话数组里也得留洞,最坏一条右斜链要 2^n 的空间。完全二叉树没有洞,n 个结点正好占 n 格。
追问 410 个结点的完全二叉树,哪些是叶子?
最后一个非叶结点是 Math.floor(10 / 2) - 1 = 4,所以下标 5 到 9 都是叶子。建堆只需要从 4 往前处理。
# 什么是堆
30 秒速记
- 堆 = 完全二叉树 + 父子大小约束
- 大顶堆:父 ≥ 孩子;小顶堆:父 ≤ 孩子
- 只保证父子关系,兄弟之间、同层之间没有顺序,数组整体不是有序的
- 读堆顶
O(1),插入、删堆顶O(log n),找任意值还是O(n) - 数组存储,缓存友好,
JS没有内置堆,要自己写
堆就是一棵完全二叉树,只多了一条规矩:大顶堆里父结点不小于孩子,小顶堆反过来。 所以堆顶一定是最大或最小值,这是它最大的用处:随时拿极值。但它只管父子,不管兄弟,[9, 8, 6, 3, 1] 是大顶堆,[9, 6, 8, 1, 3] 也是,所以堆不是有序数组,想找某个特定值只能遍历。工程上记住复杂度就够:看堆顶 O(1),插入和弹出堆顶都是 O(log n)。另外 JS 没有内置的 PriorityQueue,面试一般要手写。
堆是完全二叉树的一种特例。根据约束规则的不同,堆又分为两种:
- 大顶堆
- 小顶堆
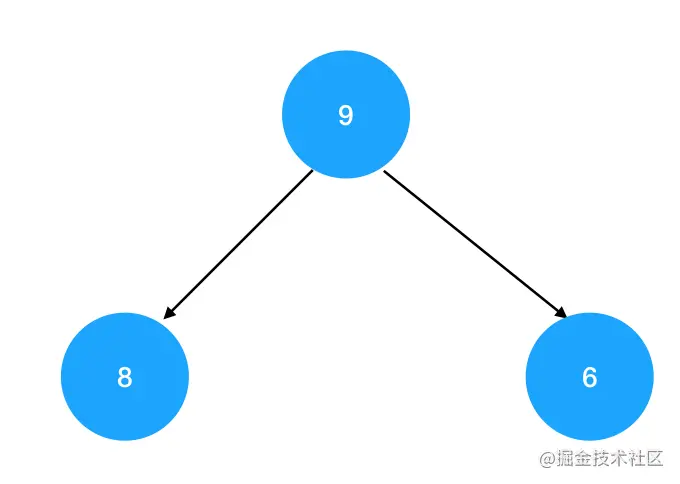
如果对一棵完全二叉树来说,它每个结点的结点值都不小于其左右孩子的结点值,这样的完全二叉树就叫做“大顶堆”:
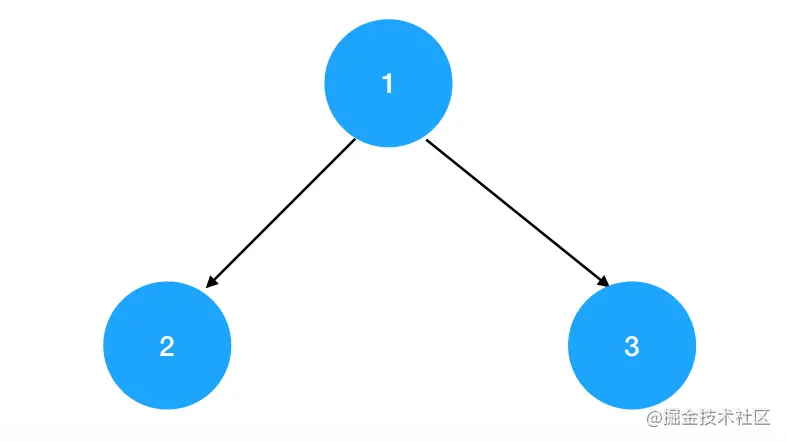
若树中每个结点值都不大于其左右孩子的结点值,这样的完全二叉树就叫做“小顶堆”
面试官追问
追问 1大顶堆的数组是不是从大到小排好的?
不是,只保证父 ≥ 子。比如 [9, 6, 8, 1, 3] 是合法的大顶堆,6 和 8 谁在前都行。
追问 2大顶堆里最小值在哪?
一定在叶子里,但不知道是哪个叶子,要扫后一半数组,O(n)。
追问 3堆和 BST 都能拿最大值,有什么区别?
堆拿堆顶 O(1),结构更紧凑,但找任意值要 O(n)。BST 找最值是 O(h),好处是能按值查找、能有序遍历。只要极值用堆,要按值查用 BST。
追问 4JS 里有没有现成的堆?
语言层面没有,Array 的 sort 不算。面试手写一个带 push / pop / peek 的类,工程里可以用社区的 priority-queue 库。
# 堆的基本操作:以大顶堆为例
30 秒速记
- 大顶堆就两个核心动作:删堆顶(下沉)、插入(上浮)
- 删堆顶:末尾元素补到根,再和较大的孩子比较往下换
- 插入:放到数组末尾,再和父结点比较往上换
- 都只走一条路径,
O(log n) - 建堆:逐个插入是
O(n log n);从最后一个非叶结点往前依次下沉是O(n)
堆的所有玩法都建立在两个动作上:删堆顶靠下沉,插入靠上浮,本质都是在修复「父不小于子」这条规矩。 删堆顶时拿末尾元素顶到根,保证还是完全二叉树,然后它往下和较大的孩子换,直到不比孩子小。插入时放到末尾,只可能和祖先冲突,所以沿父结点往上换。两个都只走一条路径,O(log n)。建堆可以从空堆开始反复插入,这能用但要 O(n log n);从最后一个非叶结点往前挨个下沉,整体只要 O(n)。
大顶堆和小顶堆除了约束条件中的大小关系规则完全相反以外,其它方面都保持高度一致。现在我们以大顶堆为例,一起来看看堆结构有哪些玩法。
这里我给出一个现成的大顶堆:
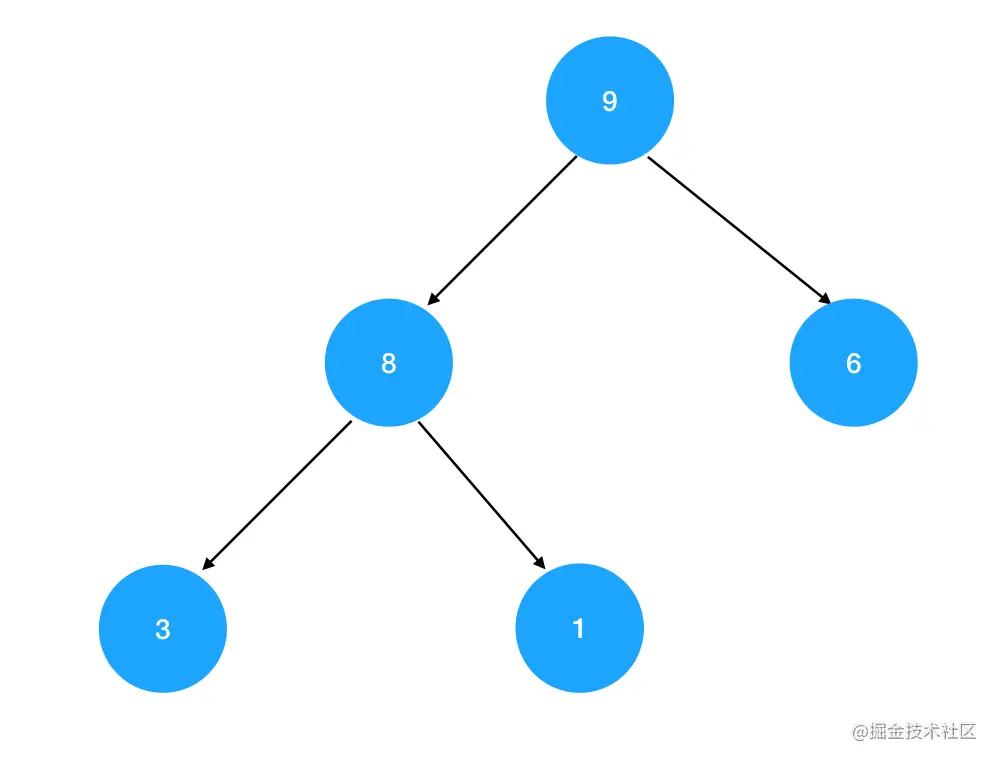
很多时候,为了考察你对完全二叉树索引规律的掌握情况,题目中与堆结构同时出现的,还有它的层序遍历序列:
[9, 8, 6, 3, 1]
我们需要关注的动作有两个:
- 如何取出堆顶元素(删除操作)
- 往堆里追加一个元素(插入操作)
至于堆的初始化,也只不过是从空堆开始,重复执行动作2而已。因此,上面这两个动作就是堆操作的核心。
面试官追问
追问 1下沉时为什么一定要和较大的孩子换?
和较小的那个换,换上去的值比另一个孩子还小,那一侧立刻违反堆序。换较大的,它当父结点能同时压住两个孩子。
追问 2自底向上建堆为什么是 O(n) 而不是 O(n log n)?
一半结点是叶子不用动,越往上的结点越少但下沉距离越长,加起来是一个收敛的级数,大约 2n 次。逐个插入是每个都可能上浮 log n 层。
追问 3删堆顶为什么拿末尾元素补,不直接把较大的孩子提上来?
一路提孩子最后空出来的位置可能在中间,就不是完全二叉树了。拿末尾补根,形状一定完整,只需要修大小关系。
追问 4大顶堆改成小顶堆要改哪里?
只改比较方向:下沉选较小的孩子、比孩子大才换,上浮比父结点小才换。最好把比较抽成一个 compare 函数,一份代码两种堆都能用。
# 取出堆顶元素
30 秒速记
- 先记住堆顶,用最后一个元素覆盖根,数组长度减一
- 下沉:先在左右孩子里挑大的,当前值比它小就交换,继续往下
- 当前值 ≥ 较大孩子,或者没有孩子了,就停
- 右孩子要先判断存在
j + 1 <= high,否则会读到undefined O(log n)时间、O(1)空间;只有一个元素时直接弹出
取堆顶分三步:存下堆顶,把最后一个元素挪到根上,再让它一路往下沉。 下沉每一步先在两个孩子里挑大的,当前值比它小就换下去,否则就停,因为两个孩子都不比它大了。写代码时边界最容易错:
function pop(heap) {
  const top = heap[0]
  const last = heap.pop()
  if (heap.length) {
    heap[0] = last
    let i = 0
    while (true) {
      let j = 2 * i + 1
      if (j >= heap.length) break
      if (j + 1 < heap.length && heap[j + 1] > heap[j]) j++ // 挑较大的孩子
      if (heap[i] >= heap[j]) break
      ;[heap[i], heap[j]] = [heap[j], heap[i]]
      i = j
    }
  }
  return top
}
// pop([9, 8, 6, 3, 1]) 返回 9,堆变成 [8, 3, 6, 1]
只有一个元素时 heap.pop() 之后就空了,不能再把 last 放回去。
取出元素本身并不难,难的是如何在删除元素的同时,保持住队的“大顶”结构特性。为了做到这点,我们需要执行以下操作:
- 用堆里的最后一个元素(对应图中的数字1)替换掉堆顶元素。
- 对比新的堆顶元素(1)与其左右孩子的值,如果其中一个孩子大于堆顶元素,则交换两者的位置:
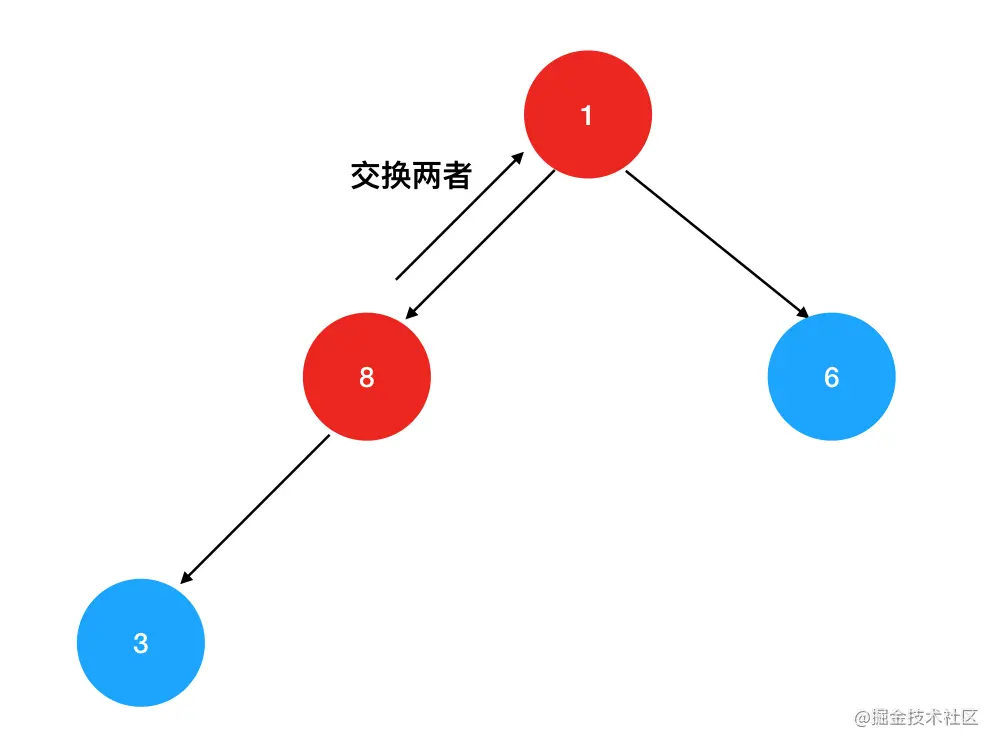
交换后,继续向下对比1与当前左右孩子的值,如果其中一个大于1,则交换两者的位置:
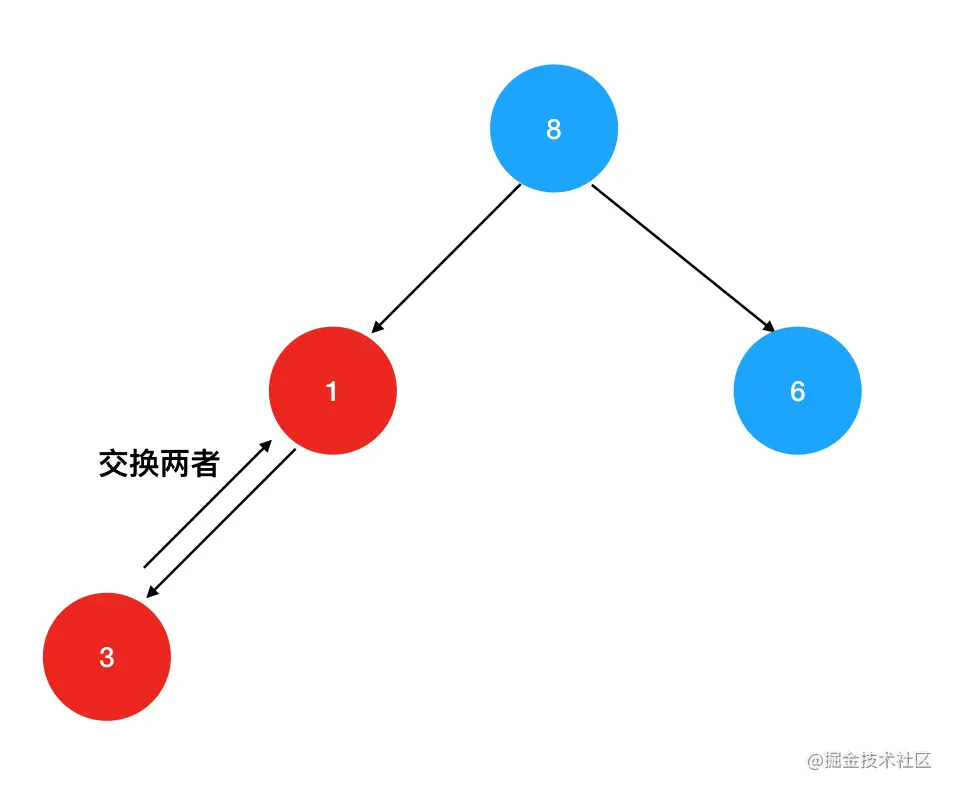
重复这个向下对比+交换的过程,直到无法继续交换为止,我们就得到了一个符合“大顶”原则的新的堆结构:
上述这个反复向下对比+交换的过程,用编码实现如下(仔细看注释):
// 入参是堆元素在数组里的索引范围,low表示下界,high表示上界
function downHeap(low, high) {
    // 初始化 i 为当前结点,j 为当前结点的左孩子
    let i=low,j=i*2+1
    // 当 j 不超过上界时,重复向下对比+交换的操作
    while(j <= high) {
        // 如果右孩子比左孩子更大,则用右孩子和根结点比较
        if(j+1 <= high && heap[j+1