知识库选模型,先分清读取与生成耗时
作者在同一问答链路中切换三个模型,观察标题摘要筛选与答案生成的耗时差异。案例中本地 7B 模型读取约 3500 token、仅输出 34 token 仍耗时 27.5 秒,说明上下文容量不能代表实际处理速度。
AI 深度解读
同一套知识库问答,换模型后最先暴露差异的,是那一步只返回几个编号的「勾选」。作者测到,局域网里的 qwen2.5:7b 读约 3500 个 token,只输出 34 个 token,勾选却花了 27.5 秒。答复写得短,前面要读的材料可一点也不少。
这组记录值得做 AI 问答的前端和全栈同学看。它把选条目、写答复、核对拆开,让你看清一次答错究竟是选错了资料、漏写了事实,还是把原文没有的要求加了进去。
只返回编号,为什么还能等 27.5 秒?
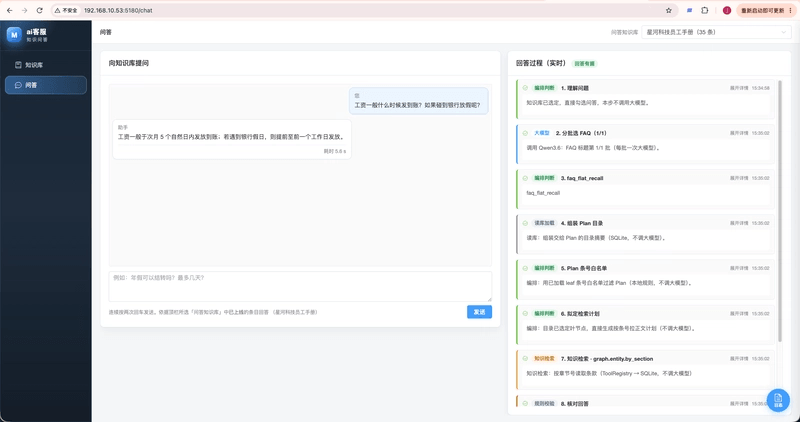
这条链路把标题和摘要一次交给模型,由模型返回条目编号。命中后,模型再读两三条正文写答复。知识库已经选定时,「理解问题」由程序编排,跳过模型调用。普通命中题调用模型 2 次,年假题因为涉及数量计算和改写而调用 4 次,年终奖题因召回为空只调用 1 次,测试记录里的运行错误为 0。
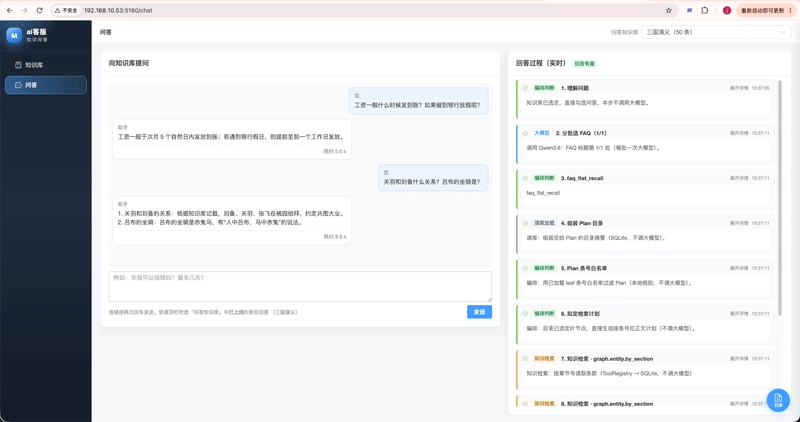
三国演义库有 50 条问答。问刘备和关羽的关系,qwen2.5:7b 读约 3500 个 token,输出 34 个 token,选中两条。作者记录到当时几乎没命中提示缓存,并据此判断,主要耗时在处理输入。Qwen3.6 服务上报的 262144 token(256K)是上下文容量,衡量的是一次能装多少内容,单凭这个数字推不出处理速度。
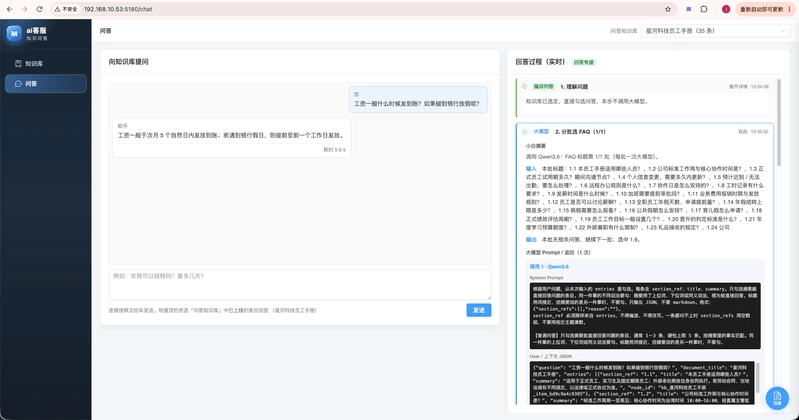
智谱 glm-4-flash-250414 在同类问题上的勾选多为 1.2 到 2.7 秒,有一次达到 9.6 秒。Qwen3.6 处理星河库 35 条资料里的发薪题,从读库到给出答复用时 5.6 秒。切到三国库问关羽、刘备和吕布,整条链路用时 8.9 秒。勾选耗时和整条链路耗时要分开看。
切模型只改一项,怎么确认请求真发对了?
作者用下面这段配置固定三个后端,把切换入口集中到 MYCS_LLM。
MYCS_LLM=glm
GLM_API_BASE=https://open.bigmodel.cn/api/paas/v4
OLLAMA_BASE_URL=http://192.168.10.110:11434/v1
OLLAMA_MODEL=qwen2.5:7b
QWEN_BASE_URL=http://192.168.10.175:8000/v1
QWEN_MODEL=Qwen3.6
第一行决定实际走哪套配置,改成 qwen 或 ollama 后要执行 scripts/restart-dev.sh,服务才会切换。本机保留智谱密钥也不会改变这个选择,密钥留在本机 .env。作者遇到过 Shell 里旧的 OpenAI 兼容地址把请求带到其他网关,于是让启动脚本先读项目 .env,以项目里的 MYCS_LLM 为准。模型工厂位于 src/mycs/llm/factory.py。
另一个坑出现在 Qwen3 一类接口上。默认 thinking 可能先花掉生成额度,导致正文为空、JSON 解析失败。这条链路在兼容接口里默认设置 enable_thinking: false,需要思考时再单独打开。
换模型救回了哪些题,还有哪些答不全?
11 月 21 日,作者用同一条链路跑了三本已上线的库。智谱 flash 在权游的 12 题里标题全部选对,但铁王座漏写了「数千把宝剑」。三国库答对蜀、魏、吴的灭亡顺序,却漏选司马炎建晋的条目。两个库也都拒答了各自的库外问题。
星河库改提示前,13 题里只有 7 题完全正确。作者改了作答提示、数量计算和核对标准,随后用智谱和 Qwen3.6 跑同一组 13 题。智谱改完仍有三道出错,换模型后的变化最能说明问题。
- 笔记本丢失。智谱面对写着「设备丢失」的摘要返回空数组,Qwen3.6 选中
1.27,答出两小时内上报。 - 绩效目标。智谱两次都指向举报条目
1.34,删掉疑似误导的提示后仍指向它。Qwen3.6 找回目标调整条目1.19,漏了正式评估条目1.18。 - 离职。智谱只留下归还资产,还补了一句原文没有的「应结清年假」。Qwen3.6 找回提前通知、报销期限、年假和归还资产,但漏了结转上限
1.14,还把报销时限写成了「必须」,所以只算部分正确。
我的判断
我最认同的是把条目选对和答复写全分开评分。权游的铁王座是典型例子,补检索解决不了模型已经读到却漏写的事实。绩效题则适合检查返回编号是否真的对应那段摘要。作者提出过在模型返回编号后由程序过滤不相关条目,但还没实现,能拦下多少错选、会不会误删相关条目,仍是未知数。
这组结果能支持在这 13 题和这一版提示上优先试 Qwen3.6。原文没给出两次正式对照的完整正确率和逐题耗时,7B 也没跑这 13 题,所以整体提速仍是经验判断。逐条让模型读完的做法在几十条资料上容易排查。库继续变大时,可以对照先检索再勾选的做法,看看省下的输入和耗时会不会以漏掉相关条目为代价。这篇没有做这组对照。
能拿来做什么
- 给问答过程面板分别标出程序编排、模型勾选和模型撰写,在实际发起模型请求的步骤显示模型名和耗时。
- 在 Node 问答服务里记录勾选的输入和输出 token、缓存命中与分阶段耗时,换模型时用同一版提示和同一组题对照。
- 给回归题同时标注预期条目编号和答复必须覆盖的事实,单独记录错选、漏选、漏写和擅自添加的措辞。
- 在启动时核对生效的后端和模型名,并用一道题检查勾选接口是否返回可解析的 JSON。