已选知识库后,删掉多余的模型路由
作者将小型知识库改为扁平问答:模型先从标题摘要中选编号,程序取出全文后再生成答复,并用规则核对。用户已经选定知识库时,链路跳过意图路由,减少目录遍历带来的选错与漏选。
AI 深度解读
用户已经在界面上选了知识库,程序就可以直接去这个库找答案。作者把原先的意图分类和按目录逐层检索,改成了让模型从并列的 FAQ 里选编号,再由程序取原文、交给模型作答并核对。
这套改法把职责划得很清楚。前端已经知道用户选了哪个库,后端也知道哪些编号有效。模型主要处理两件事:识别用户的说法对应哪条 FAQ,以及把取回的原文组织成答复。
知识库选定后,可以省掉哪一次调用?
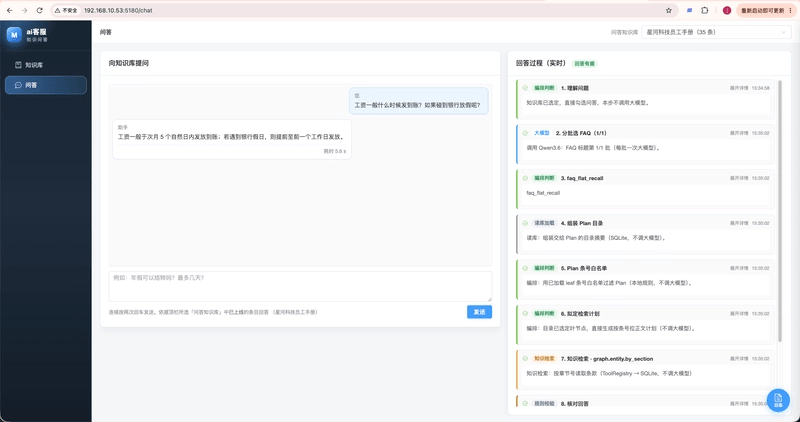
作者用「星河科技员工手册(35 条)」演示了这条链路。用户问工资何时到账、碰上银行放假怎么办。过程面板显示,「理解问题」由程序直接跳过,首次模型调用才交给 Qwen3.6 勾选 FAQ。整次耗时 5.6 秒,答复里的「次月 5 个自然日内」和「提前到前一个工作日」都来自同一条制度。
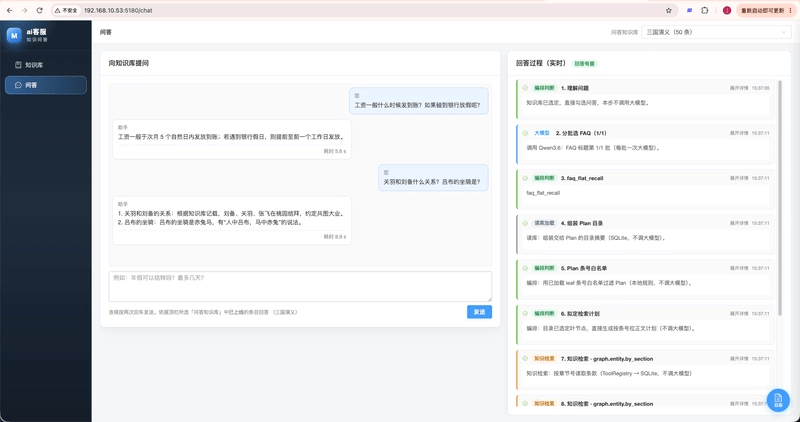
同一会话把顶栏切到《三国演义》后,用户又问关羽和刘备的关系、吕布的坐骑。系统仍然先跳过理解步骤,再从当前库勾选条目,按原文答出桃园之义和赤兔马。这次耗时 8.9 秒。办件、办事指南等没有选定知识库的入口,仍走原来的理解流程。
为什么让模型勾编号,再由程序取正文?
早期版本先让模型选章节,再往下找。这个做法有两个容易漏掉答案的地方:第一步可能选错章,即使选对,也可能漏掉隔壁章节里同样适用的条款。比如现行手册规定,满一年有 15 天年假,结转上限是 30 天。已有 8 天再满一年,余额是 23 天。旧版出现过的 7 天已经废弃,30 天则是上限。要答对这类题,得把相关条款一起取回来。
扁平 FAQ 让所有条目处在同一层。作者目前上线了六份知识库,每份都在 120 条以内,因此每次可以把整份已上线条目放在同一批。分批时由程序遍历所有批次并合并编号,防止模型在第一批返回 done 后漏掉后面的答案。
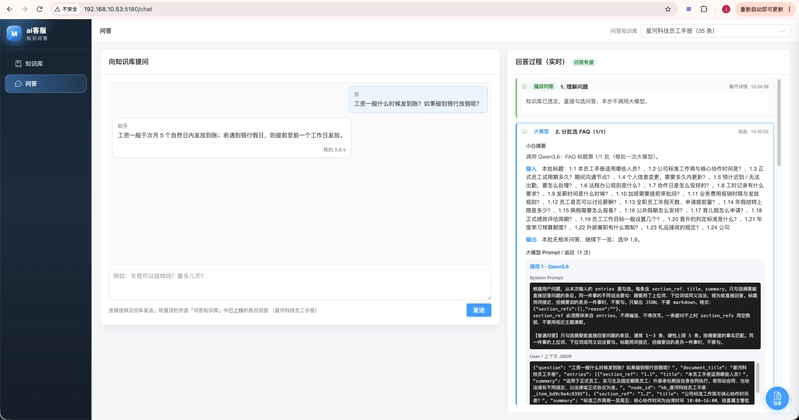
勾选阶段用三个字段给模型足够的判断依据,同时把全文留到选中后再读。
section_ref   编号,例如 1.9
title         问题
summary       答案开头
summary 是模型判断条目能否回答问题的依据。标题相似时要看摘要有没有覆盖关键事项。「笔记本丢失」和「设备丢失」这种上下位词也要能匹配。
发薪示例中,模型用下面的结构交回选中的条目。
{"section_refs":["1.9"],"reason":""}
程序只接受本次列表里出现过的 section_refs。如果没有匹配项,比如在手册里问年终奖发放规则,就返回空数组并停止。命中时通常调用模型两次,分别用于勾选和作答。年假这类计算题会多一次改写,核对则由程序根据答复和取回的正文完成。
我的判断
用界面上已经确定的知识库做路由,是这套设计里最容易复用的部分。扁平勾选能减少跨章节漏查,但前提是摘要能覆盖真正决定答案的条件。原文的 summary 取自答案开头,如果例外写在条目末尾,仍可能在取正文之前就被漏掉。作者也提到,小模型加了同义词和上下位词的提示后,仍然会勾错。
5.6 秒和 8.9 秒是两次演示的端到端耗时。原文没给旧链路的同题耗时、召回率或核对规则的误判数据。作者估计,50 到 100 条做向量点积通常不到一秒,可以避开 7B 模型通读列表时的几十秒,再把大约 8 条候选交给模型挑。这是经验判断,短名单方案也还没接入主链路。全量勾选让模型有机会看到每条摘要,短名单有望减少读取时间,但候选漏掉的条款,下一步也看不到。
能拿来做什么
- 如果前端已经要求用户选择知识库,就把知识库 ID 传给 Node 后端,由后端直接限定 FAQ 范围,选库和未选库的入口分别处理。
- 在 Node 服务里用本次候选集合校验
section_refs,过滤无效编号。过滤后为空就直接返回未找到,有命中再取正文并调用作答模型。 - 给 FAQ 回归测试加上同义改写、一问多事、标题相似但摘要答不了和库内无答案的题。分别记录勾选编号与最终答复,方便定位问题发生在检索还是作答。