用发布门槛和证据约束修正知识库问答
实践通过草稿与已上线状态隔离问答,并统一批量导入格式,避免未审核内容进入回答链路。针对多事项漏选、错误拒答和条件判断偏差,作者调整了选条与作答提示。
AI 深度解读
内部手册问答有时会在同一句回答里写出正确规则,又说这条规则没查到。作者用星河手册的 13 道题排查这类错误,把流程拆成三道关:发布决定模型能看到什么,勾选决定拿哪条作依据,核对决定哪些句子能交给用户。
同一套题的完全正确数从 7 道升到 10 道,换用 Qwen3.6 后到了 11 道。最容易复用的改动是把能确定的事交给程序,比如拦住草稿、计算年假余额。模型继续负责选条目和组织答案。
问答为什么要先发布,再给模型看
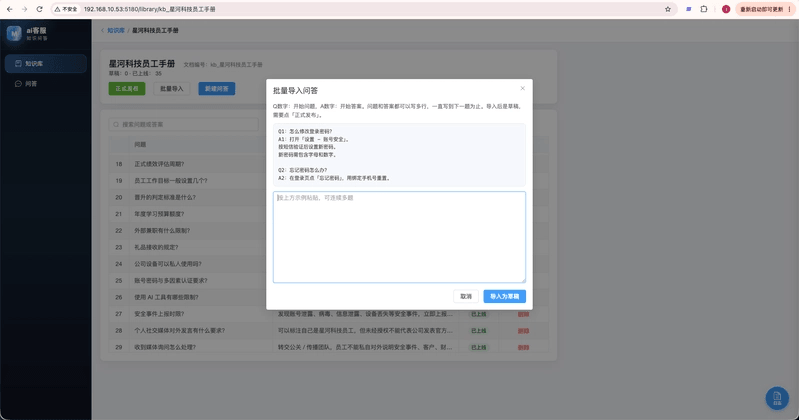
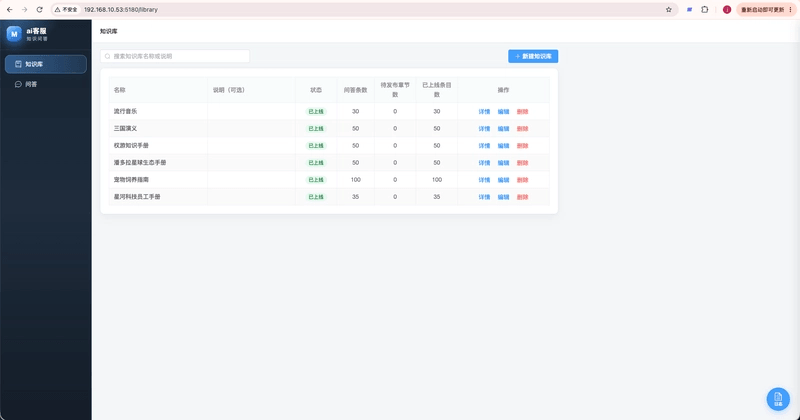
导入和新建的问答都先进入草稿,问答页只读已上线条目。星河手册当时是草稿 0 条、已上线 35 条,界面也能查看六本知识库的条数。还没点「正式发布」时,即使后台已经录入答案,用户提问也会像在查一本空库。条目上线后,编号用来定位,答案正文直接作为引用依据。
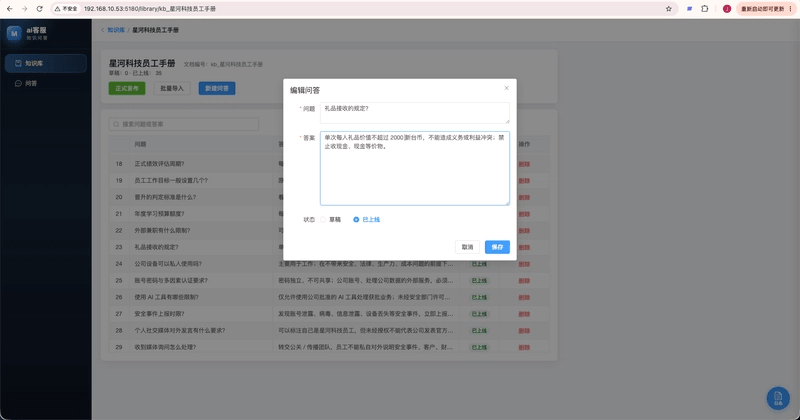
批量导入用下面的文本约定,把外部模型整理的材料转成问答草稿。
Q1:工资一般什么时候发到账?
A1:工资按月发放,一般次月 5 个自然日内发放;遇银行假日,提前至前一个工作日发放。
A1 和 Q1 用同一编号配对,问题和答案都可以跨行,下一题开始时才结束当前条目。旧格式 ### Q1 配 答: 也能解析。作者有一次用了另一套标题格式,解析结果是 0 行,问答随即全部拒答。
勾到了条目,为什么答复还是会错
勾选时,程序传入 question、document_title、entries、enumerative_query、composite_query 和 max_picks,每条 entry 只带编号、标题和摘要。作者删掉了关于父章节、叶子、批次和返回 done 的提示。程序负责分批,模型只需判断眼前哪些条目能回答问题。
普通单题仍提示通常选 1~3 条,枚举题保留自己的上限说明。复合题移除了普通上限提示,要求每件事都找到依据。此前离职题同时问到年假、报销和电脑,模型只留下了归还资产。
答复有证据,也得把证据用对。发薪条目已经说明银行假日会提前发放,模型却又补了句「未检索到银行放假怎么处理」。礼品条目规定单次每人不超过 2000 新台币,禁止现金和现金等价物,也禁止造成义务或利益冲突。题目既然给出了客户要求「优先考虑」的事实,答复就应按规则判定不能收。旧核对只要求勾到至少一条,这类错误照样通过。后来核对继续拦截空召回,并把分号也作为切句符号,才拦住用分号连写「应结清年假」和「未检索到」的答复。config/prompts.txt 每次调用重新读取,改提示下一问就生效,换模型名仍需重启进程。
年假余额能算出来,就交给程序算
题目给了已结转 8 天,原文写满一个工作年新增 15 天、结转上限 30 天。提示已要求先加后封顶,智谱仍然答成 30 天。作者改用程序提取已有、新增和上限,三类数字都恰好出现一次、单位都是天时,才算 min(已有+新增, 上限)。这题得 23 天,上限如果是 20 天,结果就是 20 天。缺数或单位对不上时,仍交给模型。结论算错时只替换结论,依据段保留。
作者报告这道题后来稳定写成 23 天。Qwen3.6 的一次运行耗时 12.3 秒,共调用模型 4 次,日志记录了 8、15、30 和 23。
我的判断
确定性计算是这里最扎实的改动。数字来自题目和正文,算错时也有明确的纠正办法。提取规则只覆盖少数固定措辞和统一单位,能处理多少写法,原文没有给数据。
核对的 11/13 和答题完全正确的 11 道是两种统计。核对失败里,年终奖空召回符合预期。作者还记录了一次离职答复因两句都含「离职」而被误拦,显示关键词重合不足以判断是否有依据。三轮结果里也有模型变更,原文没有逐项对照数据,提示、计算和换模型各自贡献多少仍是经验判断。
作者认为 35 到 100 条问答的标题和摘要能放进 256K 窗口。这只能判断容量。原文没有向量短名单的对照,也只给出了单题时延,无法据此判断整份列表勾选与向量预筛哪种更快、更准。
能拿来做什么
- 给前端知识库的导入预览显示解析条数和发布状态,解析出 0 条时就把结果告知维护者。
- 在 Node 里给单位一致、输入齐全的上限计算写纯函数,并用缺值和触顶两种情况验证回退逻辑。
- 给内部问答留一组固定回归题,覆盖空召回、复合问题和同词误拦,分别记录勾选结果、答案正确性和核对结果。