DeepSeek 更新后,Agent 成本该怎么算
文章分析 DeepSeek V4.1-Flash-1017 在单价不变、输出缩短情况下的任务成本,并区分厂商跑分与独立验证。示例中输出减少30%仅使30轮任务费用下降约22%,轮数和上下文重复输入同样影响账单。
完整中文译文
DeepSeek V4.1-Flash-1017 的看点,是 API 单价没变,但模型可能用更短的输出、更少的步骤完成任务。对于反复调用工具的 Agent,真正该比较的是完成一个任务花多少钱,而不只是每百万 token 的价格。
原文把厂商跑分、计费规则和一个简化成本模型放在一起分析:回复缩短 30%,示例账单只减少约 22%;轮数、缓存命中和执行时段,可能带来更大的差别。这个分析值得借鉴,但其中没有作者亲自跑出的模型评测。
跑分全面上涨,能说明它更适合 Agent 吗
据原文,DeepSeek 在 2026-10-17 发布 V4.1-Flash-1017,定位是 V4.1-Flash 的小版本更新,覆盖推理、编程、Agent 和视觉能力,同时宣称缩短任务执行时间与输出长度。权重和仓库采用 MIT 许可,模型卡没有交代训练数据和训练代码。
厂商表格里的 11 项基准全部上涨,增幅为 2.0 至 11.1 分,平均增加 5.2 分。但与 Claude Opus 5 比较,新模型只赢了其中 4 项,另外 7 项落后。
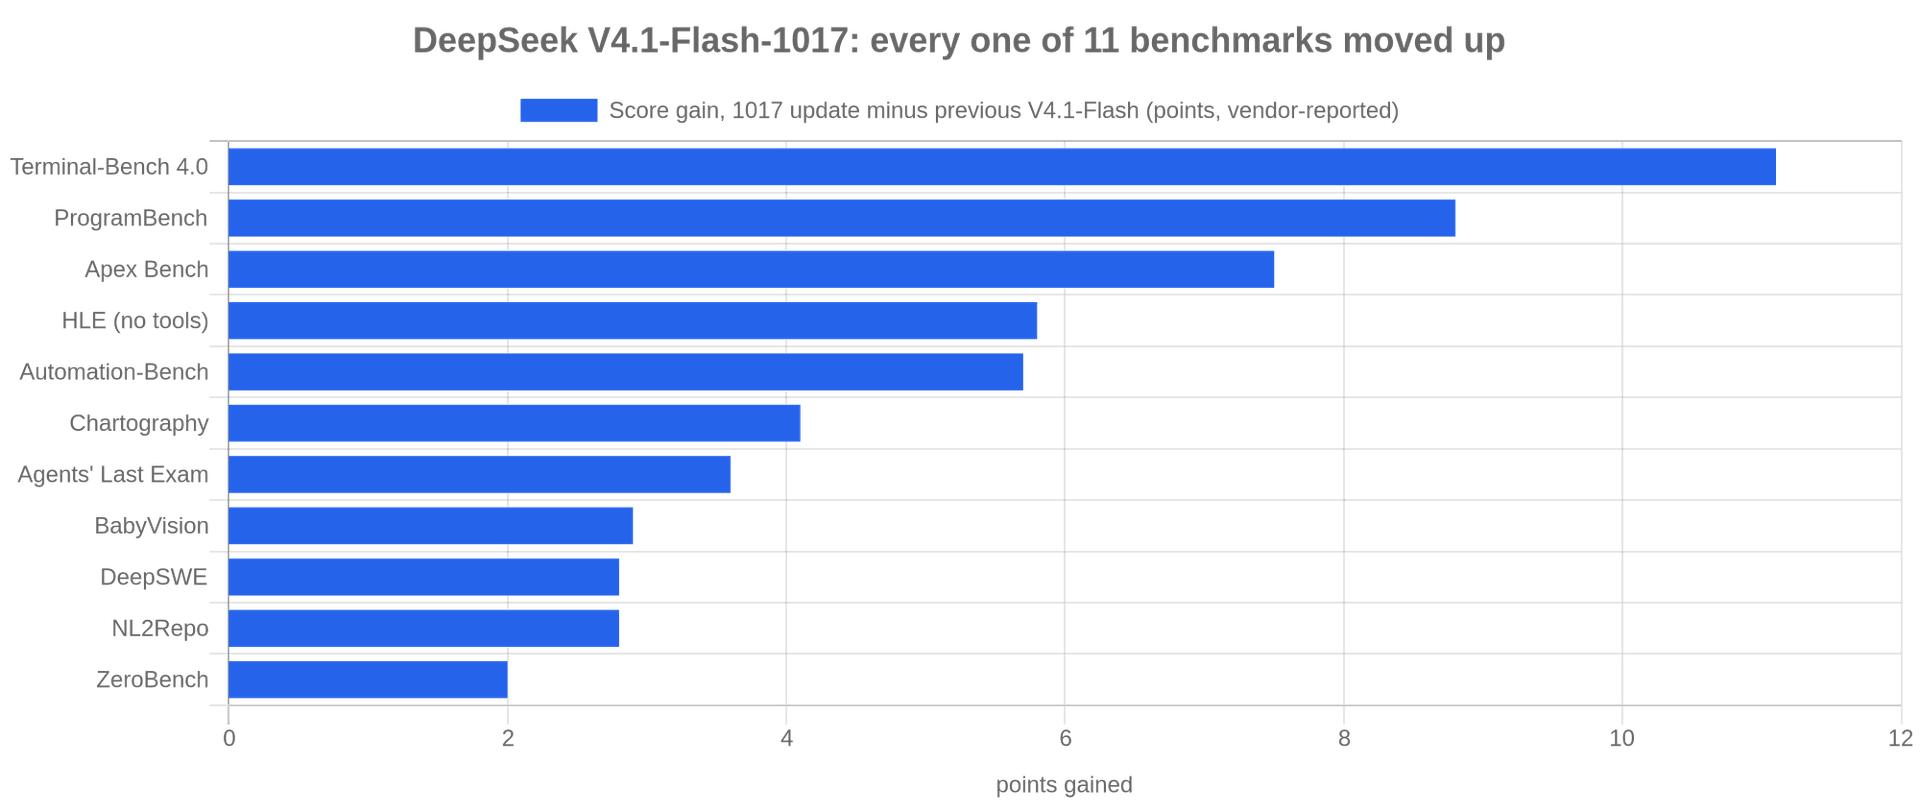
赢下的项目集中在 Agent 编程和工具使用:
- DeepSWE v1.1:77.0 对 74.0。
- Automation-Bench:60.5 对 50.3。
- Agents' Last Exam:35.4 对 28.6。
- Apex Bench v1.1:72.1 对 65.8。
这能支持「值得拿来测试工具任务」,还不足以支持「综合能力超过 Opus 5」。例如 HLE 上,它仍落后 13.7 分。
评测执行框架(harness)也会影响结果。模型卡说明,Terminal-Bench 4.0 使用 Claude Code harness,DeepSWE v1.1 使用 Mini-SWE-V2 harness。Kimi K3 在前者只有 12.6 分,其他三个对比模型则在 37.9 至 51.8 分之间。作者怀疑这可能涉及框架适配差异,但没有验证,不能把猜测当作原因。
另一个更直接的变化在 API:当前名称是 deepseek-flash,旧名称 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 虽然仍可调用,背后已经转到新模型。固定模型名称,并不等于固定了模型行为。
回复少写 30%,为什么账单只降约 22%
原文引用的价格截至 2026-10-22,Flash 非高峰时段每百万 token 收费为:未缓存输入 $0.15,缓存输入 $0.003,输出 $0.60。高峰时段全部翻倍。
作者没有测量真实业务,而是假设一个 Agent:初始提示词 8,000 token,每轮追加 2,000 token 工具结果,之后重新发送完整对话;旧前缀命中缓存,新内容按未缓存输入收费。
下面这段代码说明了输入为什么会累积,以及输出如何进入下一轮上下文:
def loop(turns, init, tool, out):
    ctx = init
    hit = 0
    miss = init
    for t in range(1, turns):
        hit += ctx            # prefix served from cache
        new = tool + out      # newly appended tokens, uncached
        miss += new
        ctx += new
    return hit, miss, out * turns

FLASH_OFFPEAK = dict(hit=0.003, miss=0.15, out=0.60)  # USD per 1M tokens

def cost(hit, miss, out, p):
    return (hit * p["hit"] + miss * p["miss"] + out * p["out"]) / 1e6
要看的是 new = tool + out:模型上一轮的回复,也会成为下一轮需要付费读取的输入。这里是简化记账,没有模拟真实工具调度。
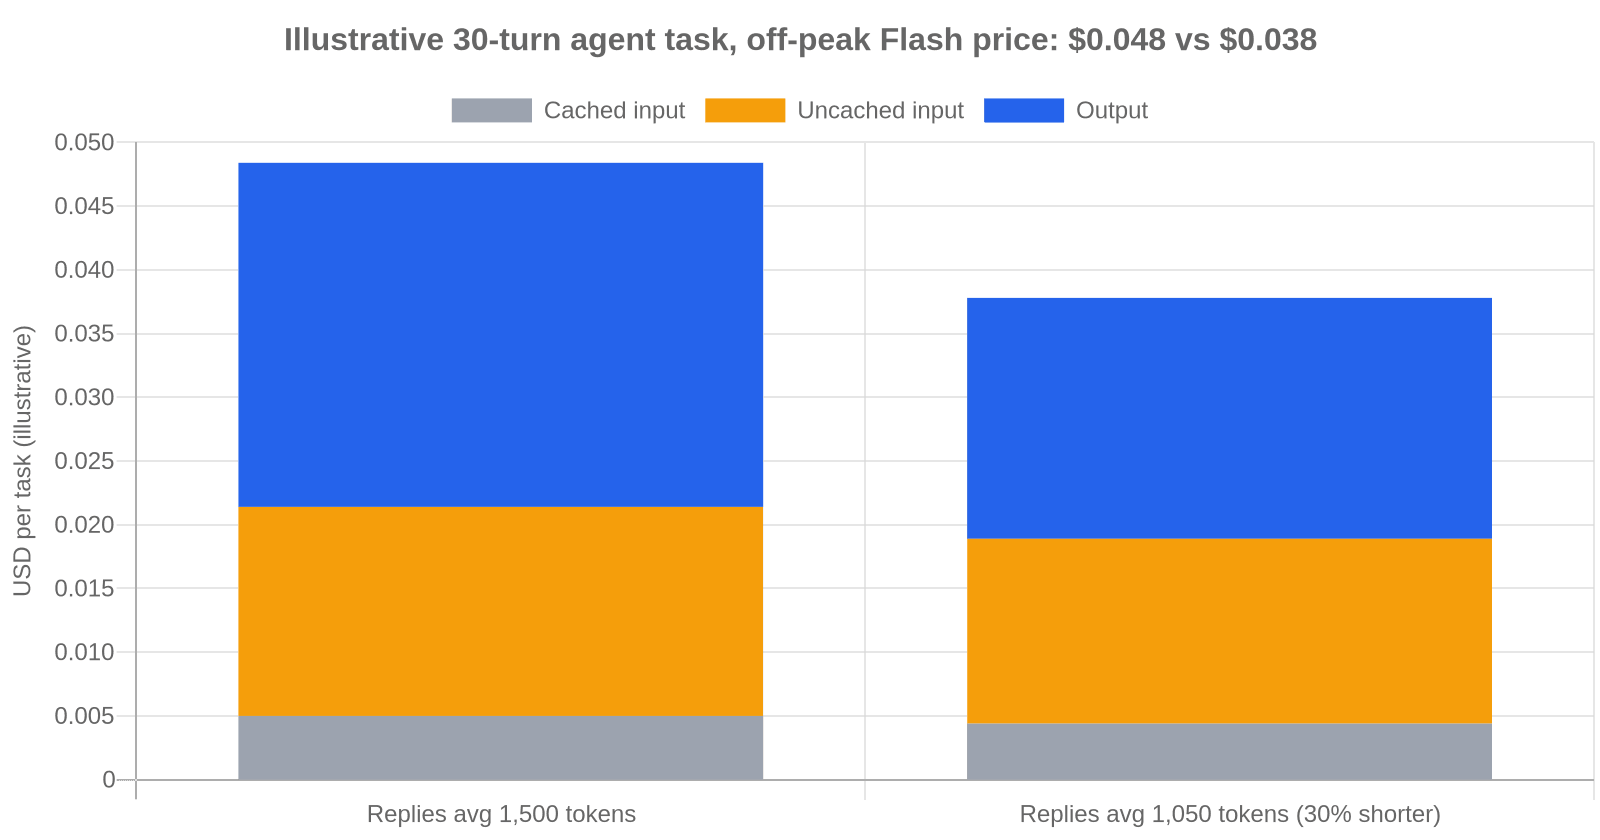
30 轮、每轮回复 1,500 token 时,累计约读取 165 万缓存 token、109,500 未缓存 token,生成 45,000 输出 token,费用约 $0.048。三项占比约为 10%、34%、56%。
回复缩短到 1,050 token,也就是减少 30%,总价降至约 $0.038,节省 21.9%。原因很直接:输入仍然收费,工具结果也没有变短。高峰时两者约为 $0.097 和 $0.076。
同样的 token 用量按 Pro 非高峰价格计算约为 $0.198,是 Flash 的约 4.1 倍。Pro 的缓存输入、未缓存输入、输出单价分别约为 Flash 的 7.3、4.4、3.3 倍。不过真实 Pro 任务可能使用不同轮数,这只能比较价格,不能比较完成任务的效率。
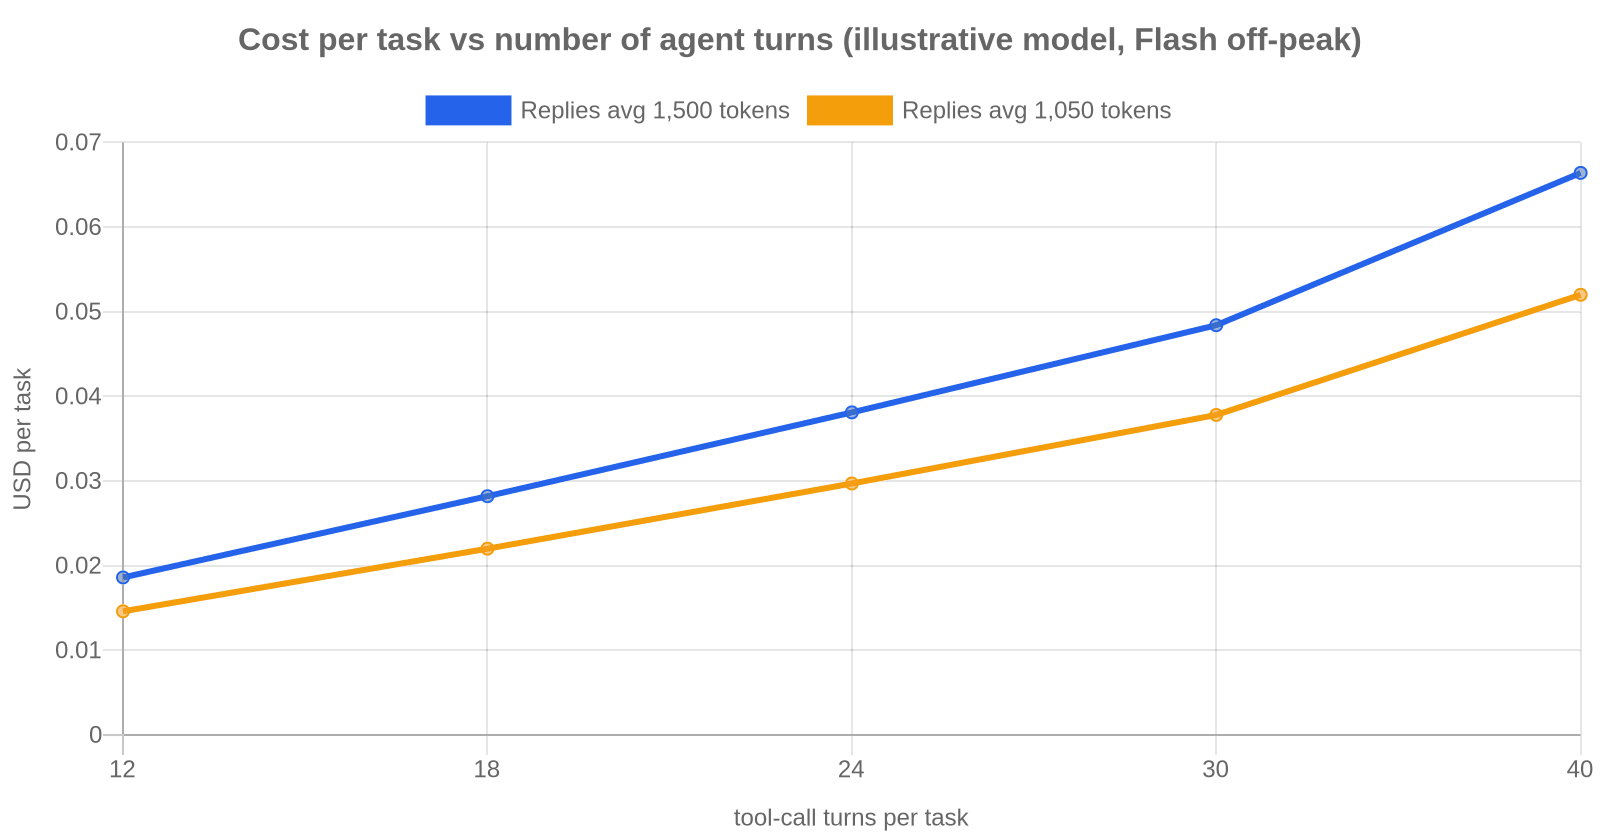
轮数的影响更大。在这个完整重传历史的模型中,缓存读取量随轮数近似平方增长。以 30 轮长回复为基准,改为短回复后,24 轮费用约为基准的 61%,18 轮为 45%,12 轮为 30%。
The Decoder 另有报道,称 DeepSWE 单次成本从旧版约 $0.50 降到不足 $0.20;低成本配置约 $0.10,得分仍超过 72%,竞品约为 $2 至超过 $10。但报道没有提供 token 明细,作者也没有核验。少走步骤可能解释更大的降幅,却还不是被数据证明的结论。
缓存、时段和部署,哪些前提容易漏算
示例假设约 94% 的输入 token 命中缓存。完全没有缓存时,同一任务约贵 6 倍。修改历史工具结果、在提示词顶部加入变化的时间戳、重排消息,都可能破坏前缀复用。
高峰窗口是周一至周五 UTC 01:00 至 04:00、06:00 至 10:00,中国法定节假日除外,每周通常占 168 小时中的 35 小时,即 20.8%。按北京时间理解,就是工作日 09:00 至 12:00、14:00 至 18:00。能等待的批处理移到非高峰,按该规则可节省一半费用。
输出上限也要管。原文称 thinking 默认开启,推理 token 按输出收费;模型卡建议 max_tokens 至少 256K,API 最多允许 384K 输出。宽松上限不能代替任务预算,尤其是允许重试和多轮推理时。
Search 和 Fetch 还是另一类费用。独立 Search API 每 1,000 次成功请求收 $0.75,原文没有给 Fetch 单价。服务端工具免费到 10 月底的说法来自媒体报道,不能直接当作已确认的 11 月账单规则。
自部署也有门槛。仓库为 510.3 GB,平均分到 8 张卡约为每卡 63.8 GB;80 GB 卡只剩约 16.2 GB,141 GB 卡约剩 77 GB,还没有扣除张量复制和引擎开销。
元数据标注 763.2 billion 参数,其中 204.0 billion 为 FP8,557.2 billion 标为 int8。作者按后者实际以 packed 4-bit 存储推算,权重约 487 GB,与仓库体积较接近,也符合配置中的 FP4 专家设置。但打包方式是作者推断,模型卡没有明确解释。
部署还缺一个常被默认存在的部件:它没有 Jinja chat template,需要接入参考 encoding.py 和 deepseek-recipe 库的提示格式。更新日志推荐 DeepSeek Harness 0.2.1-rc.1 或更高版本。
我的判断
我认同原文最有用的评价单位:比较每个成功任务的成本,同时记录成功率。 对修复代码、执行测试这类 Agent 任务,便宜但反复失败的调用,可能让整条任务链更贵。
但这里的 21.9%、6 倍和轮数收益都是模型计算,依赖完整重传历史、固定工具输出、稳定前缀缓存等条件。实际系统如果会压缩上下文、裁剪工具结果或采用不同缓存策略,比例就会变。它们适合解释成本来源,不能直接放进预算承诺。
「新版靠更少步骤省钱」也仍需验证。厂商跑分没有独立复测,媒体成本没有 token 明细,更没有同一批任务、相同配置下的新旧版本对照。对于前端和全栈团队,这足以构成重新评估的理由,还不足以构成全面切换的依据。
能拿来做什么
- 如果项目使用了上述旧模型名称,就重新跑一组已有代码修复和测试任务,核对成功率、输出质量与工具调用次数,确认别名迁移后的实际行为。
- 在 Node Agent 的任务日志里记录轮数、缓存命中与未命中的输入 token、输出 token、耗时和最终是否成功;原文未提供
usage的准确字段名,接入时应核对,别自行猜测。 - 尽量让对话按顺序追加,把变化频繁的信息移出稳定前缀,并分别限制任务总轮数和累计输出预算,避免单次
max_tokens很宽松时失控。 - 将可延迟的批量评测安排到非高峰窗口,再用真实日志比较每个成功任务的费用,把价格收益与模型效率收益分别算清。