八家 Agent 搜索接口价格与计费对照
文章对比截至 2026 年 10 月 27 日八家服务商的 13 档搜索价格,列出的每千次搜索费用为 0.75 至 35 美元。对比涵盖结果数量、页面抓取及免费额度,但未测量模型 token 成本、结果质量或延迟,部分计费尚未生效。
AI 深度解读
给 AI Agent 接入联网搜索,单看每次搜索的报价,最便宜和最贵的方案能差约 47 倍。但这个数字还不能回答选型问题:有的接口只返回摘要,有的已经带正文,有的让模型自己决定何时搜索,后面的读网页和 token 费用也各不相同。
原文比较了 8 家供应商、13 个价格档位,结论是独立搜索 API 通常更省请求费,模型内置搜索则省集成工作。不过,这是一份截至 2026 年 10 月 27 日的标价快照,没有测试搜索质量和延迟。它适合拿来拆预算,不能直接当作效果排行榜。
47 倍价差,买到的是同一种搜索吗
原文把产品分成两组:DeepSeek、Perplexity、Exa、Brave、Tavily 提供独立搜索 API;OpenAI、Anthropic、Google Gemini 把搜索工具集成在模型 API 内。
13 档标价如下,均不包含模型 token 费用:
| 产品与档位 | 每千次标价 |
|---|---|
| DeepSeek Search | $0.75 |
| Perplexity Search fast | $1 |
| Exa lite / instant | $4 |
| Brave Search | $5 |
| Perplexity Search standard | $5 |
| Exa auto / fast | $7 |
| Tavily basic | $8 |
| OpenAI web search | $10 |
| Anthropic web search | $10 |
| Gemini 3 及更新模型 grounding | $14 |
| Tavily advanced | $16 |
| OpenAI web search preview,非推理模型 | $25 |
| Gemini 2.5 grounding | $35 |
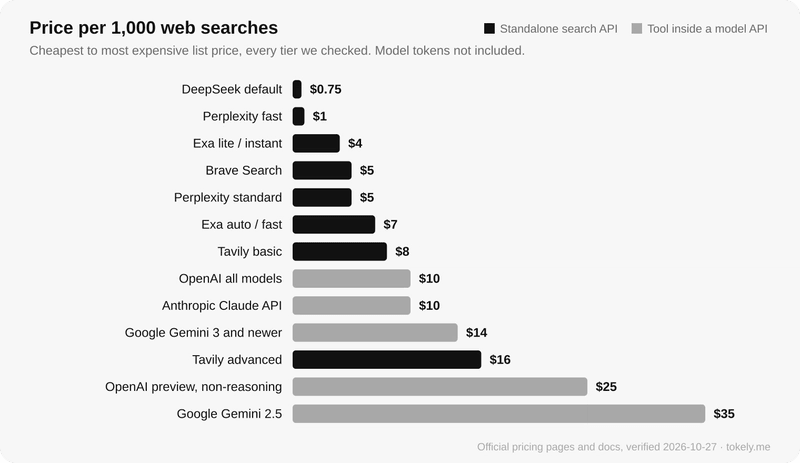
最高与最低价格相除是 46.7,约为 47 倍。但 Gemini 2.5 的计费单位是每千次 grounded prompts,即使用搜索依据生成回答的提示请求,并不能直接认定它和一次独立搜索调用做了相同工作。
还有一个时间前提:DeepSeek 的按请求计费从北京时间 2026 年 11 月 1 日 00:00 开始,只对成功请求收费。在此之前,经 DeepSeek Harness、Claude Code 或 Codex 调用仍然免费。原文比较的是即将生效的生产标价。
作者选取五家独立 API 的默认档位,价格分别为 $0.75、$5、$5、$7、$8,中位数是 $5。OpenAI 和 Anthropic 的 $10 是它的 2 倍,Gemini 3 的 $14 是 2.8 倍;相对 DeepSeek,则分别约为 13.3 倍和 18.7 倍。
作者称之为 grounding premium,可以理解成让模型自行搜索、利用搜索依据生成回答所付的集成溢价。开发者少维护一个搜索依赖,也少写一段调用编排。
这部分便利有明确的计费边界。OpenAI 通常按模型常规费率收取搜索内容 token,非推理模型的 preview 工具例外,内容 token 免费。Anthropic 把搜索结果算作输入 token,后续对话再次携带这些结果也会计费;其引用始终开启,引用中的文本、标题和 URL 字段不计 token。Anthropic 每次搜索计一次工具使用,与返回结果数无关,搜索出错不收费。
真正该比较的是一次任务要花多少钱
Agent 经常需要先搜索,再读取多个结果页。搜索请求便宜,不代表完成整项任务也便宜。
原文设定了一个统一工作量:每次查找包含一次搜索、三次页面读取。每千次查找的工具费变成:
| 方案 | 搜索与读取费用 |
|---|---|
| DeepSeek Search + Fetch | $3.00 |
| Perplexity Search standard | $5.00 |
| Exa lite + 正文读取 | $7.00 |
| Exa auto + 正文读取 | $10.00 |
| Anthropic web search + web fetch | $10.00 |
| Tavily basic + Extract | $12.80 |
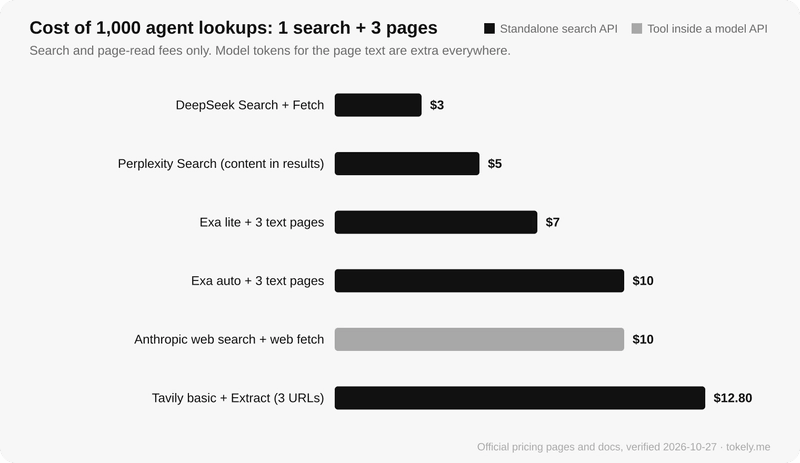
差别来自正文如何交付。DeepSeek 搜索和 Fetch 都是每千次 $0.75,因此总额是 $0.75 加三份 $0.75。Perplexity 的结果已经包含提取的页面文本,受 max_tokens_per_page 限制,不另算三次抓取。
Exa 正文读取每千页 $1,lite 和 auto 分别在搜索费上加 $3。Anthropic web fetch 不额外收工具费,但正文仍计输入 token;其文档估算,一个平均 10 kB 的网页约为 2,500 tokens,三页就是约 7,500 tokens,尚未包含其他上下文。
Tavily basic 每次消耗一个 credit,单价 $0.008;advanced 消耗两个。Extract 每五个成功 URL 收一个 credit,折合每千页 $1.60。不过,三个 URL 一批可能触发取整,$12.80 不能当作每种调用方式下的精确账单。
Brave 没进入这张表,因为它返回片段,每个结果最多再附五个额外片段,作者没有在定价页找到页面抓取产品。
预算应该按完成一次任务计算,并把工具费和输入 token 分开列。
这也解释了独立 API 的另一项价值:可以先过滤、重排、截断内容,再送进模型。省下的可能不只是搜索费,还有上下文开销。
返回更多结果和免费额度,分别解决什么问题
按请求上限摊薄,DeepSeek 每次最多返回 50 条,每千条结果成本为 $0.015;Perplexity fast 最多 20 条,对应 $0.05;Brave 和 Perplexity standard 都是 20 条,对应 $0.25。
Exa lite 包含 10 条,对应 $0.40,额外结果每千条 $1;Exa auto 包含 10 条,对应 $0.70。Tavily basic 和 advanced 都按 20 条计算,分别为 $0.40、$0.80。
这里原文有一处需要纠正:小标题说 DeepSeek 比「下一家 API」便宜 17 倍,但正文数据中,紧随其后的 Perplexity fast 只贵约 3.3 倍。16.7 倍对应的是 Brave 或 Perplexity standard。
而且,这些数字假设每次都拿满结果。返回条目数不等于有效证据数。DeepSeek 附带 0–3 的 rerank 分数、0–4 的权威等级,以及面向模型的 600–800 字符摘要,但作者没有验证这些字段能否改善回答。Perplexity 单个计费请求还可同时接受最多五个查询,也会影响实际任务成本。
免费额度同样要看用途。Gemini 3 及更新模型共享每月 5,000 次免费搜索;Exa 每月 $10 平台额度,最多覆盖 2,500 次 Lite 搜索;Brave 每月 $5,覆盖 1,000 次;Tavily 每月 1,000 credits,覆盖 1,000 次 basic。
按每月 3,000 次、每天约 100 次查找估算,只有上述 Gemini 额度能覆盖搜索请求量,模型费用仍需另算。作者检查的 DeepSeek、OpenAI、Anthropic 页面没有列出月度免费搜索额度。
吞吐也有区别:Brave Search 是 50 QPS,DeepSeek Search 是 100 QPS,Fetch 是 25 QPS。采用一次搜索配三次读取的流程时,页面读取可能先达到限制。
我的判断
这份比较最有用的地方,是把搜索、页面读取和模型输入拆开。对维护 Node 服务或 Agent 后端的团队,这比只看每千次请求单价更接近真实账单。
但作者没有测延迟、索引覆盖和结果质量,也没有验证哪家能用更少的搜索完成任务。因此,独立 API「每次搜索更便宜」有标价支持,「完成任务更划算」还需要自己的样本测试。内置工具省多少开发和维护成本,也没有对照数据,属于工程经验判断。
统计范围也会影响排名。原文排除了企业合同、批量折扣、税费、专用研究 Agent 和回答端点,还排除了 Tavily 每月 $30 的 Project 方案,其 4,000 credits 折合每千次 basic $7.50,以及 Exa Answer 每千次 $5 的方案。Perplexity fast 和 Exa lite 需要显式选择,不能默认接入后就享受最低档价格。
另外,文章来自提供多模型接入服务的 Tokely,结尾带有产品推广。价格拆解可以参考,推广部分不能替代选型证据。
能拿来做什么
- 给 Node Agent 的日志补上搜索次数、页面读取数、输入 token 和重试次数,按完整任务汇总费用,再与这份标价表核算。
- 为独立搜索 API 和模型内置搜索各接一条最小流程,用相同的真实问题比较答案依据、耗时和总账单,再决定是否承担额外编排工作。
- 使用 Perplexity 时明确设置
max_tokens_per_page;采用独立 API 时先过滤重复和无关结果,控制送进模型的正文长度。 - 做并发抓取时分别限制搜索与 Fetch 的并发量,并按实际读取页数估算吞吐,避免只根据搜索 QPS 设计容量。