让模型规划、编译器生成复杂 SQL
文章指出,复杂 SQL 即使能够执行,也可能在窗口边界、分区键和聚合定义上出错,增加审查与迁移成本。其提出以工作流作为契约,将模型规划与确定性 SQL 生成分离。
AI 深度解读
让 AI 写出能运行的 SQL,和让团队确认 SQL 的逻辑正确,是两回事。SQLazy 给出的办法是:让人或 LLM 先写有结构的计算步骤,再由编译器按固定规则生成 SQL,把业务推理和代码生成拆开。
这套方案值得看,不在于它能少写几行 SQL,而在于它把复杂查询变成了可以逐步检查、预览和审查的流程。不过,编译结果可复现,并不代表业务逻辑已经正确。原文的示例恰好能说明两者的区别。
能运行的 SQL,为什么还是难审查
原文把问题集中在复杂分析查询上:窗口边界、分区键、聚合口径,以及会话划分、时间序列间隙、动态透视等场景。语法通常不是最难的部分,难的是每层计算有没有准确表达需求。
作者引用公开评测称,即使先进模型,在 BIRD-bench 这类基准上的执行准确率也经常徘徊在 60% 左右。但原文没有给出具体模型、评测日期和配置,这个数字只能当作问题背景,不能据此判断当前某个模型的实际水平。
更有说服力的是文中的状态日志案例。表里每行记录某个 ID 在 CreatedAt 时刻的 NewStatus,需求是取出各 ID 在 ConfirmationStarted 之前最近的一条 Closed 记录。
AI 直接生成的查询用了累计窗口计算,再套上多层子查询和重复筛选。作者称它在示例中能正确运行,但审查者仍要从内层往外推:每条记录被分到哪段,哪些 Closed 被留下,最后的 MAX 又作用在哪批数据上。
问题不只是 SQL 长,而是业务步骤藏在了查询结构里。出了错,很难直接定位是分段规则、过滤条件还是聚合范围出了问题;切换数据库时,还得重新检查方言差异。
SQLazy 想固定的,是从计算步骤到 SQL 的生成过程。
它没有消除需求理解的难度,而是把这部分工作单独摆出来,让人有机会检查。
把 Workflow 当契约,具体约束了什么
作者把常见的 Prompt→SQL,拆成 Prompt→Workflow→SQL。
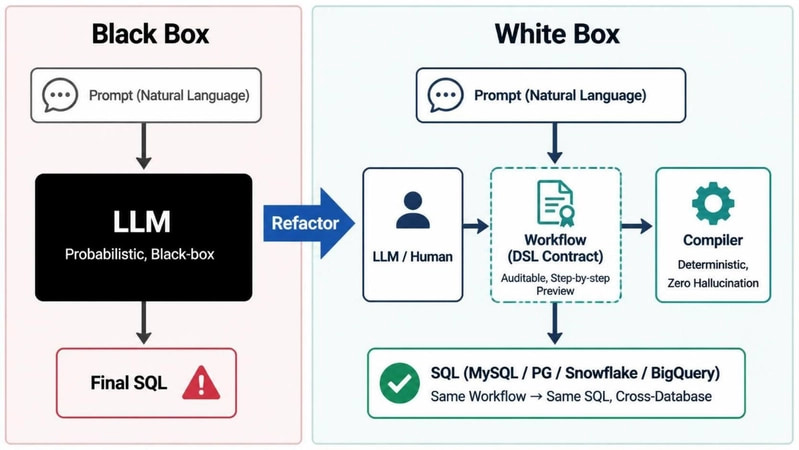
Planner 可以是人,也可以是 LLM,负责把需求拆成步骤。Workflow 使用 DSL,也就是一套受约束的专用语言,承载排序、分段、过滤、聚合等操作。Compiler 再按照预定义规则,将这些操作翻译成目标数据库的 SQL。
这里的 Workflow 不是随意写几句自然语言。它必须有明确结构,能被程序读取和执行,否则编译器仍然需要猜测含义,确定性就无从谈起。
以原文中的操作为例,sort 对应 ORDER BY,filter 对应 WHERE,summarize 对应 GROUP BY 和聚合操作;segment 则封装了累计窗口计算,底层会用到 SUM(CASE WHEN ...) OVER(PARTITION BY)。
这层约束带来三个直接变化。
首先,审查对象变得更贴近业务。评审者可以先判断「按什么分段、保留哪段、如何取最大值」,不用一上来就展开嵌套 SQL。
其次,每个步骤都能执行并预览中间表。分段不符合预期时,直接查看新增的 seg 列,比从最终结果倒推原因更容易。
最后,Workflow 是纯文本,可以进入 Git。修改对应步骤后重新编译,业务流程和生成 SQL 能同步更新,变更也可以 diff、评审和回滚。
作者称,同一 Workflow 可以编译到 MySQL、PostgreSQL、Snowflake 或 BigQuery,切换方言无需修改 Workflow。这个承诺依赖编译器已经覆盖相关操作及方言差异,不能直接理解成任意 SQL 能力都能无损迁移。
四个步骤,怎样取出目标 Closed 记录
原文给出两组日志。ID 为 147 的记录中,Closed 分别出现在 2022-05-28、2022-06-18、2022-06-25 和 2022-08-25,ConfirmationStarted 出现在 2022-07-13;ID 为 1645 的 Closed 出现在 2023-04-29,ConfirmationStarted 出现在 2023-05-08。
预期结果只有两行:147 对应 2022-06-25,1645 对应 2023-04-29。
SQLazy 将计算写成四步。第一步 sort ID, CreatedAt asc,按 ID 和时间排序;第二步 segment condition (NewStatus = "ConfirmationStarted") partition ID as seg,为每个 ID 独立分段;第三步 filter (NewStatus = "Closed" and seg = 1),留下目标区间内的 Closed;第四步 summarize max CreatedAt as CreatedAt; group ID,按 ID 取最新时间。
分段是理解整个例子的关键。seg 从 1 开始,每遇到一条 ConfirmationStarted 就增加,因此 seg=1 表示第一次 ConfirmationStarted 之前的区间。作者建议执行后点击 t2,直接检查 seg 列。
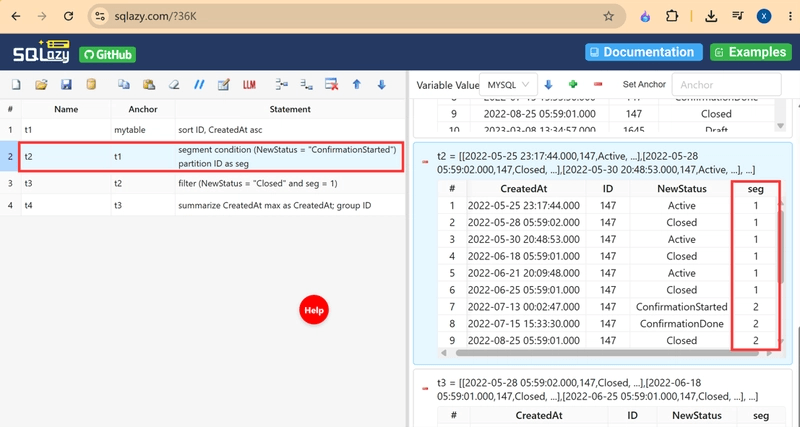
点击 Compile 后,编译器生成下面的 SQL。它解决的是把分段、过滤、聚合这几个已明确的操作,转换为数据库能够执行的查询:
WITH t2 AS (
        SELECT CreatedAt, ID, NewStatus
            , 1 + SUM(CASE
                WHEN (NewStatus = 'ConfirmationStarted') THEN 1
                ELSE 0
            END) OVER (PARTITION BY ID ORDER BY ID ASC, CreatedAt ASC ROWS UNBOUNDED PRECEDING) AS seg
        FROM mytable
    )
SELECT ID, MAX(CreatedAt) AS CreatedAt
FROM (
    SELECT CreatedAt, ID, NewStatus, seg
    FROM t2
    WHERE (NewStatus = 'Closed'
        AND seg = 1)
) t_3
GROUP BY ID
ORDER BY ID
要重点看 AND seg = 1:它决定了取数范围,最终的 MAX 只是在这个范围内找最新记录。
这也暴露了需求中的一个空白。示例里每个 ID 都只有一次 ConfirmationStarted;如果业务要求针对每次 ConfirmationStarted 分别取前一条 Closed,当前流程就不够了。如果某个 ID 从未出现 ConfirmationStarted,它的 Closed 仍可能落在 seg=1 中。相同 CreatedAt 如何确定先后,原文也没有说明。
这些边界不会因为用了编译器自动消失。Workflow 的价值,是让它们更容易被看见和讨论。
我的判断
我认可把规划与生成拆开的方向。对于复杂分析查询,用结构化步骤承载业务意图,比只保存一段 AI 生成的 SQL 更利于协作。中间结果预览也很实用,尤其适合检查分区、边界和聚合范围。
但原文把「没有幻觉」「跨运行和机器结果相同」说得过满。规则编译可以避免生成阶段的随机发挥,Planner 依然可能理解错需求。即使 SQL 文本完全相同,数据、数据库环境和排序条件不同,查询结果也未必相同。
可复现的编译,不能替代对业务语义的验证。
严格追踪生成结果,还需要记录编译器版本、目标方言和配置。原文没有交代这些条件,也没有提供准确率、审查耗时或跨数据库一致性的对照实验,因此收益目前主要是架构推理和单个案例展示。
和直接维护清晰的 CTE、配合查询测试相比,SQLazy 多引入了一层 DSL。只有当这层语言能稳定表达团队的分析逻辑,并显著降低检查成本时,额外学习和工具依赖才划算。作者也承认,简单 CRUD 直接写 SQL 更合适,宏和循环仍在路线图上;它面向复杂分析逻辑,可与 dbt 等流程配合使用。
采用前还要看清开放边界:SQLazy 的语法和示例开源,编译器与 IDE 属于专有组件,并提供免费版本。作者称 IDE 支持本地和私有部署,Playground 在浏览器本地运行,但原文没有展开部署条件和限制。Git 历史能帮助审计,却不足以单独证明满足某种合规要求。
能拿来做什么
- 做 Node 数据报表或分析接口时,可以先让 AI 写出排序、分段、过滤和聚合步骤,再检查中间结果,最后生成 SQL。重点审查每一步的输入范围和边界条件。
- 对状态流转查询,先补齐多次 ConfirmationStarted、缺少 ConfirmationStarted、相同 CreatedAt 等样例,再验证 Workflow。示例跑通只能证明它覆盖了示例。
- 团队若采用这类编译方案,应把 Workflow、生成 SQL、编译器版本和目标方言配置一起纳入评审,方便解释某次变更为何改变了查询结果。
- 简单 CRUD 继续直接写 SQL;复杂分析逻辑可以挑一条现有查询试用,比较步骤是否更易理解、中间结果是否更易排错,再决定是否接入日常流程。