
8.0
热点
AI SCORE
技术实践2026-08-26 08:00
Sentence Transformers多向量嵌入模型微调教程
Hugging Face Blog#HuggingFace#嵌入模型#微调
Editor brief · 编辑速览
Hugging Face官方博客详解如何用Sentence Transformers训练和微调多向量嵌入模型,覆盖对比学习和重排序场景。
微调多向量模型涉及多个组件:模型本身、数据集、损失函数、训练参数、评估器和 Trainer 类。我将逐一介绍这些组件,并配合实用的代码示例,演示如何用它们微调出强大的多向量模型。
最后,在评估部分,我会展示我微调的 mLateOn-medical 模型——在与这篇博客并行的时间内,仅用一块 RTX 3090 训练了 14.5 小时——在我医学检索评估集上的表现,轻松超越了所有我能找到的通用检索模型:稠密的、稀疏的、词式的以及多向量的,无一例外。
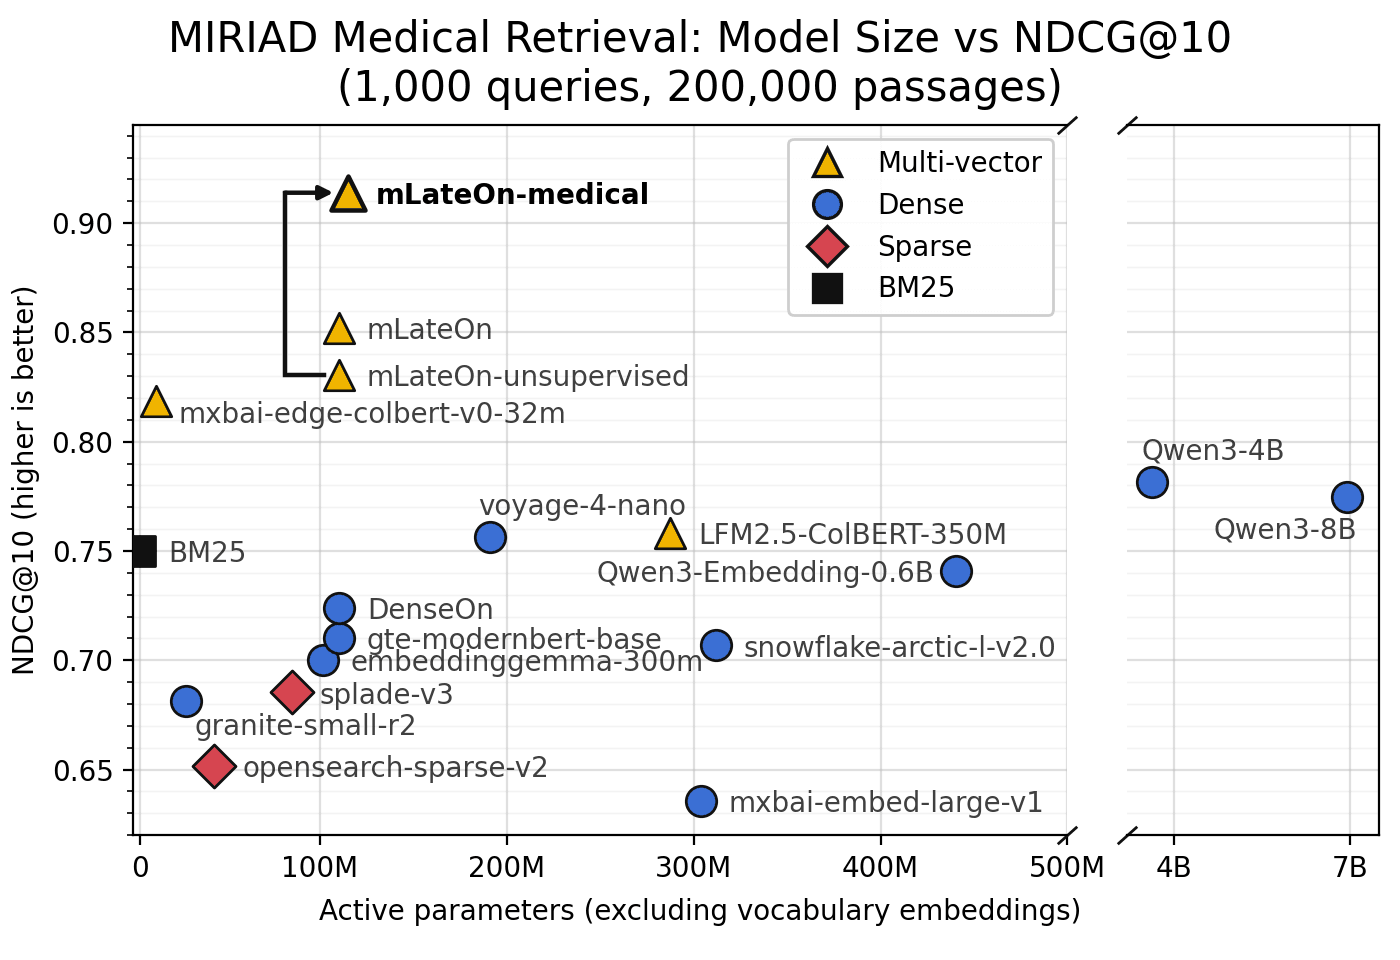
如果你对微调稠密嵌入模型、稀疏嵌入模型或重排序器更感兴趣,不妨阅读我之前的《训练与微调嵌入模型》、《训练与微调稀疏嵌入模型》以及《训练与微调重排序模型》博客文章。
这篇博客聚焦于多向量模型的训练。如果你想了解如何使用它们——从加载、编码到在向量数据库中建立索引——请参阅配套文章《Sentence Transformers 中的多向量(后期交互)嵌入模型》。
微调现有多向量模型 从基础 Transformer 构建 应该选择哪个起点?
数据集 Hugging Face Hub 上的数据 本地数据 数据集格式
Hugging Face Hub 上的数据 本地数据
Trainer 回调函数 多数据集训练
多数据集训练
评估 优化索引
扩展资源 训练示例 文档
稠密嵌入模型将整个文本压缩为一个向量,相似度就是两个这样摘要之间的点积。而多向量模型(也称为后期交互或 ColBERT 风格模型)跳过了这种压缩。它为每个 token 保留一个小型向量,用 MaxSim 算子对查询和文档进行评分:每个查询 token 找到其最佳匹配的文档 token,然后将分数加总。Token 级别的匹配精确保留了单个向量不得不平均掉的细粒度信号,这通常意味着更强的检索能力,代价是索引更大。
配套的《多向量嵌入模型》博客文章详细介绍了架构、编码、评分和索引,所以本节我只做简要说明,直接进入训练部分。

微调多向量模型能显著提升其在特定领域上的检索性能:词汇、查询风格以及相关性概念在网页搜索、法律发现、代码搜索和科学文献综述之间都存在差异。由于查询和文档是逐 token 匹配的,多向量模型能捕捉到单个向量模型往往平均掉的细粒度领域信号,而且即使只有少量域内微调数据,它们也能表现出色。
此外,大多数发布的检索模型都是针对短段落配置的。经典的 ColBERT 检查点将文档截断在 180 或 300 个 token,许多流行的稠密模型截断在 256 或 512 个 token,因为它们的 MS MARCO 风格训练数据很少超过这个长度。如果你的文档很长,这些模型会在评分前静默丢弃每个文档的大部分内容。在我医学评估中(平均 941 个 token 的段落),我测得这种截断会造成高达 0.24 的 NDCG@10 损失,远远超过模型架构之间的任何差异。当你训练自己的模型时,可以配置你的数据所需的文档长度。
LightOn 在代码检索中遇到了同样的情况,通用 LateOn 不够用,于是他们训练了 LateOn-Code。你的领域——无论是医学、法律、金融还是你公司的内部文档——都不会有官方模型。这篇博客文章告诉你如何自己做,在几小时内,用一块消费级 GPU 就能完成。
训练 MultiVectorEncoder 模型涉及以下组件:
让我们逐一深入了解每个组件。
多向量训练给你一个真实的起点选择,而且它的影响比你想象的更大。
如果你想进一步微调一个现有的多向量模型,完全不需要担心架构问题:
from sentence_transformers import MultiVectorEncoder

# 如果内存足够,加载 fp32 格式进行训练是首选
model = MultiVectorEncoder(
    "lightonai/mLateOn-unsupervised",
    model_kwargs={"torch_dtype": "float32"},
    processor_kwargs={"model_max_length": 8192},  # tokenizer 级别的 token 上限
)
检查点自带一套配置:查询和文档标记 token、投影头、评分跳过列表。对于微调,通常你希望保留所有这些,只改变你的数据所要求的部分。首先要检查的是长度配置,因为许多发布的检查点将文档限制在 180 到 512 个 token(参见为何要微调?),而我的医学文档长达 1,400 个 token。mLateOn 系列已经支持骨干网络完整的 8192 token 上下文,但如果你的起始检查点带有截断上限,需要解除它们:
# 让模型读取完整文档,而不是它训练时的截断上限
# 例如 GTE-ModernColBERT-v1 自带 query_length=48 和 document_length=300
model[0].query_length = None
model[0].document_length = None
解除每个任务的截断上限后,截断会回退到 tokenizer 的 model_max_length,这就是为什么我在上面加载时配置了这个限制。
我还做了另一个改动,添加了一个标点符号跳过列表,在文档端评分和存储时排除标点 token。在 4 路消融实验(无/标点/停用词/两者)中,它在质量上小幅胜出,而且在这个数据上将文档索引缩小了 9.6%,白嫖:
import string

# model[2] 是 MultiVectorMask 模块
model[2].skiplist_words = list(string.punctuation)
model[2].resolve_with_tokenizer(model.tokenizer)  # token id 被缓存了,所以修改后需要重新解析
你也可以将 MultiVectorEncoder 指向任何基础 Transformer,它会为你追加一个全新的、随机初始化的 token 级别投影:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("answerdotai/ModernBERT-base", model_kwargs={"torch_dtype": "float32"})
# MultiVectorEncoder(
#   (0): Transformer({..., 'architecture': 'ModernBertModel'})
#   (1): Dense({'in_features': 768, 'out_features': 128, 'bias': False, ...})
#   (2): MultiVectorMask({'skiplist_words': [], 'skiplist_tasks': ['document'], ...})
#   (3): Normalize({...})
# )
这就是经典的 ColBERT 流程:一个产生上下文 token 嵌入的 Transformer、一个将每个 token 投影到 128 维的 token 级别 Dense、一个决定哪些 token 在评分时有效的 MultiVectorMask,以及一个 token 级别 Normalize。投影从随机初始化开始,所以这个模型在训练之前是无用的。有趣的是,这也能与强大的稠密嵌入骨干网络配合使用。阿里巴巴-NLP/gte-modernbert-base 上的新投影在我的实验中距离现有检查点起点仅差 0.03,而那只是投影和 25k 训练对带来的效果。
经典的 ColBERT 分词技巧([MASK] 查询扩展、[Q]/[D] 前缀标记、文档长度截断、标点符号跳过列表)默认全部关闭,且可配置。详见 Creating Custom Models 完整选项。值得一提的是,我在自己的领域微调中测试了四种配置的 [MASK] 查询扩展,均未产生可测量的差异,所以不必执着于这套经典配方。
应该如何选择起点?
我在撰写这篇博客时直接测量了这一点,选取六个起点,在 MIRIAD 的 2.5 万个医学问答-段落对上用相同配方分别训练,然后在包含 5 万段落的语料库上针对 1000 个保留问题进行评估:
结果令我意外,且在两个模型家族中复现。*未经监督的检查点在适应新领域时比已完成的同代模型表现更好,尽管起步更低。*这些检查点位于大规模对比预训练之后、通用检索监督微调之前,因此它们保留了所有后期交互结构,而没有通用调优——领域训练随后需要undo的正是这些通用调优。相比之下,已完成的检查点在所有尝试的学习率下几乎未动甚至退化。
因此,如果喜欢的模型家族发布了预监督检查点,就从这里起步。如果没有,从强检索预训练的骨干网络开始新投影是接近的替代方案。从完全完成的检查点继续是领域适应中最弱的选项,尽管它是最符合直觉的选择。
MultiVectorEncoderTrainer 使用 datasets.Dataset 或 datasets.DatasetDict 实例进行训练和评估。你可以从 Hugging Face Datasets Hub 加载数据,也可以使用本地数据,格式不限(如 CSV、JSON、Parquet、Arrow 或 SQL)。
注意:许多可开箱即用的 Sentence Transformers 公共数据集已在 Hugging Face Hub 上标记了 sentence-transformers,你可以在 https://huggingface.co/datasets?other=sentence-transformers 轻松找到它们。可以浏览这些数据集,找到可能对你的任务、领域或语言有用的现成数据集。
Hugging Face Hub 上的数据
你可以使用 load_dataset 函数从 Hub 上的数据集加载数据:
from datasets import load_dataset

train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train")

print(train_dataset)
"""
Dataset({
    features: ['question', 'passage_text'],
    num_rows: 4467542
})
"""
这是本博客中将用于训练的数据集:MIRIAD 的 440 万个医学问题,每个问题都配有包含其答案的来源段落(平均 941 个 token)。诸如此类的简单(查询,相关段落)对是最容易为自己的领域收集的检索训练数据,而且如你所见,这些已经足够了。
你也可以用 load_dataset 加载常见文件格式的本地数据:
from datasets import load_dataset

dataset = load_dataset("csv", data_files="my_file.csv")
# 或
dataset = load_dataset("json", data_files="my_file.json")
如果你的本地数据需要预处理,可以用 `datasets.Dataset.from_dict 用字典列表初始化数据集:
from datasets import Dataset

queries = []
documents = []
# 打开文件,执行预处理、过滤、清洗等操作
# 然后追加到列表中

dataset = Dataset.from_dict({
    "query": queries,
    "document": documents,
})
重要的是,你的数据集格式必须与损失函数相匹配(或者说选择与数据集格式匹配的损失函数)。验证数据集格式是否适用于某个损失函数涉及两个步骤:
如果你的损失函数根据 Loss Overview 表需要 Label,则你的数据集必须有一列名为 "label" 或 "score"。该列自动作为标签使用。
根据 Loss Overview 表,除 "label" 和 "score" 外的所有列都被视为 Inputs。剩余列的数量必须与你选择的有效输入数量相匹配。这些列的名称无关紧要,顺序才重要。
在此基础上有两个多向量特定约定:
位置查询和文档分配:第一列作为查询嵌入,后续所有列作为文档,无论列名如何。可通过标准 router_mapping 训练参数覆盖每个列的默认分配。
知识蒸馏格式:每个候选文档占一列,即(查询,document_1,...,document_N,scores),其中 scores 是每行的 N 个教师分数列表。对于在独立文本数据集中存储查询和文档 ID 的 KD 数据集(如 lightonai/ms-marco-en-bge),可以使用 resolve_ids 动态解析 ID 为文本。
损失函数量化模型在给定数据批次上的表现,使优化器能够更新模型权重以产生更有利(即更低)的损失值。适合你任务的损失函数取决于你拥有的数据和你的目标。你可以在 Loss Overview 查看完整选项列表。
对于问答或问-段落对的常见情况,主要方法是使用 MultiVectorMultipleNegativesRankingLoss 进行批内负样本训练,批次中每个其他文档都作为每个查询的负样本。更大的批次意味着更多负样本和更强的训练,因此在实践中你需要其 GradCache 变体 CachedMultiVectorMultipleNegativesRankingLoss,它将有效批次大小与 GPU 容纳的批次大小解耦:
from sentence_transformers import MultiVectorEncoder
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

model = MultiVectorEncoder("lightonai/mLateOn-unsupervised", model_kwargs={"torch_dtype": "float32"})

loss = CachedMultiVectorMultipleNegativesRankingLoss(
    model=model,
    mini_batch_size=16,  # 每个 chunk 编码多少文档:控制内存,不影响质量
)
mini_batch_size 参数通过按该大小分块编码文档来控制内存,而有效对比批次大小(我下面的运行中为 128,在我的一系列消融实验中,更大的批次没有带来额外收益)保持自由选择。GradCache 保证无论 chunk 大小如何结果都相同,因此在内存较小的 GPU 上可以调低它,代价只是 wall-clock 时间。当文档长度差异很大时,可以考虑其兄弟参数 mini_batch_num_tokens,它将每个 chunk 打包到总 token 预算而不是文档数量,因此异常长的文档 chunk 不会导致内存激增(我的 mini_batch_size=16 约对应每文档 940 个 token,相当于 mini_batch_num_tokens=15_000)。
一个多向量特定的陷阱是,对比损失默认 scale=1.0,而 dense embedding 对应版本默认为 scale=20.0。20.0 存在是因为余弦相似度是 [-1, 1] 范围内的单一值,范围太窄,无法用于尖锐的 softmax。而 MaxSim 分数是每个查询 token 最佳匹配相似度之和,因此自然范围约为 [0, query_length]:一个 32 token 的查询最高可达 32。因此不要从 dense 训练脚本中复制 scale=20.0,因为那会导致 softmax 饱和并杀死梯度。
对于从更强教师模型蒸馏(这是最强的通用后期交互模型的训练方式),请参阅 MultiVectorDistillKLDivLoss 和 Training Overview 文档中的 Knowledge Distillation 选项卡。
你可以通过 MultiVectorEncoderTrainingArguments 类自定义训练过程。该类允许你调整可能影响训练速度并帮助你理解训练过程中发生的事情的参数。
有关最有用的训练参数更多信息,请查看 Multi-Vector Encoder > Training Overview > Training Arguments。阅读这些内容可以充分利用你的训练。
以下是一个示例,使用了我实际训练运行中的值:
from sentence_transformers import MultiVectorEncoderTrainingArguments
from sentence_transformers.base.sampler import BatchSamplers

```python
args = MultiVectorEncoderTrainingArguments(
    # 必填参数:
    output_dir="models/mLateOn-medical",
    # 可选训练参数:
    num_train_epochs=1,
    per_device_train_batch_size=128,  # 有效的对比批次大小,得益于 GradCache
    per_device_eval_batch_size=16,
    learning_rate=1e-4,
    warmup_steps=0.05,
    prompts={"question": "[Q] ", "passage_text": "[D] "},  # 检查点的标记,按训练列名索引
    fp16=False,  # 如果你的 GPU 支持 FP16则设为 True
    bf16=True,  # 如果你的 GPU 支持 BF16则设为 True
    batch_sampler=BatchSamplers.NO_DUPLICATES,  # 批内负样本受益于无重复
    # 可选跟踪/调试参数:
    eval_strategy="steps",
    eval_steps=0.1,
    save_strategy="steps",
    save_steps=0.05,
    logging_steps=0.01,
    run_name="mLateOn-medical",  # 将用于 Trackio、W&B 等
)
其中几个参数值得特别说明:
prompts:训练不会自动应用模型中存储的提示词,因此需要将其显式映射到训练列上。这里使用检查点的 [Q] 标记对应 question 列,[D] 对应 passage_text 列,保证训练与推理的一致性。
max_length(有意未设置):此参数仅在训练时限制 tokenization 长度,适用于需要比模型完整服务长度更低成本训练的场景。我测量了该捷径在此数据上的代价:以 512 tokens 训练会损失约 0.015 的 NDCG@10,但速度提升约 2 倍,且随着数据量增加这一差距并未缩小,因为模型根本看不到被截断的内容。除非你对速度的需求超过质量,否则不要设置此参数,让训练与推理保持一致。
learning_rate=1e-4:在从 5e-6 到 2e-4 的参数搜索后,这个高于常规的学习率取得了最佳效果。
若想在训练过程中跟踪模型性能,可以向 trainer 传递 eval_dataset 用于评估损失,但具体的检索指标信息量更大。Sentence Transformers 为多向量模型内置了以下评估器:
对于领域微调,来自你自己的保留数据的 MultiVectorInformationRetrievalEvaluator 才是真正有意义的评估器。构建它的一个技巧是语料库要足够难,以便模型之间能够被区分开。在我的例子中,MIRIAD 问题是从各自的源 passage 生成的,这使得检索异常简单。仅用 10k 条黄金 passage 作为语料,几乎所有模型的 NDCG@10 都超过 0.97。如果你的评估也这样饱和,就添加干扰 passage(我使用训练集中去重后的 passage)直到分数分散开来:
from datasets import load_dataset
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator

dataset = load_dataset("tomaarsen/miriad-4.4M-split")

# 黄金标准:1000 个评估问题,每个对应自己的 passage,以 eval 分支的约 10k 条独立 passage 作为初始语料库
corpus = {}
queries = {}
relevant_docs = {}
passage_to_id = {}
for idx, row in enumerate(dataset["eval"]):
    if row["passage_text"] not in passage_to_id:
        passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
        corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
    if idx < 1_000:
        queries[f"q{idx}"] = row["question"]
        relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}

# 干扰项:独特的训练集 passage,使检索环境更真实
seen = set(passage_to_id)
for row in dataset["train"]:
    if len(corpus) >= 200_000:
        break
    if row["passage_text"] not in seen:
        seen.add(row["passage_text"])
        corpus[f"d{len(corpus)}"] = row["passage_text"]

evaluator = MultiVectorInformationRetrievalEvaluator(
    queries=queries,
    corpus=corpus,
    relevant_docs=relevant_docs,
    name="miriad-dev",
    batch_size=16,
)
# results = evaluator(model)
MultiVectorEncoderTrainer 是将所有前述组件整合在一起的地方。以下是训练 multi-vector-encoder/mLateOn-medical(即开篇提到的模型)的完整脚本:
import logging
import string
import traceback

from datasets import load_dataset

from sentence_transformers import (
    MultiVectorEncoder,
    MultiVectorEncoderModelCardData,
    MultiVectorEncoderTrainer,
    MultiVectorEncoderTrainingArguments,
)
from sentence_transformers.base.sampler import BatchSamplers
from sentence_transformers.multi_vector_encoder.evaluation import MultiVectorInformationRetrievalEvaluator
from sentence_transformers.multi_vector_encoder.losses import CachedMultiVectorMultipleNegativesRankingLoss

logging.basicConfig(format="%(asctime)s - %(message)s", datefmt="%Y-%m-%d %H:%M:%S", level=logging.INFO)

def main():
    # 1. 加载起始检查点:经过对比预训练,尚未经过监督微调
    # 如果内存足够,加载 fp32 是训练时的首选
    model = MultiVectorEncoder(
        "lightonai/mLateOn-unsupervised",
        model_kwargs={"torch_dtype": "float32"},
        processor_kwargs={"model_max_length": 8192},
        model_card_data=MultiVectorEncoderModelCardData(
            language="en",
            license="apache-2.0",
            model_name="mLateOn finetuned on MIRIAD medical retrieval",
        ),
    )

    # 2. 解除每个任务的长度限制,使训练和推理都能看到完整的医学 passage
    model[0].query_length = None
    model[0].document_length = None

    # 3. 打分时跳过标点符号 token:小小的质量提升,索引体积缩小 9.6%
    model[2].skiplist_words = list(string.punctuation)
    model[2].resolve_with_tokenizer(model.tokenizer)

    # 4. 加载 100 万对医学问答 passage
    train_dataset = load_dataset("tomaarsen/miriad-4.4M-split", split="train").select(range(1_000_000))

    # 5. 批内负样本与 GradCache:大有效批次,内存受限的分块
    loss = CachedMultiVectorMultipleNegativesRankingLoss(model=model, mini_batch_size=16)

    # 6. 轻量开发评估器用于观察训练进度:500 个保留问题
    # 对应 eval 分支的约 10k 条独立 passage。完整的 200k 协议在之后运行。
    eval_split = load_dataset("tomaarsen/miriad-4.4M-split", split="eval")
    corpus, queries, relevant_docs, passage_to_id = {}, {}, {}, {}
    for idx, row in enumerate(eval_split):
        if row["passage_text"] not in passage_to_id:
            passage_to_id[row["passage_text"]] = f"p{len(passage_to_id)}"
            corpus[passage_to_id[row["passage_text"]]] = row["passage_text"]
        if idx < 500:
            queries[f"q{idx}"] = row["question"]
            relevant_docs[f"q{idx}"] = {passage_to_id[row["passage_text"]]}
    dev_evaluator = MultiVectorInformationRetrievalEvaluator(
        queries=queries, co