RAG 单项优化收益,为何组合后缩水
文章引用一项 RAG 研究:三种检索优化的单项收益相加为 46.6%,组合后 NDCG@10 实际仅提升 17.2%。文中还指出,HyDE 的检索指标收益伴随首跳延迟翻倍,强调同时评估组件交互、延迟与成本。
AI 深度解读
RAG 流水线里,单独有效的组件,组合起来未必同样划算。作者解读的一项研究发现:三项检索优化单测时,预计合计提升 46.6%,真正组合后只提升了 17.2%。组件照常增加延迟和成本,预期收益却没有全部兑现。
这篇最值得程序员带走的,是一套评估思路:别把消融实验的收益直接相加,也别拿检索排名变好,代替回答更有依据。要不要增加一个阶段,最终得看完整流水线在自己语料上的表现。
为什么三个有效组件,组合后少了六成收益
研究使用 lasagna 框架,考察八个可配置阶段。它通过 D-optimal 设计选出 167 种配置,在八个基准上测试,语料规模覆盖 5K 到 200K 文档;另外增加了 24 项针对性实验,包含 138 种非因子消融配置。
D-optimal 可以理解为:不把所有配置组合跑遍,而是挑选一部分,让研究者仍能估计各因素的影响。
最醒目的结果来自三项优化:cross-encoder 重排、关闭 MMR,以及文档感知前缀。以 NDCG@10 为 0.412 的 default_standard 为基线,三者单独实验的收益相加,预计提升 46.6%;采用这些组件的 balanced 流水线,实际只提升 17.2%,比预测少了 63%。
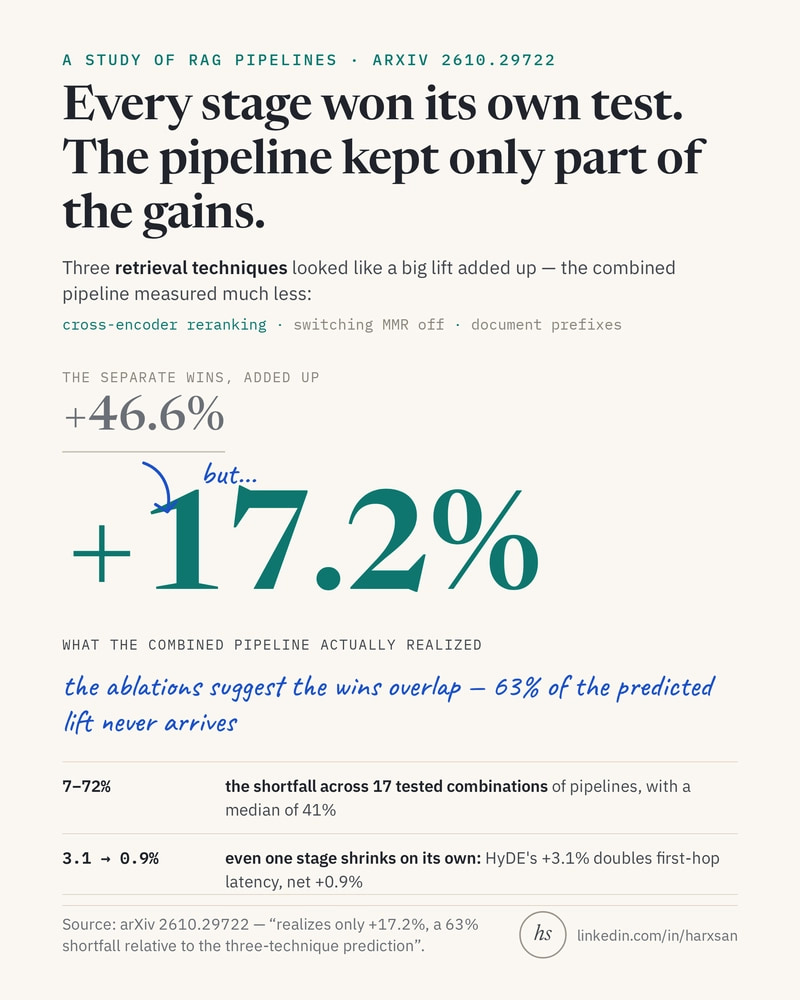
这里的 63% 指的是相对于预测收益的缺口,不是检索质量下降了 63%。完整流水线仍有提升,只是远低于单项收益之和。
作者给出的解释是功能重叠:重排已经承担了一部分筛选作用,关闭 MMR 所能额外带来的改善就缩小了。MMR 通常用于兼顾相关性与结果多样性,但这些组件并不是互不影响的独立开关。
这也不是单个配置的偶然表现。五项单测收益为正的检索技术全部加入后,缺口扩大到 72%;17 种组合的缺口介于 7% 到 72%,中位数为 41%。
单项实验能证明组件在某个条件下有效,不能证明它加入现有流水线后仍有同样价值。
生成器也会改变收益空间。研究发现,更强的生成器对轻量流水线帮助更大,对重型流水线帮助更小。组件是否值得保留,要连同生成模型一起评估。
检索排名变好,为什么回答未必更可靠
研究用 NDCG@10 衡量检索质量,主要看前十条结果是否相关、排序是否合理;用 faithfulness 衡量回答中的论断是否得到检索上下文支持。
这两件事相关,却不是同一个目标。
生成评估采用 RAGAS v0.4,由 GPT-5.1 判断 faithfulness 和 answer relevance,同时报告 exact match、token-level F1、p50/p95 延迟及单次查询成本。所有配置的答案也由 GPT-5.1 生成。
结果是:在匹配配置之间,检索质量与 faithfulness 的合并 Pearson r 只有 -0.01,p = 0.91。在这组实验里,检索分数的改善几乎不能用来预测回答是否更有依据。
各阶段的影响也明显分开。检索侧关联最大的是 embedding、enrichment 和 reranking,η² 分别为 0.164、0.144、0.090;faithfulness 侧则是 query augmentation 和 agentic gating,分别为 0.224、0.217,embedding 与 enrichment 各自都低于 0.02。
η² 表示某个因素与指标波动关联的份额。研究特别说明,这些值未经调整,只用于探索性筛选;由于设计不平衡、因素共享方差,不能相加。
性能账也要单算。HyDE 让 NDCG@10 提升 3.1%,但首跳延迟翻倍,延迟调整后的收益只剩 0.9%。如果只展示质量分数,就会漏掉每次请求都要支付的等待时间。
流水线该多重,要看语料规模和任务
在这项研究中,standard 在 5K、15K 文档时领先,balanced 从 25K 开始领先。到 200K 时,balanced 的 NDCG@10 相对高出 13.7%。
正文给出的显著性为 p = 0.003,附录使用 Welch's t 得到 p = 0.004。两者都支持差异显著,但报告口径没有完全统一。25K 和 100K 的差距方向一致,统计功效却不足,不能把 25K 当成通用切换阈值。
更复杂也未必更好。在两个 agentic 配置中,balanced 比 max-reliable 的 NDCG@10 高 4.5%,faithfulness 只差 0.005,平均响应时间还低约 13%;附录的精确值为 13.5%。
单组件结果同样提醒人别迷信默认选择:MMR 平均让 NDCG@10 相对下降 3.6%;2019 年的 MS-MARCO MiniLM-L6 cross-encoder 排在四个近期重排器之前。作者推测,旧模型的训练与这些聚焦领域更匹配,但没有证明这一机制。
此外,20 种配置中的 chunker 选择带来 0.126 的 NDCG@10 跨度,相对差异达到 36%。切块这种基础处理,影响可能比不少新增阶段更大。
我的判断
我认可作者的工程建议:先验证完整组合,再决定哪些阶段值得付费。它比「某组件单测赢了就加入」更贴近实际请求经过的路径。
但标题中的巨大收益缺口,不能直接当成「强交互效应已被正式证明」。研究预先声明的主要交互假设 H1 没有达到判定标准。后续预先指定的 query augmentation × agentic gate 测试虽然显著,p = 0.007,partial η² 却只有 0.033,低于研究设定的 5% 门槛。20 种组合中有 10 种偏离可加预测至少两个百分点,也不改变这个判定。
还要保留适用范围。基准来自生物医学、金融、科学、论证和 Wikipedia 多跳问答五类领域,扩容干扰文档也来自这些领域,广泛混合语料和超过 200K 的索引没有测过。
faithfulness 也受裁判影响。第二位裁判与 GPT-5.1 的一致性只有 Pearson r = 0.44、Cohen's κ = 0.35,答案长度还会影响原始分数。设计矩阵、逐查询分数和分析脚本未随公开版本发布,需要向作者索取;假设虽预先声明,却没有第三方预注册。
因此,这些结果是有实验支撑的案例证据,不能直接变成通用配置处方。尤其是「旧重排器更合适」「关闭 MMR 更好」,都需要自己的对照实验。
能拿来做什么
- 给现有 RAG 做完整流水线删减实验。逐个移除重排、查询增强等阶段,比较实际增量收益,并记录 p50/p95 延迟和单次查询成本。
- 给 Node 知识库或代码问答服务分别建立检索集和回答评估集。前者检查相关文档能否排进前十,后者检查回答中的论断有没有上下文依据。
- 升级生成模型后,重新评估轻量配置。强模型可能压缩复杂流水线的额外收益,旧配置没有必要自动继承。
- 增加新阶段之前,先对照切块策略和现有重排器。原文显示这些基础选择影响很大,但具体选谁,应由自己的语料和查询决定。