推理只需百毫秒,接口为何仍然慢
文章以每批模型执行耗时 100 毫秒为假设,分析请求排队和等待凑批如何影响接口延迟。设计推演围绕批次发车条件、工作进程数量及请求接纳边界展开,并区分完整执行耗时与首 token 延迟。
AI 深度解读
模型跑完一个批次只要 100 ms,API 为什么还是慢?这道据称来自 Anthropic 的面试题,考的是模型执行前后的等待:什么时候发车、需要多少 worker、什么时候必须拒绝请求。作者的结论很明确:计算快,只能解决延迟账单中的一部分。
这份推演值得读,因为它把批处理的吞吐收益和用户等待放到了同一条时间线上。不过,文中的容量数字来自简化假设,并非 Anthropic 生产系统数据,也没有压测证明它能达到某个延迟目标。
100 ms 的计算,为什么撑不起 100 ms 的 API
先确定秒表从哪里开始计时。作者假设,100 ms 覆盖一个批次的完整模型执行,既不是首个 token 的耗时,也不是客户端往返时间。
其他条件也要一起带上:只有一个模型版本,每批最多 32 个请求,每个 worker 同时执行一个批次,返回完整响应,不做流式输出。支持范围内,无论批次装了多少请求,计算时间都固定为 100 ms。
这些是题目条件,不能直接搬到真实推理服务里。
作者给出了一份暂定的 200 ms 端到端预算:入站网络和 API 处理占 20 ms,模型执行占 100 ms,结果返回占 20 ms,剩下 60 ms 留给等待。
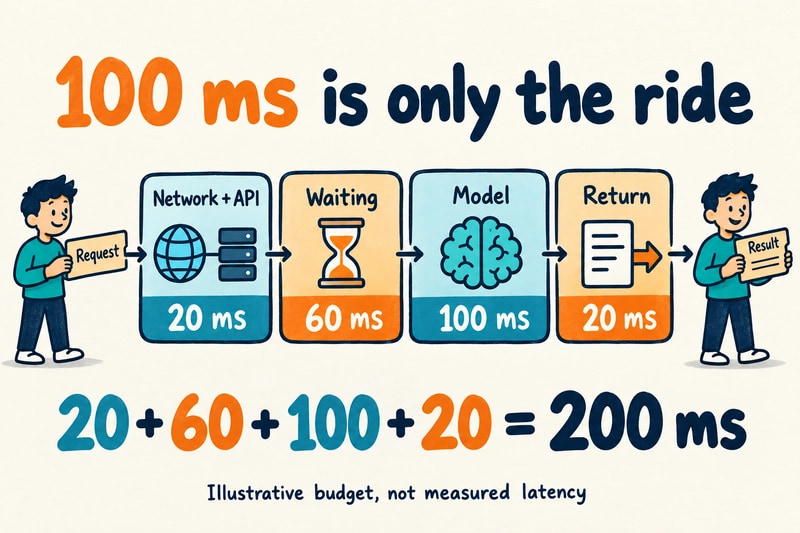
凑批等待和资源排队,共用这 60 ms。
前者是主动等更多请求,以提高批次利用率;后者是 worker 全忙,只能排队。它们不能各领一份预算。
这张账单也不能证明 p99 达标。网络波动、服务开销和突发流量都还没有测。如果要求端到端 100 ms,而计算本身已经占满 100 ms,就应该先指出约束冲突。
批次没装满,也必须有出发时间
只在凑满 32 个请求后执行,低流量时就会出现尴尬场面:GPU 空着,请求却一直等。
作者用更小的例子解释调度规则:批次上限为 4,主动凑批最多等 10 ms,worker 初始空闲。A 在 0 ms 到达,B 在 7 ms 到达,计时仍从 A 到达时开始。到 10 ms,两者一起执行,110 ms 完成。A 在这一段服务里经历了 110 ms,B 经历了 103 ms。
如果 4 个请求都在 0 ms 到达,就立即执行,100 ms 完成,无须等定时器。
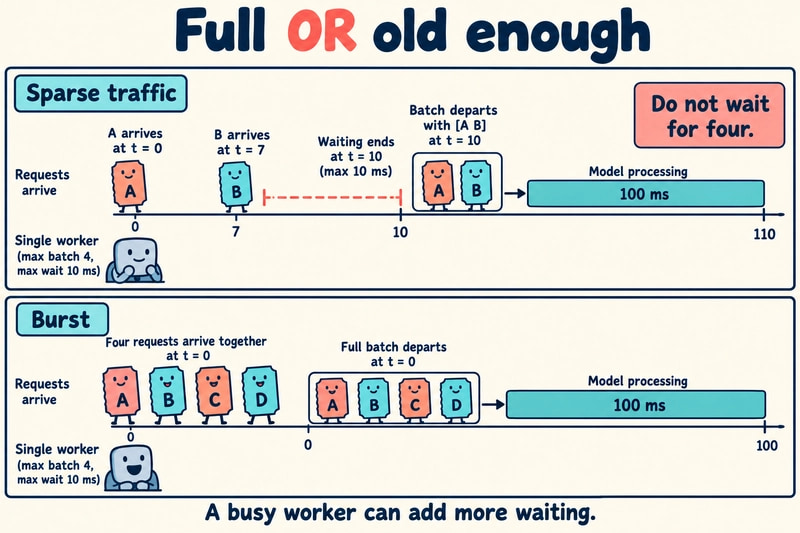
调度条件可以归纳为:兼容的 worker 空闲时,只要批次已满、最老请求达到凑批时限,或者继续等待会威胁截止时间,就应派发。
关键限制是,10 ms 定时器只能约束主动凑批,不能凭空提供算力。
假设唯一的 worker 在 0 ms 开始执行一批请求,E 在 1 ms 到达。E 最早到 100 ms 才能开始,200 ms 才能完成,计算前已经等了 99 ms。如果 E 的绝对截止时间是 150 ms,即使 worker 一空闲就执行,也来不及。
因此,worker 忙碌期间必须保留最老请求的到达时间。资源恢复后,已经等够的半满批次应立即发出,不能重新开始一个 10 ms 定时器。作者提到 NVIDIA Triton 支持配置批处理延迟和队列策略,但这里的 10 ms 只是教学取值。
四个 worker 算得过来,为什么仍然可能超时
在固定计算时间的假设下,一个 worker 每秒执行 10 批。每批装满 32 个请求,理想吞吐就是 320 请求/秒。
面对 1,000 请求/秒的持续流量,算术上的最低配置是 4 个 worker。3 个最多处理 960 请求/秒,队列会持续增长;4 个提供 1,280 请求/秒的理想容量,负载约为 78%;5 个提供 1,600 请求/秒,负载为 62.5%。
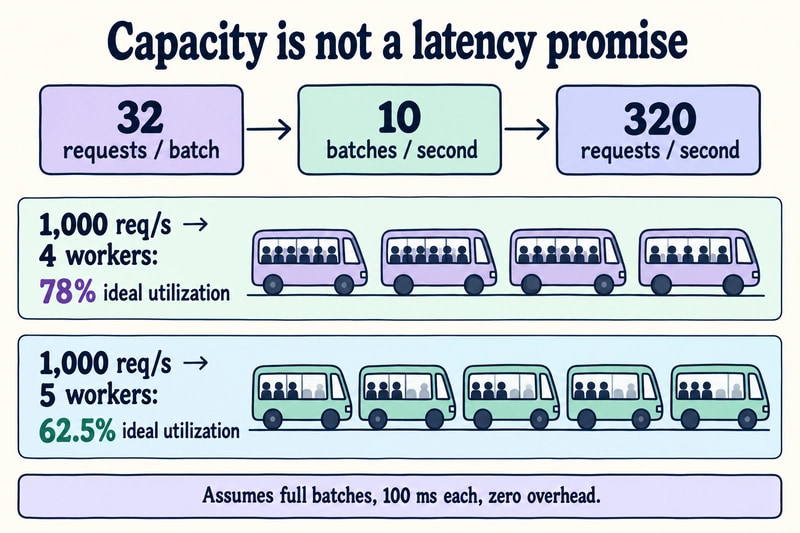
这些数字假设每批都满、没有额外开销、没有故障。平均批次如果只有 16 个请求,同样持续忙碌的 worker,每秒就只能处理 160 个请求。
吞吐算得过来,只说明容量有希望,不能保证等待时间。
作者把 5 个 worker 定位为待测配置,而非标准答案。实际需要观察批次大小、队列中最老请求的年龄、接收和拒绝流量,以及端到端延迟分位数。
扩容也不能只看 GPU 利用率,还要看积压工作和截止时间压力。如果模型加载很慢,就需要保留预热容量。截止时间之后才准备好的 worker,救不了当前请求。
这里有个持续存在的取舍:提前发送小批次能减少凑批等待,却可能降低吞吐;坚持等满能提高批次利用率,却会增加等待。具体怎么选,取决于真实流量和延迟要求。
接收请求之后,系统究竟承诺了什么
作者给出的最小链路是:客户端 → API frontend → 按模型版本划分的有界队列 → scheduler → model worker,结果再经 frontend 返回原调用方。
入站时要验证输入大小和支持的设置、认证调用方,并附上 request ID、租户身份、到达时间、截止时间和回复位置。frontend 用 request ID 保存等待连接或 future,scheduler 不必持有 HTTP 连接。
结果需要同时携带 request ID 和 attempt identifier。重试、取消、过滤都可能改变批次成员,依赖「批次第几个结果」路由很脆弱。请求只能完成一次,旧尝试和迟到结果应丢弃。多模型版本要分兼容队列,共享容量前也要有租户配额或公平调度。
接下来才是可靠性承诺。同步服务可以明确允许 frontend 崩溃导致连接失败,由客户端重试;如果已接收任务必须存活,就还需要持久请求状态、结果存储,以及重连或轮询协议。一个持久队列恢复不了已经消失的连接。
队列还要同时限制请求数和内存,过期任务及时清除,超载尽早拒绝。重试使用共享预算,以及带随机抖动的退避,避免客户端同时回来挤兑服务。
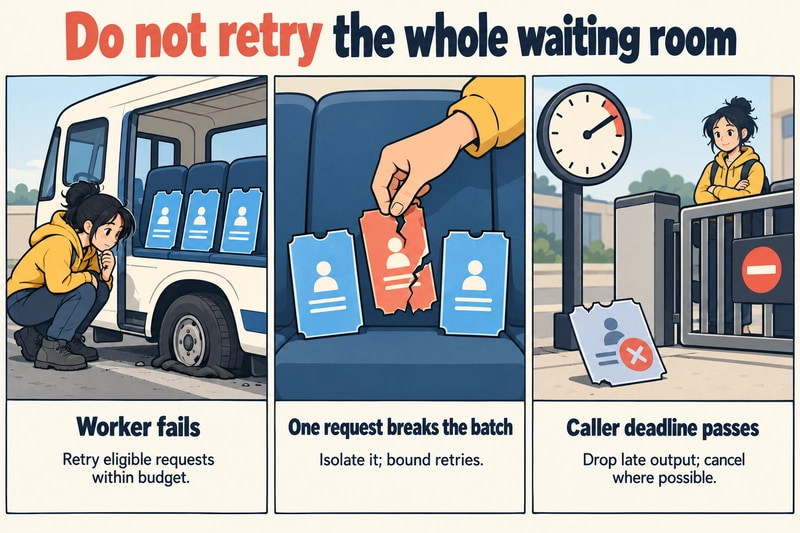
worker 中途故障,只重试仍在截止时间和尝试预算内的未完成请求;反复拖垮批次的请求,要验证、隔离或拆批排查。任务在 worker 间迁移时,可以用租约等机制追踪归属,并阻止旧尝试完成同一请求。
响应去重也不等于计算只执行一次。模糊故障后,推理可能重复执行;如果客户端要求重试返回原结果,还需要租户范围的幂等记录、请求指纹和已保存结果,重新生成未必一致。
最后才能放开 100 ms 假设。真实生成任务的输入、输出长度不同,要考虑 token 和内存预算、模型设置兼容性,以及交互和批量任务的分流。vLLM 的 continuous batching 可以在解码步骤间调度活跃序列、补入新任务,但不会让任意生成都在 100 ms 内完成。流式服务也应分别测首 token、token 间隔和完整完成时间。
我的判断
我认同作者先画请求时间线,再画架构的顺序。它能逼出两个经常被省略的问题:队列允许请求等多久,接收之后又承诺什么。
但它是一份有明确假设的设计推演,没有给出实际压测,也没有比较不同凑批策略、4 个与 5 个 worker 的尾延迟。因此,具体配置仍是经验性的候选方案,不能替它背书。所谓 Anthropic 面试题,也应保留「据称」这个限定。
固定窗口批处理适合解释基础矛盾;真实生成服务可以考虑 continuous batching,但代价是工作量估算和调度更复杂。两者不能只凭「支持动态加入请求」就判断优劣,还要看请求长度、资源预算和用户体验目标。
能拿来做什么
- 给 Node 推理网关拆分延迟指标,分别记录凑批、排队、模型执行和结果返回时间,再用端到端分位数检查用户实际体验。
- 实现批处理队列时,同时处理满批、最老请求超时和截止时间,并用 A 在 0 ms、B 在 7 ms,以及 E 在 1 ms 到达的时间线检查调度逻辑。
- 为同步 AI 接口写清过载、断连和重试语义,限制队列长度与内存,并通过 request ID 和尝试标识拦住迟到结果。
- 做流式 AI 页面时,分别观察首 token、token 间隔和完整回答耗时,避免只凭「很快开始出字」判断响应速度。