在 Kubernetes 上为 Agent 构建分层沙箱
文章讨论 AI Agent 在 Kubernetes 上运行代码时的五层沙箱防护。核心风险是自主 Agent 会执行未经人工审查的代码,包括由模型选择安装的软件。
AI 深度解读
AI agent 一旦能自主执行代码,就会运行没人审查过的脚本、安装模型挑选的依赖。在共享 Kubernetes 集群里,风险可能从一个任务扩散到宿主机,甚至波及其他业务。
这篇来自 The New Stack 的文章给出的结论是:运行时隔离只是起点,还要把节点配置、访问权限、Pod 调度和会话生命周期一起管起来。它适合准备把 AI 编程任务搬上集群的团队,也提醒我们:给 agent 套上容器,距离安全运行还有几层工程要补。
先决定:你要把风险挡在哪一层
普通容器通过 Linux namespaces 隔离进程、文件系统和网络视图,通过 cgroups 限制资源,但仍共享宿主机内核。即使用 Seccomp 限制系统调用,获准调用的接口也可能触发内核漏洞。
容器能限制 agent 看见什么,却不能自动消除共享内核的风险。
作者把运行时分成三档,区别在于代码最终会接触哪个内核。
runc 直接使用宿主机内核,文章将它描述为性能最好的选择。代价是隔离边界仍然建立在共享内核上,适合对这条边界已有充分信任的任务。
gVisor 在用户态提供应用内核 Sentry,由它处理工作负载的系统调用,再通过较小的接口接触宿主机。它不用启动完整的 guest Linux kernel,因此启动快、部署密度高;文件访问则由独立的 Gofer 进程协调。
问题在兼容性。Sentry 只实现 Linux 接口的一个子集,agent 如果临时选择了依赖特定内核能力的工具,可能运行到一半才碰壁。
Kata Containers 给每个 Pod 一台轻量虚拟机,配备独立的 guest kernel,以硬件虚拟化建立边界。作者认为,包管理器、编译器、嵌套构建和无头浏览器这些组合复杂的任务,更需要完整 Linux 环境,避免系统调用模拟限制 agent 的行为。
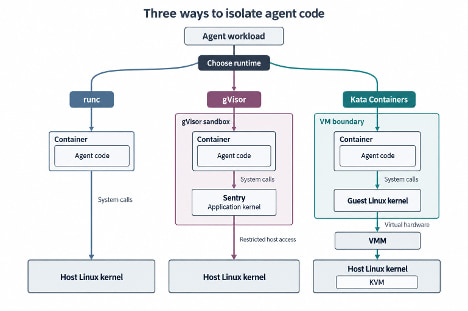
这与前端任务并不遥远。一次安装依赖、构建项目、启动无头浏览器的自动化流程,就可能跨过多个工具的运行要求。不过,原文没有提供三种运行时的性能测试,也没有列出兼容性失败案例,不能据此认定某一档对所有任务都更划算。
独立内核的账,必须算到节点和调度里
选好 Kata,不代表在 Pod 上填个名字就能运行。节点必须具备对应能力。
在文章讨论的 KVM 配置下,节点需要 Kata runtime shim、受支持的虚拟机监控器(VMM)、KVM 和硬件虚拟化,还要准备 guest kernel,以及包含 kata-agent 的镜像。节点要么使用裸金属,要么所在虚拟机支持嵌套虚拟化。
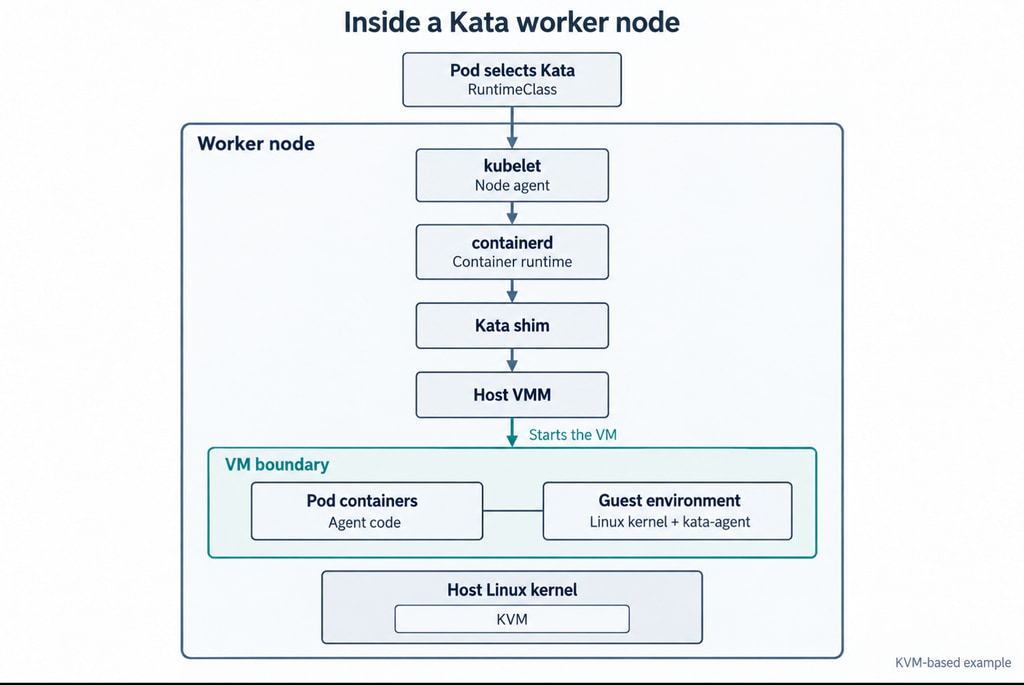
隔离增强了,维护面也增加了。宿主机和 guest 都有内核,遇到相关内核 CVE 时,需要分别检查和修补。guest 镜像也成为平台团队持续维护的对象。gVisor 同样需要在符合条件的节点安装运行时,并与 containerd 集成,只是没有同样的 guest kernel 维护结构。
Kubernetes 用 RuntimeClass 把这些底层差异暴露给 Pod,同时保留标准 Pod API。下面这段配置让调度器知道 Kata 的处理器名称、节点条件和额外资源开销:
apiVersion: node.k8s.io/v1
kind: RuntimeClass
metadata:
  name: kata
handler: kata              # runtime name in the node's containerd config
overhead:
  podFixed:
    memory: "160Mi"        # example value; measure your own
    cpu: "250m"
scheduling:
  nodeSelector:
    sandbox.example.com/kata: "true"
重点看 handler: kata 和 overhead.podFixed:前者必须匹配节点 containerd 中配置的运行时名称,后者要填实测开销。160Mi、250m 只是示例,不能直接当作生产预算。
Pod 通过 runtimeClassName 选择运行时:
apiVersion: v1
kind: Pod
metadata:
  name: agent-task
spec:
  runtimeClassName: kata   # or gvisor; omit for the default runc
  containers:
  - name: workspace
    image: python:3.12
注意 runtimeClassName: kata 这一行,它引用前面创建的 RuntimeClass。这里的 python:3.12 是示例工作负载镜像,不是 Kata 的依赖。原文把两段 YAML 和一句说明混进了同一个代码块,这里按配置边界分开展示。
把额外开销交给调度器和资源配额核算,是这部分最实用的提醒。gVisor 的 Sentry,以及 Kata 的 guest kernel、kata-agent、VMM,都需要资源。若预算只计算业务容器,节点实际负担就会被低估。
沙箱里的权限,以及空闲时的成本,也要有人管
隔离宿主机,不等于限制 agent 已经拿到的权限。
即使代码关在虚拟机里,它仍然可以删除可写仓库、读取挂载的密钥,或者向网络允许的地址发送数据。作者因此把访问控制单独列为一层:
- 网络通过 NetworkPolicy 默认拒绝出站访问,再放行任务需要的软件包镜像源或模型端点。
- 凭证使用任务范围内的短期凭证,避免把长期 token 直接挂进 Pod。
- 仓库和数据默认只读挂载,需要写入的工作区使用独立卷。
- API 端点和 MCP servers 分别做授权,因为这些远程工具运行在沙箱外。
最后一条很容易被忽略。agent 在沙箱里调用外部工具,外部工具执行操作时依据的是自身权限。虚拟机边界不会替远程服务校验请求。
会话管理解决的则是另一类问题:agent 的工作往往断断续续。执行一轮代码后,它可能等待模型或人类几分钟、几小时。保留虚拟机方便继续执行,但持续占用容量;销毁能释放容量,却要承担重建成本。预热池介于两者之间,仍需预留资源。
文章介绍的 Agent Sandbox 项目归 Kubernetes SIG Apps 管理。它通过 Sandbox API 创建具有稳定身份、持久存储的有状态单 Pod 环境,并提供模板、申领和预热池扩展。
这里要分清职责:Agent Sandbox 管会话环境的生命周期,隔离强度仍由所选 RuntimeClass 决定。原文没有给出项目版本、成熟度或实际恢复耗时,不能把 API 描述直接理解成完整的生产保障。
我的判断
这篇文章最有价值的地方,是把安全边界与平台运营放到了一张图里。运行时、节点、权限、调度、会话任何一项缺失,都可能让其余投入打折。对于需要执行未知依赖和临时脚本的 AI 编程平台,这套拆分很有用。
但文章带有明确的供应商视角:作者提到 OCI 用户的需求,并强调社区方案和托管服务的价值。它没有给出吞吐量、启动延迟、内存实测或隔离攻击测试,因此关于性能、密度和兼容性的判断,应当视为工程经验与架构取舍,不能当作对照实验结论。
我也不会直接推导出「所有 agent 都应该用 Kata」。执行固定命令的受控任务,与允许自由安装依赖、启动浏览器的开放任务,需求不同。相比统一抬高隔离等级,按任务暴露不同 RuntimeClass 更符合文章自己的思路,但也会增加配置和策略管理成本。
另外,作者说同一份 Pod spec 可以在符合规范的集群运行,这需要补上前提:目标集群必须准备好相应 RuntimeClass、运行时和节点能力。标准 API 有助于迁移,底层环境仍要逐项对齐。
能拿来做什么
- 如果准备让 agent 在集群里安装前端依赖、构建项目或运行无头浏览器,先拿这些真实任务验证 gVisor 与 Kata 的兼容性、启动耗时和资源开销,再确定运行时。
- 为 AI 编程任务建立独立权限模板,把依赖源、模型端点、仓库挂载和短期凭证逐项配置,并单独检查 MCP servers 的授权范围。
- 把实测额外开销写进 RuntimeClass,同时验证任务能否调度到具备运行时能力的节点,避免只配置
runtimeClassName就认为隔离已经生效。 - 对需要等待人工反馈的任务,分别评估常驻、销毁重建和预热池;采用 Agent Sandbox 前,先确认需要持久保存哪些状态,以及恢复环境要付出多少成本。