用 JSON 与 Zod 约束编程子代理输出
文章演示在 Claude Code SDK 子代理会话中传入 outputFormat,以 JSON Schema 约束返回结构,并用 Zod 校验字段。目标是减少主代理解析自然语言摘要时的正则补丁、格式漂移和静默错误。
AI 深度解读
让多个 Agent 并行分析仓库,麻烦往往出在结果交接:每个子代理都写一段总结,主代理再从自然语言里提取字段,格式稍有变化,解析就可能失效。原文给出的方案是用 JSON Schema 约束最终输出,再用 Zod 做运行时校验,把子代理之间的交接变成有明确契约的数据传递。
这个方向适合需要批量提取、汇总仓库信息的 AI 编程流程。不过,原文把结构校验、业务校验和自动重试混在了部分描述里,示例也有缺口。值得带走的是设计方法,具体 SDK 接口还不能照单全收。
JSON 约束解决的是交接问题,不是分析能力
原文从一个常见场景切入:主代理派出 5 个并行子代理,提取 API 端点元数据,收到的却是 5 段文字。下游只能依赖正则、兜底规则,以及对子代理措辞的猜测。
结构化输出把这一步改成预先约定字段。作者描述的入口是给 startSubagent() 传入 outputFormat,设置 type: "json_schema" 和转换后的 schema,最终读取 message.structured_output。
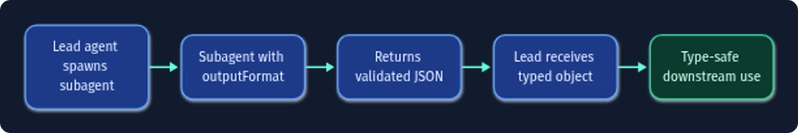
原文用「合成工具调用」(synthetic tool call)解释其工作方式:SDK 根据 Schema 生成一个用于提交结果的工具,让模型在最后调用它,再校验参数。执行过程中,子代理仍可使用 Bash、Grep、Read 或自定义工具;受输出 Schema 约束的是最终交付的数据。
结构化输出能约束数据长什么样,不能保证数据是真的。
例如,stars 是非负整数,只能证明它符合计数格式,不能证明它来自正确仓库。作者的示例让子代理从本地仓库提取名称、语言、Star 数、Issue 数和提交日期,却没说明 Star 数与 Issue 数的数据来源。字段定义越明确,越容易暴露这种输入条件的缺口。
可选字段也应该表达信息缺失,而不是诱导模型补齐。原文用 .optional() 定义 TODO 的 author 和 date:有 git blame 数据就填写,没有就省略;TypeScript 推导出的类型包含 undefined,下游必须检查后使用。
为什么有 JSON Schema,还要再跑一次 Zod
JSON Schema 负责描述可传递的数据结构,Zod 则可以同时承担类型推导和运行时校验。原文通过 z.infer 得到 TypeScript 类型,通过 zodToJsonSchema() 转换 Schema,目标参数写作 target: "draft-7"。
这几件事不能混为一谈。尤其是 as RepoMetadata,它只是 TypeScript 类型断言,不会检查实际返回值。真正接住模型输出,需要执行 parse() 或 safeParse():前者失败时抛异常,后者返回带有 success 的结果,方便程序决定下一步。
下面这段原文代码展示了结构约束之外的日期检查:
const repoMetadataSchema = z.object({
  name: z.string().min(1),
  primaryLanguage: z.string().min(1),
  stars: z.number().int().nonnegative(),
  openIssues: z.number().int().nonnegative(),
  lastCommitDate: z.string().refine(
    (val) => !isNaN(Date.parse(val)),
    { message: "Must be a valid ISO 8601 date" }
  )
});
要看的是 .refine():它调用 Date.parse() 检查字符串能否解析,但这不等于严格验证 ISO 8601 格式,尽管错误提示这样写。
原文还明确说,JSON Schema 的 format,例如 "format": "email",只作为注解接受,不负责强制验证。因此,业务要求不能只靠字段名、描述或格式标注表达。
这里存在一处直接矛盾:正文声称日期 refinement 失败会导致合成工具调用失败并触发 SDK 重试,FAQ 却又说 refinement 只在 hook 或结果处理器里执行,不在 SDK 校验内部执行。应当区分两条路径:SDK 根据 JSON Schema 校验结构;应用通过 Zod 执行自定义规则。后者失败后如何重试,需要应用明确接上处理逻辑。
校验失败以后,谁负责纠正和收尾
作者把校验放在 SubagentStop hook 中,意图是在子代理结果进入主代理上下文前拦截问题。流程是读取 hookSpecificOutput.structuredOutput,执行 safeParse(),通过就放行,失败则拒绝或补充纠错信息。
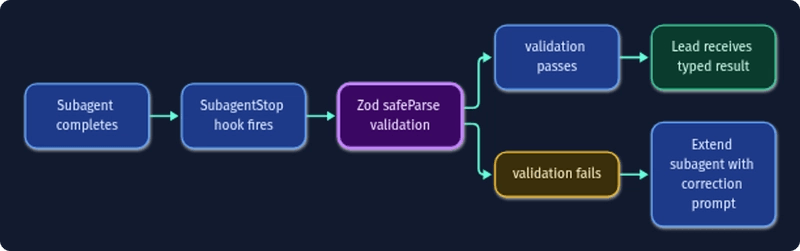
按原文描述,SDK 结构校验默认最多尝试 3 次,耗尽后产生 error_max_structured_output_retries。作者另称,SDK v0.3.301+ 的 hook 可以通过 additionalContext 补充反馈,用 behavior: "cancel" 拒绝结果,或用 behavior: "allow" 配合纠错提示延长子代理执行。
但示例没有把这条链路完整接起来:hook 示例只在 query() 中用提示词要求生成子代理,没有展示子代理如何拿到 outputFormat;最后又直接把主查询的 structured_output 断言成仓库元数据。子代理交付成功与主代理返回同一份结构之间,仍缺少明确契约。
另一条思路更容易复用:按任务层级组合 Schema。文件分析定义 fileAnalysisSchema,仓库分析通过 files: z.array(fileAnalysisSchema) 收集文件结果;批量分析再通过 repositories 汇总仓库,并计算 totalStars、mostActiveRepo。
不同文件类型可以使用判别联合,由 type 决定字段:
const fileSchema = z.discriminatedUnion("type", [
  sourceFileSchema,
  configFileSchema
]);

type FileAnalysis = z.infer<typeof fileSchema>;
要看的是作为判别字段的 "type":原文中 "source" 对应函数列表,"config" 对应配置键列表,下游可以据此缩小类型范围。不过,嵌套 Schema 只定义结果结构,收集子任务、处理缺失结果和计算汇总值,仍需编排逻辑完成。
我的判断
我认可「先定义交付契约,再让 Agent 执行」的方向。相比只在提示词里要求「返回 JSON」,Schema 加运行时校验能让失败变得可识别,也让下游少依赖自然语言格式。
但这篇更适合作为架构思路,不能当作已经验证的 SDK 使用手册。作者称示例运行于 Claude Code SDK v0.3.301、Claude Fable 5.1(claude-fable-5-1),并称该模型在 2026 年 9 月 1 日移除了 tool_choice 的 any 和 tool 类型支持。原文没有提供运行记录或对应接口依据。
它还把无效 Schema 从静默忽略变为启动报错的分界写成 SDK v2.1.205,与前述 v0.3.301 是否属于同一版本体系,没有交代。关于 Zod v4 于 2025 年末发布、zodToJsonSchema() 同时支持 Zod v3/v4,以及 error.issues 变化的说法,也缺少具体依赖版本;开头提到的 .toJSONSchema() 与正文所用转换函数并不统一。
性能结论同样应保留问号。作者给出末尾合成工具调用通常增加 100–300ms 的说法,却没有测试方法、样本或对照数据。「10 个并行子代理重试后仍常比顺序解析更快」还混入了并行与串行的差别,不能据此判断结构化输出本身更快。这些属于经验性说法。
对于固定字段提取,能用确定性程序完成的部分仍适合交给程序。Agent 更适合承担需要理解和判断的分析,再把结果交给可验证的接口。
能拿来做什么
- 如果 Node 脚本正在用正则解析 AI 返回的仓库分析结果,可以先把现有字段写成 Zod Schema,在消费结果前执行
safeParse(),明确区分数据有效、字段缺失和任务失败。 - 做 TODO 或文件信息提取时,把确实可能缺失的作者、日期定义为可选字段,并检查数据来源;不要为了满足必填字段而让模型猜测。
- 做仓库批量分析时,为文件、仓库和批次分别定义结构,把
totalStars等可确定计算的汇总值交给代码处理,同时规定子任务失败时是否允许返回部分结果。 - 迁移现有 AI 编程流程时,先核对安装版本是否支持文中的
startSubagent()、outputFormat和SubagentStop接口,再验证结构错误、业务校验失败和重试耗尽三条路径。