让编程智能体按变更影响选择测试
主张先追踪变更涉及的服务、接口契约、数据和业务规则,再据此选择测试。验证从局部检查开始,随依赖和风险扩大范围,同时保留必要的持续集成检查并说明未验证项。
AI 深度解读
Coding agent 改完代码、跑绿测试,为什么仍然可能把另一个服务弄坏?作者 Sohit Kumar 在这篇更新于 2026 年 10 月 29 日的文章里,给出的答案是:测试之前,先弄清行为变化会影响谁,再据此选择验证范围。
文章围绕一个跨服务的发票导出示例,讨论如何追踪消费者、检查契约、保留验证证据。它最有价值的部分,是把「跑哪些测试」变成一套可以审查的推理过程,同时提醒我们:测试通过,也可能只是实现和断言一起理解错了需求。
先确认业务规则,否则测试也会跟着写错
示例需求很常见:组织的账单管理员选择日期范围,后台 worker 生成发票文件,管理员随后下载;只有查看权限的用户不能申请导出,也不能下载。
看起来只需要改按钮、API 和 worker。但真正决定实现是否正确的,是几个还没回答的问题:
- 日期范围筛选的是发票创建时间、开票时间,还是付款时间?
- 日期按哪个时区计算?
- 导出过程中管理员失去权限,任务和下载入口应该如何处理?
这些问题不能靠 agent 自己补全。作者要求把它们交给有决策责任的人,并记录最终接受的行为、规则来源和未决事项。新需求与旧契约冲突时,也要保留冲突。
这里的「契约」可以理解为系统边界两侧共同遵守的约定,包括字段名称、数据含义和访问规则。代码依赖图能告诉你谁调用谁,却未必能解释某个服务里的 invoice date 到底指什么。
测试预期必须有独立的业务依据,不能只从刚写好的实现里反推。
例如,验证导出日期范围时,应先根据已经确认的规则确定哪些发票必须出现,再检查生成文件。如果实现和测试都把「开票日期」误解成「创建日期」,测试全绿仍然无法说明需求被满足。
没改动的服务,也可能需要验证
作者建议沿着用户最终得到的结果追踪影响。下面这段流程用于找出一次导出经过的系统边界:
Admin selects a date range
    → Frontend submits the request
    → API checks access and creates a job
    → Queue carries the job payload
    → Worker selects invoices and generates the file
    → Storage retains the file
    → Download path checks access again
要留意最后一行:下载时仍然需要检查权限。即使下载服务没有代码改动,只要新功能依赖它的授权行为,它就应该进入验证范围。
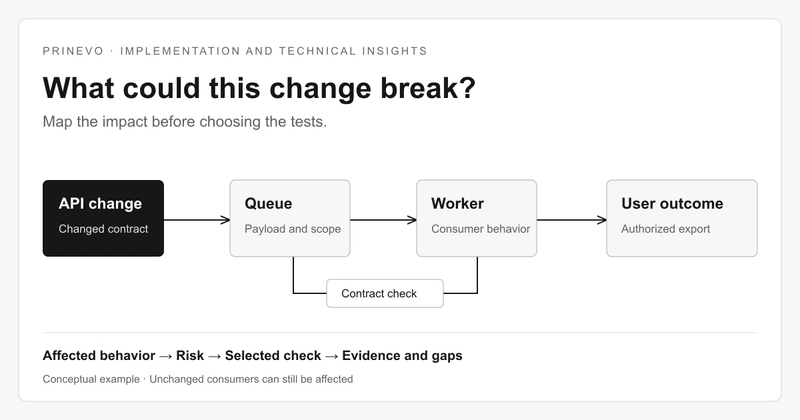
每一个箭头都要继续追问:传递了什么数据,谁来消费,遵守哪份契约,实际部署的是哪些版本?前后端版本不一致、另一个仓库仍运行旧消费者,都可能让单仓库里的正确修改变成集成故障。
查找这些关系,可以结合代码引用、API 与事件 schema、部署配置、现有测试和架构决策。运行时 trace 也能提供证据,但它只证明已经执行过的路径,不能证明其他消费者不存在。怀疑存在的依赖,要明确标成待确认。
作者引用过自己此前记录的一次问题:服务发送 created_at,消费者期待 createdAt。各自测试通过,放在一起运行的集成检查才暴露不匹配。这是文中具体的经历性证据,但没有提供故障样本数量或系统性的对照结果。
影响图还需要附上关系来源和负责人。给 agent 的上下文,应包含与任务相关的依赖和已批准决策。把所有历史对话塞进去,并不能自动得到可靠的系统理解。
测试先追求有效反馈,再根据风险扩大范围
建立影响关系后,才能解释为什么要跑某项检查。
对发票导出,作者建议准备日期范围之前、之内、之后的发票,再加入其他组织的发票。前一组检查日期筛选,后一组检查组织隔离。预期记录应在比较导出结果之前确定。
每项检查都要写清两件事:它针对什么风险,预期结果来自哪里。使用 mock 时也要注明。模拟消费者接受了某个 payload,只能证明模拟逻辑接受它,无法证明真实消费者兼容。
执行顺序可以从反馈最直接的检查开始。日期边界测试一旦失败,通常能较快定位筛选规则;浏览器里点导出失败,则可能涉及前端、API、worker 或存储,需要继续排查。因此,先用聚焦检查辅助实现,再验证实际跨越的服务边界,有助于缩短定位过程。
这套做法不支持随意缩减测试。共享组件发生变化、事件有多个消费者、影响关系尚未查清时,都应该扩大验证范围;规定必须运行的 CI 检查仍然保留。
选中的测试是否充分,要看它能否发现相关故障,不能只看数量和耗时。
作者对「agent 总能找到最小测试集」也持保留态度。他建议先检查所选测试能否捕获已知回归,再观察更广泛的验证是否持续发现遗漏。原文没有给出测试耗时下降比例,也没有证明这套方法能稳定减少缺陷。
影响分析还要跟着实现更新。发现另一个 worker 消费导出事件后,需要补充消费者和证据,并重新检查契约决策及验证计划。QA 发现记录不对时,应返回预期与实际记录、复现步骤、被测修订版本和日志;修复后,再运行受影响的检查。
旧版本通过的证据,不能直接算到新版本头上。
审查者最终需要的是一份紧凑记录:接受的行为及来源,受影响组件和负责人,已确认与待确认依赖,检查理由及排除项,被测版本、环境、结果和重跑情况,以及剩余缺口和兼容性假设。缺凭证就标明场景受阻,下载路径没测就明确留空。沙箱通过与生产发布、上线观察,也应分别记录。
我的判断
我认同作者把业务规则和系统边界放在测试选择之前。对前端和全栈开发者尤其如此:按钮能点击、接口返回成功,距离后台任务正确完成、文件内容正确、下载权限有效,还有几层需要验证的关系。
相比只按修改文件挑测试,影响分析更容易覆盖未改动的消费者;相比一开始就跑全套,它试图让早期失败更容易定位。不过,全量测试仍可作为更广泛的检查,两者可以配合使用。
它的前提是团队能找到相对可信的契约、部署信息和决策负责人。跨仓库信息缺失时,agent 很难独立补齐影响图。此时应增加调查和人工判断,不能把一份写得完整的记录当成依赖已经查全。
文章也带有 Prinevo 的产品叙事。作者认为共享上下文层可以保存需求、契约、发现和交接证据,但没有提供与普通 PR 模板、文档或现有测试平台的对照数据。这部分应视为工作流主张,不能据此认定必须引入特定产品。
最需要保留的警惕,是 agent 的猜测可能被反复引用,最后变成团队默认事实。只有带来源、经过确认的修正,才适合沉淀为后续任务的共同依据。
能拿来做什么
- 下次修改前端到 Node API、再到队列 worker 的功能时,先让 agent 列出行为规则、消费者和未决问题,由负责工程师确认验证范围后再依赖这份计划。
- 修改接口字段或事件 payload 时,让 agent 查找真实消费者及部署版本,并分别说明 mock、契约检查和真实集成检查能证明什么。
- 在跨服务 PR 中附上一份简短影响记录,写明检查理由、被测提交、环境和未覆盖路径,让审查者能沿着证据判断风险。
- 先在一次有代表性的变更上试用,记录遗漏依赖、发现有效故障的检查,以及人工补充和审查返工;根据结果调整流程,再决定是否推广。