Sentinel-IR 优化大文件分析与调用识别
开源分析器 Sentinel-IR 0.4 系列提高原生代码风险等级,支持识别通过不同本地变量名调用的文件和 HTTP 操作,并提供解析错误位置。项目自测中,480 KB JavaScript 文件分析从 75 秒降至 1.3 秒,同时修复长期运行的解析器内存问题。
AI 深度解读
让 AI 读代码之前,先给它一张「这个文件会做什么」的标签,能不能减少全文读取,又避免漏掉危险操作?sentinel-ir 0.4 系列围绕这件事补了四块短板:识别原生代码、加快大文件分析、定位解析错误,以及沿模块绑定识别文件和网络调用。
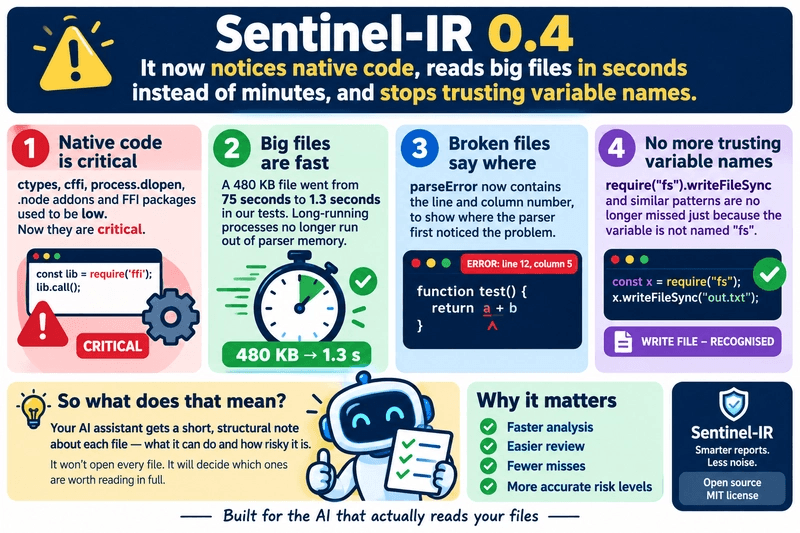
作者给出的结果很具体:480 KB JavaScript 文件从 75.4 秒降到 1.3 秒,一些此前被标为 low 的操作也得到纠正。但它仍然只分析单个文件,描述代码具备的能力,不能直接判断有没有漏洞。
给 AI 的代码标签,到底能替代多少全文阅读
sentinel-ir 把 JavaScript、TypeScript 或 Python 文件转换成结构化摘要,再交给 AI 决定哪些文件需要完整读取。摘要可以表达:文件读取环境变量、写入磁盘,并在某一行访问网络。
这适合代码库初筛。模型不必一开始就接收所有源码,也能知道哪些文件值得进一步检查。作者还希望减少源码中诱导 AI 改变行为的文本进入上下文,但原文没有提供节省 token、提高审查准确率或抵抗提示注入的对照数据。
安装命令是 npm install sentinel-ir@^0.4.4,接入只需要分析和压缩两步:
const { analyzeAsync, compress } = require("sentinel-ir");

const ir = await analyzeAsync(source, { target: "src/upload.js" });
console.log(ir.world.risk, ir.analysisStatus, ir.facts.operations);
const forTheModel = compress(ir); // 发送给 LLM 的紧凑形式
要看清最后一行:传给模型的是 compress(ir) 的结果;应用自己仍应检查 analysisStatus,不能只取风险等级。
语言由 target 扩展名或 language 指定,支持 .js .mjs .cjs .jsx .ts .mts .cts .tsx .py .pyi。CI 覆盖 Node 20、22、24。
为什么变量改个名字,风险就会被漏掉
旧版本识别部分 fs、HTTP 调用时,依赖接收对象的常见名称。const net = require("https"); net.get(...) 里的对象叫 net,网络操作就可能被漏掉;直接写 require("fs").writeFileSync(...) 也曾得到 low。
0.4.4 改为追踪绑定来源:这个值从哪个模块、哪个导出成员而来。即使经过别名或解构,也尽量保留来源信息。它复用了此前处理 child_process 的作用域遍历逻辑。
变量名只能提供线索,模块来源才是识别操作的依据。
覆盖范围包括 fs、fs/promises、fs-extra、graceful-fs,以及 http、https、http2 和多种 HTTP 客户端。删除操作标为 high,写入和网络调用标为 medium。作者的示例中,解构出来的 unlinkSync: del、fs-extra.remove 都从 low 变成 high。
但识别来源之后,还得区分方法用途。got.paginate、axios.postForm、undici.upgrade 会计入网络能力,isAxiosError、setGlobalDispatcher、MockAgent 则不会。首版规则曾把导入的辅助函数误判成网络请求,后来改成按原始导出成员分类。
测试也检查了反面情况:db.writeFileSync()、cache.get()、Map.get()、lodash 的 get、同名局部函数和 TypeScript 类型导入,都不应仅因名字相似而升级风险。
在 8,819 个文件上与 0.4.3 比较,8,807 个输出相同,12 个新增了真实 fs 调用,其中 3 个从 low 升为 medium;HTTP 规则没有带来变化。另有 9,000 个随机绑定程序,没有崩溃或丢失信号。代价约为 10% 的分析耗时增长,但作者也注明测量存在噪声。
原生调用和解析失败,为什么要单独看
0.4 的另一项修正,是把原生代码能力提升到 critical。Python 的 ctypes.CDLL("libc.so.6").system(b"echo hi"),在 0.3.1 中是 low,到 0.4.2+ 才变成 critical。
这类能力可以越过普通脚本接口,调用本地库或执行机器代码。覆盖对象包括 Python 的 ctypes、cffi、带 PROT_EXEC 的 mmap、llvmlite JIT,以及 JS/TS 的 process.dlopen、process.binding、Deno.dlopen、.node 插件、koffi、ffi-napi、bun:ffi、node-gyp-build 等。
命中后,facts.operations.nativeCode 为 true,forbidden 包含 native_code,信号携带行号。普通 import ctypes 或 sizeof 不会因此命中;运行时计算出来的加载器名称则采取更保守的处理。
作者用 119 个手写绕过和相似案例,找出了最初版本的 36 个错误,包括 34 个漏报、2 个误报。0.4.1 修复其中 31 个,0.4.2 再补动态名称和更严格的文本回退。0.4.0、0.4.1 都未发布,首个公开的 0.4 版本是 0.4.2。
生成测试另有 486 个正例、123 个反例;8,815 文件语料中,新增原生调用标记的 64 个文件都经人工确认。不过,原文没有外部召回率数据,不能据此认定所有原生调用都能被发现。
解析失败同样需要明确暴露。0.4.3 新增的 parseError 会给出位置和原因:
const ir = await analyzeAsync("function f(a {\n  return a\n}\n", { target: "broken.js" });
ir.analysisStatus   // "incomplete"
ir.facts.parseError // { line: 1, column: 13, kind: "missing", expected: ")" }
要注意 incomplete:错误位置只是解析器首次发现异常的位置,未必就是根因。kind 可以是带 expected 的 missing,也可以是 unexpected。
语料里 9 个解析不完整的文件,全都涉及解析器尚不支持的新 TypeScript 语法,例如 export type *、in T 方差标注。因此,解析失败既可能来自坏代码,也可能来自语法支持滞后。
解析不完整时的 low,不能作为安全证据。
大文件提速成立,但倍率取决于代码形状
性能问题来自重复查找。旧实现对每个引用反复遍历作用域和祖先链,形成二次复杂度。0.4.3 为单次分析缓存绑定名称、父级和执行路径,并按偏移量索引别名写入。
作者在 Node 22、Linux VM 上测得:同一个 480 KB 生成文件,0.4.2 耗时 75.4 秒,0.4.4 为 1.3 秒。文中另称约 1 MB 文件从接近三分钟缩短到约 6 秒,但也明确提醒,倍率高度依赖代码结构。
结果一致性检查提供了另一层证据:8,816 个文件中,8,807 个与 0.4.2 字节级一致,其余 9 个仅增加 parseError;10,000 个随机程序没有差异。
常驻进程还修了一个独立问题:WebAssembly 解析树没有调用 delete() 释放。重复分析同一个 18 KB 文件时,0.4.1 在第 4,881 次、累计约 88 MB 后中止,此后静默返回 incomplete。0.4.2 连续分析 20,000 次仍保持完整,回归测试也检查解析树释放。
我的判断
我认可这次更新优先修正漏报、解析状态和长期运行稳定性。作为 AI 读取源码前的筛选层,摘要是否可靠,比摘要是否简短更重要。作者给出了复现代码、语料比较和随机生成测试,v0.4.4 的 npm test 结果为 320 项全部通过,证据比单独展示几个成功例子充分。
局限也很明确。它不跨文件追踪,不跟踪用户输入,所以 readFileSync(req.query.f) 仍可能是 low。模块作为参数传进另一个函数的情况也没有完整覆盖,甚至仍保留「参数恰好叫 fs 就按模块处理」的旧假设。
它更适合补充全文审查和污点分析:先标出能力,再深入检查参数来源、权限和调用链。原文没有与完整安全扫描方案的对照数据,也没证明能降低多少 AI 使用成本。另外,标题带有 Windows update,正文没有展开 Windows 专项变化,不能自行补出兼容性结论。
能拿来做什么
- 给 Node 或全栈项目的 AI 审查流程增加文件摘要,把写盘、删除、网络和原生调用作为优先阅读源码的线索,同时保留解析状态。
- 升级到 0.4.4 时,用项目中真实的别名导入、解构、动态导入和同名局部变量检查结果,再用实际大文件测耗时。
- 遇到
analysisStatus === "incomplete"时,把parseError一起交给后续流程,并安排源码复核,避免自动跳过 low 文件。 - 审查路径读取等输入敏感操作时,继续检查参数来源和跨文件调用链,不让能力分级代替漏洞判断。