33B 模型在 Mac 上跑编程任务的现实门槛
作者尝试在 96GB Mac Studio 上评测 Nanbeige4.3-33B,但因推理引擎丢弃工具调用及上下文内存不足,未能进入正式测试。文章提供速度曲线、内存适配表与启动命令,并估算完整测试至少需要 128GB 内存。
AI 深度解读
Nanbeige4.3-33B 在 Mac 上跑真实编程任务,首先遇到的竟然不是代码能力问题。作者用一台 96 GB 的 M3 Ultra Mac Studio 做测试,模型还没进入正式评测,就被工具调用解析和内存检查拦住了。
这篇最有价值的部分,是把「模型不行」拆成了可以排查的工程问题。另一组 Particle-1 测试则提醒我们:输出 token 更少,账单未必更低,榜单分数接近也未必代表完成质量相同。
模型会调用工具,为什么 Agent 收不到
作者准备运行两套真实应用评测:Gauntlet sb-7.2 要求 Agent 在 150 次模型调用内构建支付控制台,包含两个 Python 服务、供应商 webhook 和 3D 视图;Forge 2.0 则给 300 次调用,要求升级 Jira Forge 应用。
正式评测需要 5 到 15 小时,所以他们先检查模型版本、工具调用和可用上下文。Nanbeige 的预检花了约 1 小时 20 分钟,只有版本检查通过。
问题出在作者自己的 MLX 服务引擎。它是 Rapid-MLX 的分支,靠模型路径匹配解析器,第一条匹配规则生效。旧规则把 nanbeige 映射到 Hermes,那是为 Nanbeige4.1-3B 写的;Nanbeige4.3 实际需要 --tool-call-parser qwen3_coder。
Hermes 期待 JSON,模型却输出 XML。引擎生成的格式约束屏蔽了 <,随后又采到了约束未覆盖的填充词表 ID。模型配置声明了 166,912 个 ID,日志报出 token id 166911 out of range; stopping,最终退回自由生成,工具调用也损坏了。
绕过这条链路,作者用官方模板直接请求 /v1/completions,采用贪心解码,模型就能输出正确片段:
<tool_call>
<function=developer__text_editor>
<parameter=command>
write
</parameter>
要看的是第二行:<function= 前的左尖括号完整存在。模型知道怎么调用工具,服务端却把格式弄坏了。
作者通过临时改目录名,让引擎命中另一条规则后,模型完成了写文件、执行、总结的三轮往返,流式、非流式和开启 thinking 都通过了。但他们没有把这个临时方案送上榜,计划修复版本匹配和填充 ID 的约束覆盖。
工具调用失败,要沿模板、生成约束、解析器和响应字段逐层定位。
96 GB 为什么仍然装不下长对话
Nanbeige4.3-33B 的 8-bit 权重约 35.2 GB,但权重只是常驻内存的一部分。长对话还需要 KV cache,用来保存模型已经读过的内容,避免每生成一个 token 都从头计算。
它有 52 层、56 个注意力头、8 个 KV 头,每个头宽 128。使用 bf16 时,每个上下文 token 的缓存开销是:
2 × 52 × 8 × 128 × 2 = 212,992 bytes
Gauntlet 的云端运行曾达到 322,851-token 提示,仅 KV cache 就需要约 68.8 GB。再加权重和工作空间,作者的内存检查估算约需 106 GB。模型卡标注的 524k 上下文上限,并不保证机器有足够内存用满。
实际情况还更差。测试期间其他会话占了 23 到 36 GB;引擎又把自己的磁盘缓存回读内存算进「其他程序」,反过来缩小自身额度。一次 128,123-token 请求估算需要 64.7 GB,安静时额度有 73.7 GB,却在预填充约 8.5 分钟后被拒绝。这里是检查逻辑出了错,不能当作机器真实耗尽内存的证据。
int8 KV 也没救场。理论上,它能把目标上下文的缓存降到约 36.5 GB,但引擎仍按 bf16 收取内存预算;实际预填充还产生了额外临时内存。作者切回 bf16 后,在约 10k、31k、64k 上下文处,解码分别快了 18%、37%、60%。
这是该引擎实现下的结果,不能扩展成「int8 KV 普遍更慢」。作者认为还需要修正预算算法,并为 int8 路径提供融合注意力实现。
他们测到约 10k 上下文时解码为 17.9 tokens/s;冷启动读取 75,925 tokens 则等了 895 秒才返回首 token,这一条使用 int8。128k 的约 9.5 tokens/s、322,851 tokens 的约 5.4 tokens/s,以及完整 Gauntlet 约 12 到 18 小时,都是外推。
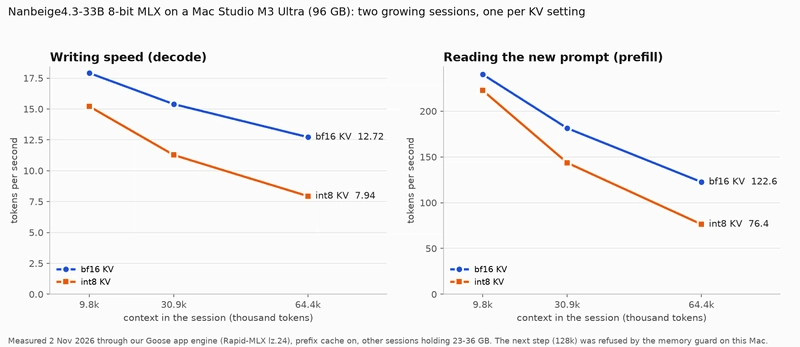
作者据此推算,8-bit 权重下,128 GB 是容纳该 Gauntlet 的最小 Mac 档位,前提是机器基本不跑其他东西。96 GB 的理论约 205k 上下文,实测只成功服务到约 64k 至 76k。原文提到的完整适配表没有出现在所提供的正文里,不能据此补出其他档位。
Particle-1 少输出 token,为什么账单更高
Particle-1 是基于 DeepSeek V4.1 Flash 后训练的 API 模型。它使用覆盖各层专家的 rank-64 LoRA,新增参数约占 1.25%,训练奖励同时追求任务成功和减少推理、工具调用 token。
官方宣传平均少用约 45% token。作者从页面四项编码评测数据算出平均减少 40.5%,没找到约 45% 对应的任务集合。四项都使用 Terminus 2,每题 16 次尝试,512k-token 限制和最高推理强度。
成本下降 34.4% 到 51.6% 的计算能对上,但它假定缓存命中率为 95%。作者自己的 Particle-1 运行只有约一半提示被按缓存命中计费,最终比两个 DeepSeek 快照都贵。
Gauntlet 各跑一次,Particle-1 得到 0.5873,DeepSeek 九月快照为 0.5910,10 月 17 日的 1017 快照为 0.6957。不过评分器会对关键失败设置上限,把超过上限的成绩压到很窄的区间。封顶前,Particle-1 是 0.7679,九月版是 0.8403,接近的最终分数遮住了一部分差距。
Forge 2.0 各做两次构建,Particle-1 为 0.653、0.5717,平均高于九月版的 0.2893、0.379,也高于 1017 的 0.2422、0.6618;最佳单次仍属于 1017。
样本很少,设置也不完全一致:Particle 的 medium 会映射为 High,DeepSeek 的实际推理强度未统一;应用版本分别为 3.0.149 和 3.0.118。作者判断 Particle-1 可能基于九月快照,也只是根据官方引用分数作出的推断。
我的判断
作者最有说服力的做法,是承认 Nanbeige 没有正式成绩,并把服务故障与模型能力分开。官方模型卡上的 Terminal-Bench 2.1 为 80.9、DeepSWE 为 65.5,这些仍是实验室在自身框架、最高 thinking 强度下给出的数字,不能充当这次本地测试的结果。
边界也要守住:隐藏事实检索每次成功,只能证明这项探针有效;35.2 GB 的第三方量化权重在 563 tokens 上获得 98.76% top-1 一致率,也不足以证明复杂编程能力完整保留。
Particle-1 的结论同样需要收窄。当前结果支持「这几次运行没有体现成本优势」,还不足以判定它在所有编码任务中都不划算。官方数据里的 partially_reported、user-supplied-simulated 标记未获解释,更需要保留疑问。
提供的原文最后截断在一次 3D 绘制调用分析处,因此无法确认那个缺失索引列表的问题最终如何修复。
能拿来做什么
- 接本地模型前,先做写文件、执行、总结的三轮工具调用检查,同时覆盖流式与非流式响应,确认返回了结构化的
tool_calls。 - 想尝试这份权重,可以从作者建议的命令开始,但要自行验证服务表现:
mlx_lm.server --model fcmeyer/Nanbeige4.3-33B-MLX-8bit --port 8080
关键是 mlx_lm.server:作者检查过 0.31.3 和 0.32.2 的模板识别逻辑,却没有通过它做实际性能测试,文中的速度不能直接套用。
- 给长任务配置上下文时,同时记录首 token 等待、解码速度、KV 类型和后台内存。购买 128 GB 机器前,先用自己的对话长度验证作者的估算是否适用。
- 比较 AI 编程 API 时,保存完成质量、实际账单和缓存命中率;只看输出 token 或封顶后的总分,都可能选错方案。