共享 GPU 容量规划要看上下文总量
共享 GPU 上的请求共同等待解码步骤,长会话会增加每步读取历史状态的负担,拖慢其他用户的输出。文章建议用处理中 token 总量规划容量,而非仅统计并发用户数。
AI 深度解读
共享 GPU 上的模型服务,可能只多进来两个长会话,就让所有人的回答速度减半。请求数没怎么涨,显存也还有空位,问题却已经发生了:每轮生成需要读取的数据太多,GPU 的显存带宽吃满了。
作者给出的容量规划方法是:用所有运行中请求持有的上下文 token 总量控制准入,再根据目标生成速度设预算。对自建推理服务、把代码审查或 Agent 接进现有聊天产品的团队,这比单看并发数更有参考价值。不过,文中的性能数字需要分清哪些来自估算,哪些经过了公开数据验证。
为什么两个 Agent 会拖慢四十个聊天用户
作者用 Qwen3 8B 和一张 H100 举例:40 个聊天用户,每人约持有 2,000 tokens,单用户生成速度约为 71 tokens/s。再加入两个各持有 100,000 tokens 代码和工具输出的 Agent 会话,所有用户的速度就降到约 35 tokens/s。
这是文中模型给出的场景估算,不能当成作者实机压测的记录。
原因藏在解码步骤(decode step)里。在作者讨论的批处理模型中,每一步会给每个运行中的请求生成一个 token,大家共同等待这一步完成。一步变慢,整个批次的输出节奏都会变慢。
GPU 每步要读取模型权重。Qwen3 8B 使用 16 位数值时,权重约为 16.4 GB。H100 的峰值显存带宽为 3.35 TB/s;按实际解码达到峰值约 60% 估算,单步约需 8 毫秒,单用户约能得到 120 tokens/s。同一个批次共享这次权重读取,因此增加一个用户,通常不用再完整读取一遍权重。
但每个用户还带着自己的 KV cache,也就是模型为已处理 token 保存的键和值。普通全注意力模型生成下一个 token 时,需要访问这些历史数据。
Qwen3 8B 每个 token 对应 144 KiB 缓存。2,000-token 聊天约占 0.29 GB,100,000-token Agent 会话约占 14.7 GB,已经接近整套权重的大小。
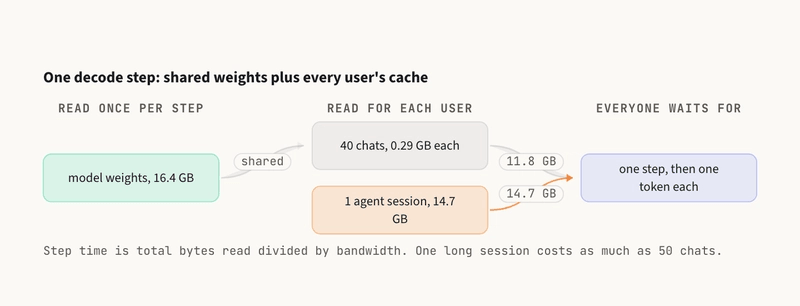
共享 GPU 的流式速度,不能只按同时在线的请求数规划。
长会话不只是多占一点显存,它会在后续每一步持续增加读取成本。这个成本由整个批次共同承担。
显存装得下,为什么速度还是不达标
显存容量回答的是「能存多少」,显存带宽回答的是「每步能多快读完」。两个限制不能混用。
按文中配置,一张 80 GB 显卡使用到 90% 时,扣除权重后,缓存约能容纳 377,000 tokens。但如果要求每个用户达到 50 tokens/s,每一步就必须控制在 20 毫秒内,对应的运行中上下文预算只有约 134,000 tokens。
于是,服务完全可能继续接收请求,显存监控也没有报警,用户却已经觉得输出越来越慢。
新请求还会带来另一种干扰。预填充(prefill)负责处理新提示词并建立缓存,主要受计算能力约束。服务会把它切成块,混进执行步骤。作者估算,每步加入一个 2,048-token 的提示词块时,前面 40 个聊天用户会暂时降到约 15 tokens/s,直到提示词处理完成。
因此,速度下降既可能来自历史上下文变长,也可能来自新提示词处理挤占计算资源。
作者如何验证?他们用一个公开测量值拟合模型,再拿 MosaicML 发布的 MPT-7B 单张 A100 数据检验,覆盖 batch size 1 到 64。只计算权重读取时,吞吐量被高估了 4.7 倍;补上缓存和提示词处理成本后,误差收敛到 6% 以内。
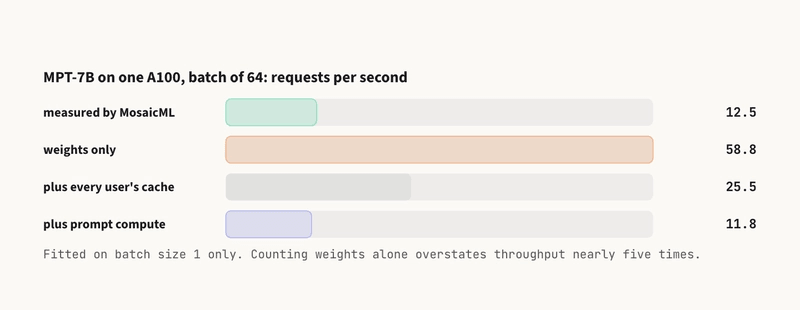
这支持了「不能漏算 KV cache 和 prefill」的判断。它还不足以证明所有模型、调度器和硬件都能达到相同精度。
怎样把速度要求变成网关能执行的预算
第一步是从模型配置计算单 token 缓存大小,再测服务器真正能达到的带宽。作者给出的计算和校准代码如下:
KV_TOK = 2 * 36 * 8 * 128 * 2                  # Qwen3 8B:每个 token 为 147,456 字节
WEIGHT_BYTES = 8.2e9 * 2

def measure_effective_bandwidth(inter_token_latency_s, context_tokens):
    # 在空闲服务器上运行单路请求;峰值的 60% 很常见,但应测量自己的服务器
    return (WEIGHT_BYTES + KV_TOK * context_tokens) / inter_token_latency_s

def max_tokens_in_flight(target_tps, bw, headroom=0.9):
    step = headroom / target_tps               # 每步预留 10% 给提示词块
    return int((step * bw - WEIGHT_BYTES) / KV_TOK)
重点看 headroom=0.9:预算主动留出了 10% 余量,但这不保证任何提示词负载都能被覆盖。
缓存公式中的系数依次是键和值、36 层、8 个 KV heads、128 的 head size,以及每个数值 2 字节。144 KiB 是 Qwen3 8B 在这里的配置结果,不能直接套给其他模型。
作者建议分别用短上下文和长上下文运行单路请求。如果反推出的有效带宽相差超过 15%,就先检查前缀缓存、缓存量化等因素。vLLM 启动时也会打印 KV cache 的 token 容量,可以用缓存内存除以容量,交叉核对单 token 成本。
第二步是在网关按 token 准入。vLLM 的 --max-num-seqs 可以继续充当请求数安全上限,但还需要下面这样的预算检查:
class ContextBudget:
    def __init__(self, max_tokens):
        self.max_tokens, self.in_flight = max_tokens, 0

    def try_admit(self, context_tokens):
        if self.in_flight + context_tokens > self.max_tokens:
            return False                       # 排队,或转到长上下文池
        self.in_flight += context_tokens
        return True

    def release(self, context_tokens):
        self.in_flight -= context_tokens
要留意 try_admit 收到的 context_tokens:作者要求按提示词加输出上限预留,完成后释放。这样能提前考虑生成过程中的上下文增长。
这段代码只是准入逻辑示意。实际接进 Node 网关时,还要补上并发计数、取消请求和异常退出后的释放处理。超过预算的长请求,可以排队或转入专门的长上下文 GPU 池。
第三步是核对预测和真实延迟。文中使用三个 vLLM 指标:vllm:inter_token_latency_seconds、vllm:num_requests_running、vllm:kv_cache_usage_perc。用缓存使用率乘以缓存容量估算运行中 token 总量,再把预测单步耗时和实测延迟画在一起。
作者建议预测超预算持续五分钟再告警;负载变化时,预测应与 token 间延迟的中位数保持在约 15% 误差内。如果缓存使用率平稳,速度却下降,应检查 prefill,并降低其预算。
我的判断
我认同这套方法最有用的部分:它把「用户觉得慢」转成了可以校准和执行的资源预算。相比只看显存和请求数,它能解释长短请求混跑时,为什么服务没有报错,体验却持续恶化。
但公式有适用边界。它主要描述普通 Transformer、解码受显存带宽限制的情形。短上下文并发超过几百个后,计算可能成为瓶颈;MoE 读取的专家权重随批次变化;滑动窗口注意力会限制缓存读取范围;缓存量化也会改变单 token 成本,都需要重新拟合。
把长会话分池,是合理的工程选择。不过,作者没有给出与统一池调度相比的成本、利用率和尾延迟对照数据,这部分仍属于经验建议。隔离之后能减少互相干扰,也可能留下暂时闲置的资源。
token 预算适合做速度约束下的容量控制,不能替代整套性能分析。
只调用托管 API 的团队看不到共享批次,也控制不了底层准入。文中的公式无法直接变成客户端限流策略。只追求吞吐量的离线任务,则可以接受更慢的单用户输出,采用不同预算。
能拿来做什么
- 如果准备在自建聊天服务中加入 Agent 或整库代码审查,先把长短上下文混合压测。复现「40 个短聊天加两个长会话」这样的负载结构,比只增加并发数更能暴露问题。
- 为使用 vLLM、SGLang 或 TGI 的服务测一次单路生成速度,再分别用长短上下文校准有效带宽。确认公式能解释当前服务器后,再计算目标速度下的 token 预算。
- 在 Node 网关中预留提示词加输出上限的 token 成本,并处理完成、取消和异常释放。先记录预算超限情况,再据此决定排队或分池策略。
- 把 token 间延迟、KV cache 使用率与预测耗时放在同一张监控图上。遇到流式输出变慢,先判断是上下文读取增加,还是 prefill 干扰,再调整对应限制。