Kakao 推出面向 Agent 的结构化决策模型
Kanana-2-v-decide 基于多模态 3B 模型,直接输出概率、选项和分数,采用允许商用的 Kanana Open License。厂商称其在单张 H200 上平均响应不超过 0.04 秒,速度及榜单成绩仍待独立验证。
AI 深度解读
Kakao 把 Agent 里的「做判断」单独做成了一个模型:Kanana-2-v-decide 不生成解释性句子,而是返回概率、选项和分数,让后续代码直接执行。它瞄准的是工具路由、候选排序、是否通过检查这类高频步骤。
这个方向值得关注,因为 Agent 每轮都可能做多次判断,等待自然语言输出会累积延迟。不过,原文最醒目的 0.04 秒、快约 43 倍和榜单领先,都来自厂商测量,实际收益还要看自己的任务。
Agent 的每一步都需要生成文字吗
一般聊天模型通过生成文本回答问题,但生产流程里的不少环节只需要一个明确结果:调用哪个工具、几个答案谁更好、某个条件是否成立。
Kanana-2-v-decide 基于 Kakao 的多模态模型 Kanana-2-v-3b。它的关键区别在输出端:跳过句子生成,输出下游代码可以读取的结构化决策值,包括概率、选择和分数。
例如,路由环节需要的是「把请求交给哪个模型」,而不是一段路由理由。决策模型负责选,大模型继续承担需要语言表达的工作。原文提出的分工,就是把这些职责拆开。
需要做选择的步骤,可以单独评估是否还需要生成一段话。
但原文没有提供调用代码、API、输出字段或部署命令。这里能确认的是输出思路,还不能据此直接写出接入实现。
0.04 秒和快 43 倍,该怎么看
据 Kakao 测量,Kanana-2-v-decide 在单张 Nvidia H200 上的平均响应时间不超过 0.04 秒,约比 GPT-6 Luna 快 43 倍。
这个数字有吸引力,但它描述的是指定硬件和测量条件下的模型响应。原文没有交代完整的对比配置,也没有给出整个 Agent 完成任务的耗时。单次判断更快,最终能省多少时间,取决于流程里判断步骤的数量,以及其他环节占用了多少时间。
准确率方面,Kakao 报告了两组结果:
- 在包含 15,909 道韩语问题的 Kanana Decision Bench 上,得分领先于参与比较的模型。
- 在公开的 Decision Index 上,也报告了比较范围内的最高分,领先于 Microsoft Decision-1、Typesafe Zeb 和 Upstage Solar Decide。
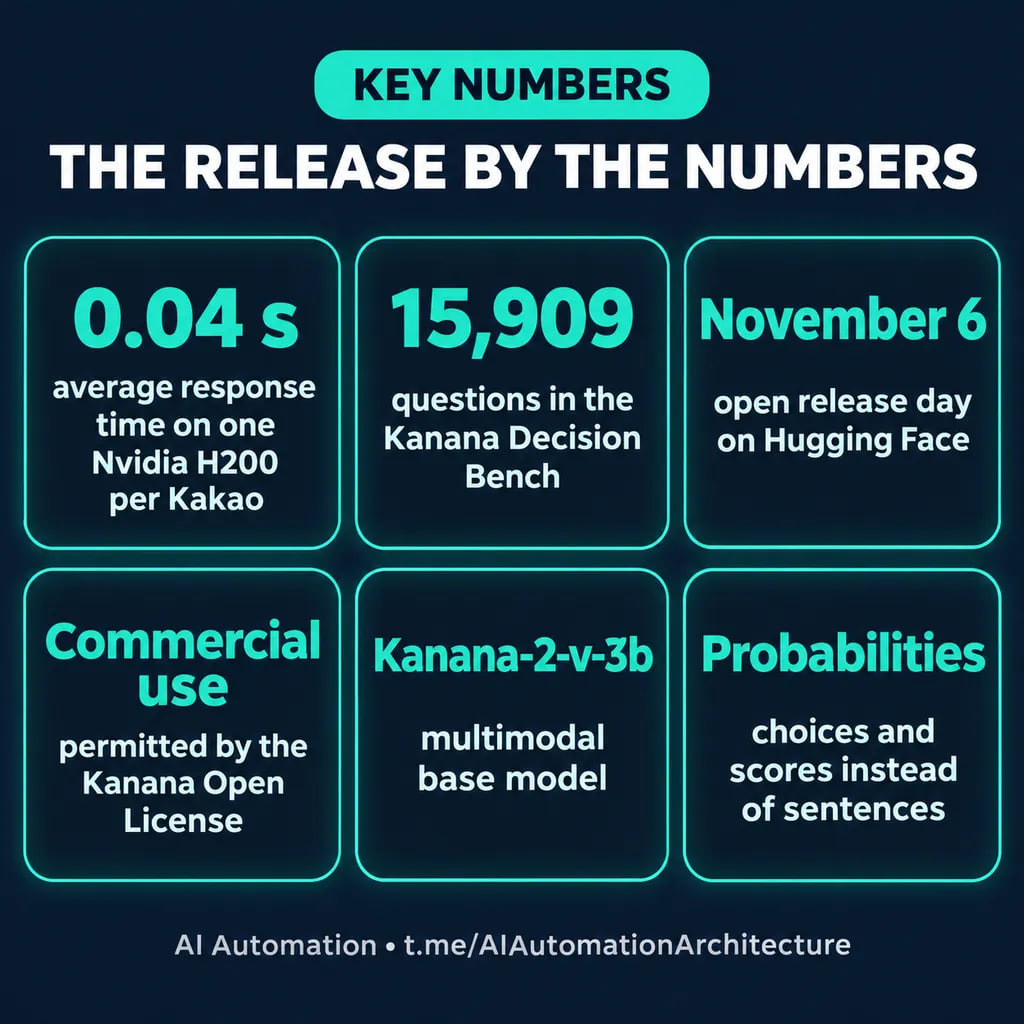
两组成绩都是厂商测量,独立验证仍待补充。尤其是中文请求、英文技术文档、代码判断等场景能否保持表现,原文没有答案。
原文还提到,Hugging Face 模型卡可以核对发布和模型信息,韩国媒体也报道了相同的速度数字。模型信息得到核对,不等于性能结论已经被独立复现。
开放商用之后,适合放进哪些环节
原文称,Kakao 于 2026 年 11 月 6 日在 Hugging Face 发布模型,标识为 kakaocorp/kanana-2-v-decide-3b-2611,采用允许商业使用的 Kanana Open License。
最直接的用途有三类:路由器把请求分给模型或工具,评分器给候选答案排序,选择器从少量选项中挑一个结果。它们都能直接消费结构化决策值。
开放商用让团队有机会把模型放进接近生产的流程里评估,但许可证允许商用,不代表部署没有成本。单张 H200 上的结果,也不能直接作为普通团队硬件上的延迟承诺。
我的判断
我认同把重复判断从语言生成中拆出来。对开发者来说,固定格式的结果更容易交给程序处理,也更适合边界明确的步骤。
不过,原文没有提供与固定规则、传统分类器,或通用模型结构化输出方案的对照数据。它证明不了这些场景都值得增加一个独立模型服务。
如果路由条件能用少量规则稳定表达,规则通常更容易检查;如果判断依赖请求里的语义,决策模型才更值得参与比较。新增服务后,还要考虑调用开销、错误处理,以及错误选择对后续任务的影响。
因此,这更像一个值得验证的组件方向。对于「放进 Agent 就能整体提速多少、成本降低多少」,原文还没有给出证据。
能拿来做什么
- 在现有 Node Agent 中挑一个高频判断步骤,例如工具选择,统计它当前的耗时和错误情况,再决定是否值得替换。
- 用自己实际处理的中文请求和技术问题建立测试集,同时比较决策模型、现有通用模型和固定规则,避免直接套用韩语榜单结论。
- 如果流程需要给多个候选答案排序,可以把评分环节单独拿出来评估,同时检查最终选出的答案质量。
- 做接入试验时,既测单次判断延迟,也测完整任务的成功率和耗时,确认局部提速能转化成实际收益。