用会话时间线找出编程Agent耗时瓶颈
session-profiler读取Claude Code和Codex的本地日志,将主会话、子Agent、工具调用及后台任务展示在统一时间线上。作者发现一次49分钟的任务中,47分钟耗在全量测试,而非模型处理或代码修改。
AI 深度解读
让 AI 编程助手合并分支、清理 worktree,最后等了 49 分钟,问题一定出在模型太慢吗?作者翻查后发现,其中 47 分钟耗在一次完整测试上,占总时间的 96%。真正的修改只占很小一段。
作者为此做了 session-profiler,把 Claude Code 和 Codex 的本地日志变成时间线。这篇最有用的地方,是提醒我们先查清时间花在哪里,再决定该改提示词、换模型,还是调整测试和构建的执行方式。
49 分钟的任务,可能被一条命令拖住
作者检查了自己最近 150 次 Claude Code 会话,观察每条提示对应的处理过程里,最长的单个步骤占了多少时间。文中列出的几个例子很直观:
- 合并分支用了 49 分钟,其中完整测试占了 47 分钟。
- 一次任务用了 35 分钟,其中后台移动端截图任务占了 33 分钟。
- 一次任务用了 31 分钟,其中「运行完整检查」占了 23 分钟。
- 另一次接近 10 分钟的任务,前台完整检查占了近 8 分钟。
在这些案例中,作者原以为需要重点关注的修改工作只用了约一两分钟,剩下的时间大多是在等命令结束。
任务耗时长,不等于模型思考得久。
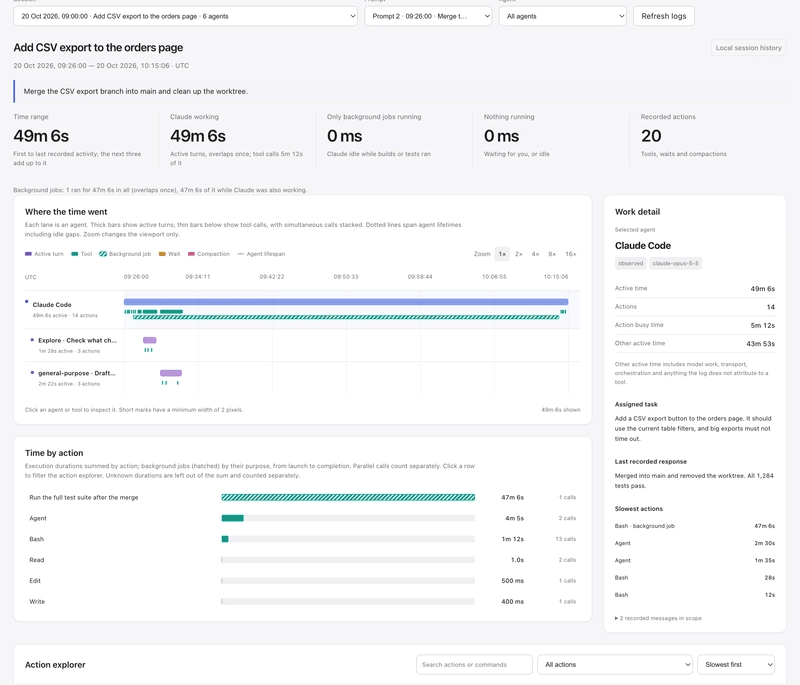
图中使用的是按作者真实耗时构造的演示会话,目的是隐藏私人提示词和路径,并非直接公开原始会话。
这也解释了作者为什么改变工作方式:迭代时先跑相关测试,收尾时再跑一次全量;必须执行长任务时,给 agent 安排其他可并行的工作;看到它迟迟没有回复,先确认后台是否还有命令在运行。
时间线要可信,先得承认日志有盲区
session-profiler 把主会话、子 agent 和侧会话放在共享时间线上,每个 agent 一条泳道。工具调用和后台任务显示为可查看具体命令的条形块,并按耗时排列最慢步骤。
它还把时间拆成三类:agent 工作、只有后台任务运行、没有任务运行。最后一类通常是在等用户,但不能一概认定如此。
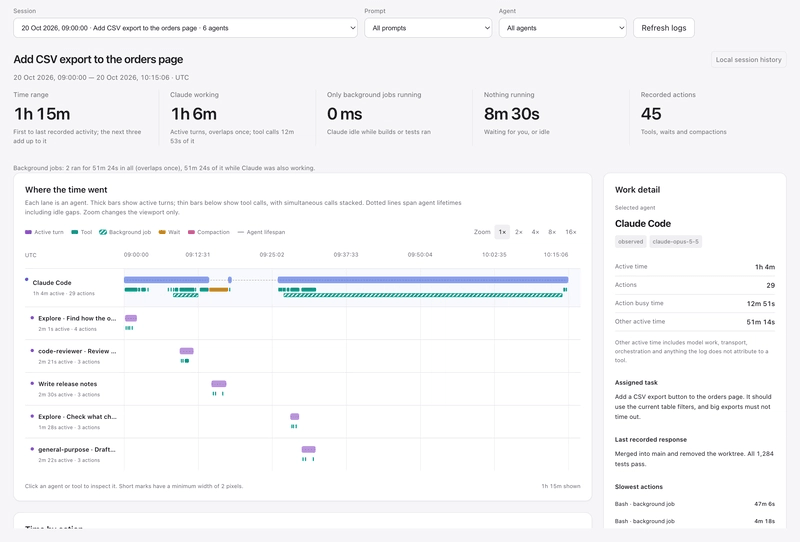
难点不是画图,而是避免把日志里的时间误当成真实执行时间。
首先,一轮对话并不全是工作。从用户发出提示到下一条提示之间,可能夹着等待回答、等待侧会话返回的空档。工具把应用注入的完成消息等事件视为唤醒信号,让此前的空档显示为等待。
其次,后台调用返回,不代表后台命令已经结束。真实结束时间要从后续完成通知里找。作者曾遇到一个被算成 75 小时的任务,实际是应用在数天后清理会话时才将它终止。现在工具会区分通知措辞:用户停止或达到时限可以算明确结束;会话结束前未完成,或者沉寂很久后无理由被清理,则标记为结束时间未知。
Codex 还有另一层问题:作者历史记录中约 64% 的命令耗时不足 1 毫秒,因为日志只记录了启动耗时。如果一个 exec 脚本只运行这一条命令,工具就用脚本调用的耗时估算;如果脚本包含多个调用,则显示耗时未知。
Claude 桌面应用的侧会话也没有在对话日志里记录父子关系,工具需要读取应用自己的会话记录来关联。记录结构变化时,就退回到分开展示。
显示「未知」,比拿启动耗时冒充执行耗时更可信。
装上以后,直接让 agent 分析当前会话
工具以插件和 skill 的形式接入。Claude Code 使用下面两条命令添加市场并安装插件:
/plugin marketplace add draconnn/session-profiler
/plugin install session-profiler@session-profiler
第二行的 session-profiler@session-profiler 是完整安装标识。
Codex 对应的安装命令如下:
codex plugin marketplace add draconnn/session-profiler
codex plugin add session-profiler@session-profiler
注意第二行使用的是 plugin add。安装后,让 agent 执行「profile this session」,它就会调用辅助程序、打开报告并解释耗时。
按原文说明,工具只读本地日志,不修改日志,不上传数据,报告通过 127.0.0.1 提供。运行要求是 Python 3.11+,没有其他依赖,支持 macOS 和 Linux,采用 MIT 许可证。
不过,它依赖的日志格式没有公开文档,应用更新可能破坏部分解析能力。作者用合成会话测试来尽早发现问题,这不能保证兼容性永远稳定。
我的判断
我认可它把排查顺序往前挪了一步:先区分模型处理、命令执行和等待,再讨论如何提速。相比只看聊天窗口,时间线能补上后台任务和并行关系;相比只查测试报告,它又能看到命令在整个会话里占了多少时间。
但 150 次会话全部来自作者个人,原文没有给出完整分布、团队对照,也没有展示调整工作方式后的整体收益。因此,「单条长命令经常主导耗时」有案例支持,不能直接推成所有团队的普遍结论。
相关测试优先也有前提。团队得知道改动影响哪些测试,长任务期间还得有真正独立的工作可做。否则,测试范围选错会漏问题,并行修改也可能让运行中的检查无法覆盖最终代码。这套做法适合用来定位浪费,不能替代项目自己的验收标准。
能拿来做什么
- 前端或 Node 项目的 agent 任务明显变慢时,先查看最慢步骤,确认瓶颈是测试、构建、截图还是等待,再决定优化哪一环。
- 在测试影响范围清楚的项目里,让 agent 迭代时执行相关测试,最终按项目要求执行完整检查,减少重复全量运行。
- 长检查启动后,只安排与其输入无冲突的独立工作,例如整理变更说明,避免修改被检查的文件。
- 阅读报告时,把「未知耗时」当作待核实项;尤其是 Codex 的多调用 exec 脚本,不要依据不足 1 毫秒的记录判断命令很快。