CMS 引用变化后,如何更新智能体知识
作者为 cognee 实现 Sanity 连接器,演示作者更名后,关联文章本身未修改时的知识同步问题。案例聚焦 CMS 文档引用关系,以及内容编辑、下架和删除后智能体知识的更新需求。
AI 深度解读
Agent 接上 CMS,最容易被忽略的不是首次导入,而是内容变化后,旧答案能不能及时失效。文章改了要更新,作者改名、文章下架、引用对象删除,也都可能影响回答。
作者为 cognee 做了一个 Sanity connector,用实测展示了两件事:同步要追踪正文背后的引用依赖;遇到空列表时,不能直接把知识库清空。对于正在给内容站、文档站接入 AI 问答的团队,这比单纯讨论检索效果更接近上线后的真实问题。
文章没改,为什么答案也该更新
作者创建了 Priya Raman,以及引用她的两篇文章:「Who owns billing」和「Q4 migration plan」。同步到 cognee 后,使用 OpenAI 作为 LLM,询问账单文章的作者,以及账单事故应该升级给谁。
首次回答是:作者为 Priya Raman,事故应在 30 分钟内升级给 Payments 值班工程师。
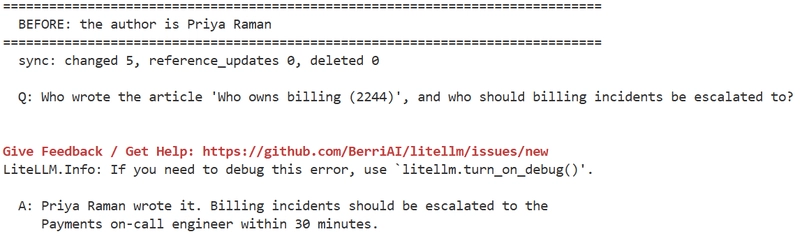
随后,作者通过 API 将姓名改成 Priya Iyer。测试项目没有部署 Studio,connector 也不依赖它。
关键在于,账单文章自身的 _rev 仍是 SfcI2UfJhIU74ahVojMxr6,_updatedAt 也没变。只检查文章自身版本或更新时间的同步器,会继续保留旧姓名。
这个 connector 额外保存了每篇文档所引用对象的版本。作者文档变化后,两篇文章重新渲染,结果显示 changed 1、reference_updates 2。再次提问,姓名更新为 Priya Iyer,事故升级规则保持原样。
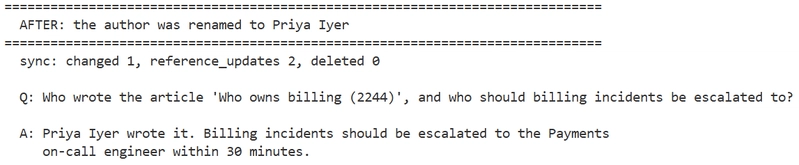
同步需要判断的是「展示内容的依赖有没有变化」。
这里的依赖不难理解:存储的是作者引用,Agent 读到的却是作者姓名。只要把引用展开成文本,被引用对象就参与了这份文本的生成。作者另一次现场检查中,一个作者改名触发了四篇文章重渲染,记录为 reference_updates: 4,与两篇文章的演示属于不同检查。
为什么放弃时间游标,改读完整 ID 列表
作者最初准备使用 _updatedAt 游标,后来放弃了。
原因来自删除同步:要知道哪些文档已经消失,同步器仍需要获取完整 ID 列表。既然列表里可以同时带上 _rev,就能用版本比较识别变化,无需另外保存时间戳,也避开了同一秒内多次写入的问题。
代价是每 1,000 篇文档需要一次列表请求。这里的「完整」指扫描标识和版本,不是每次重新拉取全部正文。作者的无变化检查显示,没有文档内容被抓取。
下面的接入代码解决首次导入与后续合并,使用只读 Viewer token 即可:
import cognee
from cognee_community_connector_sanity import sanity_source

source = sanity_source(
    project_id="abc123xy",
    dataset="production",
    document_types=["article", "author"],
    token=SANITY_TOKEN,
)
await cognee.remember(
    source,
    dataset_name="sanity_content",
    primary_key="id",
    write_disposition="merge",
    max_rows_per_table=0,
)
要关注 document_types=["article", "author"]:dataset 中还有系统和插件文档,需要明确选择同步范围。可选的 groq_filter 能进一步限定语言或站点栏目。
每篇已发布文档对应一篇 cognee 文档:普通字段变成 Field: value,Portable Text 变成段落,引用展开为名称或标题,图片使用 alt 文本和说明。connector 还会将项目已部署的 schema 合成一篇文档,让 Agent 知道所选类型及字段的含义。
作者验证了同一事务内编辑文章并新增文章,两者即使共享 _updatedAt 也能同步;未发布的草稿不影响结果;删除文章后,记录显示 deleted: 1。
查不到内容,为什么不能立刻清空知识库
作者在现场运行时发现,私有 dataset 缺少有效 token,可能返回空列表,而不是报错。类型名拼错也会得到空列表。
如果同步器把「返回为空」当作「源端全部删除」,一次配置错误就能触发全量遗忘。
因此,已有同步记录、当前却查不到任何文档时,connector 会抛错并保留原数据。确实需要接受「全部删除」的结果,可以显式使用 allow_empty_listing=True。
作者测了两种情况:将类型写成 artcle,以及把 dataset 设为私有后不提供 token。两次都被拦截,表内记录均保持 5 条。
schema 也采用类似保护。即使 dataset 公开,读取 schema 仍需要 token,因此「没读到 schema」可能只是凭证失效。要移除已同步的 schema 文档,需要关闭 include_schema。
另外,cognee.forget(dataset=...) 并不足以永久删除同步文档。dlt 保留了暂存副本,下次同步会重新带回来。作者给出的处理路径是:在 Sanity 删除或取消发布文档,或者将对应类型移出同步范围。
我的判断
我认同作者把引用更新和删除保护放在同步正确性的中心。相比只按文章更新时间增量抓取,这套做法能覆盖演示中的作者改名;相比直接相信空列表,它也给配置故障留了恢复余地。
但原文提供的是具体场景的现场验证,没有吞吐、延迟或成本的对照数据。每 1,000 篇文档一次请求只是扫描成本的一部分,不能据此判断大型站点的整体开销。
引用追踪还有边界问题:原文没说清多层引用、循环引用怎样处理,也没展示一个公共对象被大量文章引用时的重渲染成本。它同样没有比较 webhook 方案,因此不能把这次实现理解成轮询一定优于事件通知。
相关工作位于 topoteretes/cognee-community#460,对应问题为 topoteretes/cognee#4788。原文没有交代合并或发布状态,准备接入时仍要确认可用版本。
能拿来做什么
- 给 Sanity 内容站接 AI 问答时,先列出最终文本依赖的作者、栏目等引用对象,再验证这些对象变化后,相关文章是否会更新。
- 给同步任务补上作者改名、同秒编辑与新增、删除、未发布草稿这几类检查,不要只验证首次导入成功。
- 将空结果作为需要核查的异常,分别检查 token、dataset 和
document_types,确认源端确实清空后,再显式放开空列表同步。 - 排查「删除后又出现」时,同时检查 Sanity、cognee 和 dlt 暂存副本,按源端删除或取消发布的路径处理。