OpenAI 安全会话训练政策引争议
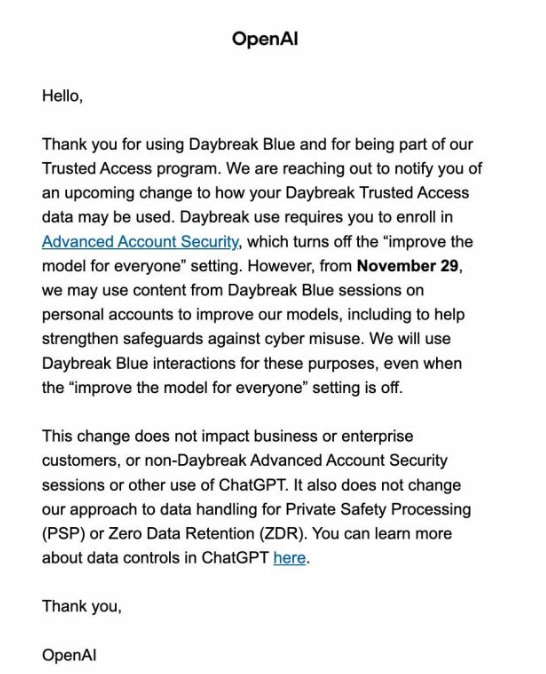
据报道,OpenAI 计划自 11 月 29 日起使用 Daybreak Blue 会话数据训练模型,即使用户已关闭训练设置。遭到反对后,后续邮件承诺提供单独的退出选项。
AI 深度解读
OpenAI 准备从 11 月 29 日起,将此前排除在训练范围外的 Daybreak Blue 会话数据用于模型训练。消息通过邮件告知 Trusted Access 项目成员,引发反弹后,OpenAI 又承诺提供单独的退出选项。
这则消息的重点,是敏感会话的数据用途发生了变化。对使用 AI 处理安全研究或未公开成果的程序员来说,值得弄清三个问题:原来的设置是否足够、退出训练覆盖哪些用途,以及报道中的争议究竟证明了什么。
原来不参与训练的数据,为什么又要检查设置
据 The Decoder 报道,Daybreak Blue 会话数据此前不用于训练。OpenAI 发给 Trusted Access 成员的邮件改变了这一安排:从 11 月 29 日开始,这些会话数据将被用于训练模型。原文没有注明年份。
报道还提到了「improve the model for everyone」设置,强调关闭该设置的用户也受到此次变更影响。用户反弹后,OpenAI 发出第二封邮件,承诺提供单独的退出选项。
曾经被排除在训练之外,不代表后续政策会自动维持原样。
但这里仍有信息缺口。原文没有交代新退出选项的位置、具体操作方式,也没有说明变更是否涉及此前已经产生的会话。因此,目前能确认的是数据使用政策将调整,不能据此断言历史数据已经被拿去训练。
退出模型训练,是否就排除了所有用途
报道明确保留了一项例外:在安全审查中被标记的交互,仍然可以用于安全目的。
这需要和模型训练分开理解。退出选项针对的是某类数据用途,而「安全目的」是报道另外列出的用途。原文没有进一步说明,安全用途具体包含哪些处理,也没有解释它与安全相关训练之间的边界。
所以,不能把「退出训练」直接理解成「服务方不再以任何方式使用这些内容」。同样,也不能反过来认定安全例外必然会把退出的数据重新用于训练。报道给出的信息不足以支持这两种结论。
对涉及敏感材料的工作,真正需要确认的是:退出机制覆盖什么、保留什么,以及规则如何执行。一个开关的名称回答不了全部问题。
数学家案例说明了风险,还是证明了训练行为
报道用 Buckmaster-Alpöge 案例解释研究者的担忧。
数学家 Tristan Buckmaster 和 Levent Alpöge 曾把 Navier-Stokes 方程相关的证明草稿上传到 OpenAI 的 Codex。此后,OpenAI 展示了自己的证明,但否认使用他们提交的内容进行训练。
这里必须保留证据边界:报道没有提供能够确认训练数据来源的证据,也没有给出证明内容的详细对比。事件先后发生,不能单凭这一点建立因果关系。
这个案例呈现的是研究者的信任疑虑,并未证实 OpenAI 使用了他们的草稿训练模型。
不过,这种疑虑有现实影响。研究成果尚未公开时,提交者很难仅凭最终输出判断,自己的材料是否影响了模型。Daybreak Blue 的政策变化,又让原先的数据使用预期需要重新核对。
我的判断
这则报道最有价值的提醒,是把「过去的承诺」和「当前适用的规则」分开看。对于安全研究会话,用户可能正是依据此前不参与训练的安排,决定提交哪些材料。调整用途,即使随后增加退出选项,也会增加用户重新核查的成本。
但原文很短,没有说明政策调整的理由、退出机制的完整条款,也没有提供实际执行结果。它不足以证明退出机制无效,更不足以坐实数学家案例中的训练指控。
和只检查一个通用设置相比,按产品、项目分别确认数据用途更稳妥,只是操作成本更高。现有信息也无法支持「所有 Codex 会话都会采用同样政策」这样的外推。
能拿来做什么
- 如果你是 Trusted Access 成员并使用 Daybreak Blue,应在报道所述的 11 月 29 日变更前核对相关邮件,确认单独退出选项的适用范围,不要只依赖「improve the model for everyone」设置。
- 如果团队用 AI 协助安全研究,应重新检查准备提交的漏洞细节、内部材料和未公开成果,依据当前数据政策决定提交范围。
- 如果你使用 Codex 处理未公开研究或技术方案,可以把数学家案例作为核查数据条款的提醒,但不要把未经证实的训练指控当成事实传播。